Tři měsíce na LUMI: správnou odpověď AI často má. Jen ji neumí vybrat.
Tři měsíce a 4 703 GPU hodin na finském superpočítači. Kdy pomůže spolupráce modelů, co dokázalo dotrénování ThinkingCapu a proč je často těžší správnou odpověď vybrat než vygenerovat. Výsledky, grafy i datasety pro vlastní ověření.

Můj projekt Fusion Playground na finském superpočítači LUMI se blíží ke konci. Za tři měsíce jsem využil 4 703 z přidělených 5 000 GPU hodin, provedl přes dvacet experimentů a shromáždil přes 305 tisíc ohodnocených odpovědí. Na výzkumu a vývoji pracuji prakticky sám, s podporou českého týmu LUMI AI Factory v IT4Innovations.
V červenci jsem přijel s jednoduchou otázkou: Kdy je několik spolupracujících AI modelů lepších než jeden silný model? A kolik to stojí?
Nejzajímavější odpověď nakonec nebyla o velikosti modelů. Na těžkých vědeckých otázkách měla Gemma mezi osmi vlastními pokusy správnou odpověď v 95,5 % případů. Hlasováním ji ale vybrala jen přibližně v 86 %. Správné řešení tedy často existovalo. Jen se cestou k uživateli ztratilo.
Co si odnáším z LUMI
- Více odpovědí samo o sobě nestačí. Největší nevyužitou rezervou byl v tomto experimentu výběr správné odpovědi.
- Jeden dobrý a stručně přemýšlející model je silný soupeř. Gemma-4-31B dosáhla v hlavním srovnání kvality 91,3 % a na nové sadě 91,4 %. Testované poroty a routery ji v průměru nepřekonaly.
- Spolupráce má smysl tam, kde pro ni máme dobrý důvod. U programování pomohly testy, u některých matematických úloh opakované pokusy. Univerzální recept z toho ale nevznikl.
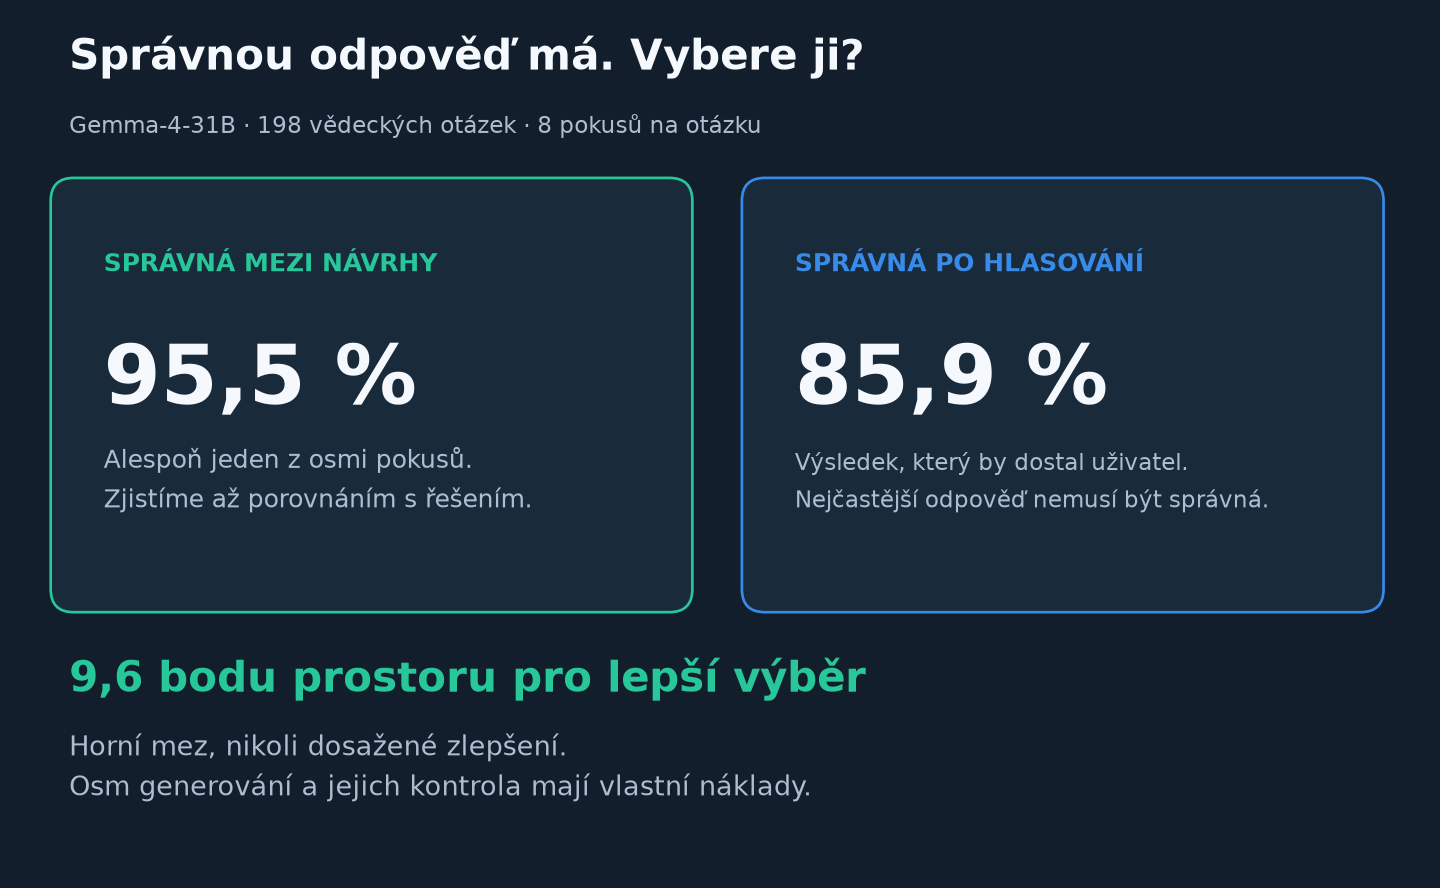
Stejných osm pokusů Gemmy-4-31B na 198 otázkách GPQA. Levé číslo lze zjistit díky známým správným odpovědím. Není to přesnost systému, který bych dnes mohl nasadit.
AI odpoví osmkrát. Které odpovědi věřit?
Představte si poradu, na které někdo vysloví správné řešení, ale většina se přikloní k jinému. Právě něco takového se dělo v mých pokusech. Další generování ještě neznamená lepší rozhodnutí.
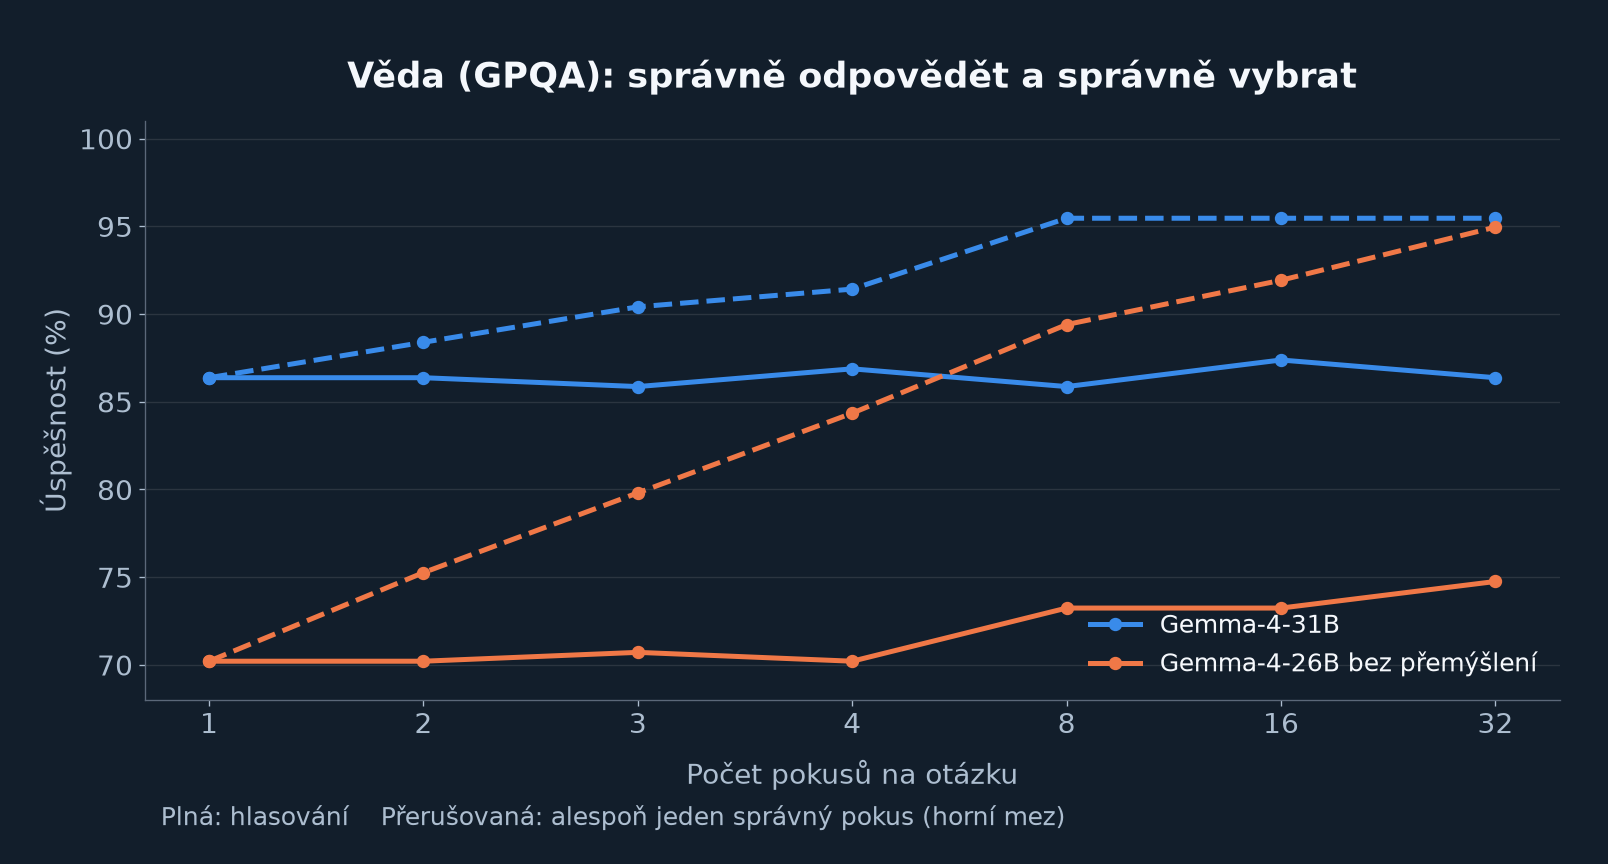
Plné čáry: skutečný výsledek hlasování. Přerušované: alespoň jedna správná odpověď mezi pokusy. Tato horní mez využívá znalost řešení. Ani 32 pokusů nezvedlo hlasování Gemmy-4-31B nad 86,4 %.
Říkám tomu zeď selektoru. Kdybych uměl mezi osmi návrhy spolehlivě vybrat, získal bych skoro deset procentních bodů bez nového základního modelu. Ne ovšem zdarma: osm generování i jejich kontrola něco stojí.
Nechat rozhodnout další AI je přirozený nápad. V samostatném testu dodržování pokynů IFEval se ale zkoušení AI soudci oproti kontrole pravidly mýlili ve 20 až 25 % případů. Při opakování navíc měnili názor na stejnou odpověď v 9 až 25 % případů. To není důkaz, že AI soudci nemají budoucnost. Je to důvod nevěřit bez měření zrovna těmto soudcům a tomuto nastavení. Čísla také nelze automaticky přenést na vědecké otázky GPQA.
Nejlépe mi fungovala kontrola, která má pevnou oporu: spustit testy programu, přepočítat výsledek, zkontrolovat pravidla formátu. Modelový odhad „tohle vypadá správně“ je jiný druh důkazu.
Co vlastně znamená spolupráce modelů
V Hyperprostoru vyvíjím HyperFusion, spolupráci několika modelů, a Atlas, který podle zadání vybírá vhodný postup. Pro čtení výsledků je užitečné rozlišit čtyři věci:
| Postup | Co se děje |
|---|---|
| Hlasování | Model odpoví opakovaně, případně hlasuje několik modelů. Vyhraje nejčastější odpověď. |
| Výběr | Z hotových návrhů se vybere jeden, třeba podle testů. |
| Kaskáda | Nejdřív odpoví levnější model. Pokud kontrola nestačí nebo selže, nastoupí silnější. |
| Syntéza | Další model z návrhů vytvoří novou společnou odpověď. |
Výsledky jednoho postupu nejsou automaticky výsledky ostatních. Ve finálním experimentu jsem skutečnou syntézu měřil na dodržování pokynů a otázkách nad dokumenty. U dalších úloh šlo převážně o hlasování, výběr nebo kaskádu. U kódu se pro výběr používaly veřejné testy a pro závěrečné hodnocení oddělené skryté testy.
Hyperprostor pracuje také s velkými hostovanými modely, které mají jiné ceny a vlastnosti. Z měření otevřených modelů na LUMI proto nevyvozuji univerzální verdikt o jeho produkční fúzi.
Jeden silný model se překonává těžko
Závěrečné srovnání zahrnulo jedenáct konfigurací modelů a patnáct druhů úloh. Vedle vědeckých otázek a matematiky také programování, práci s textem, dodržování pokynů nebo českou maturitu. V hlavní matici byly obvykle čtyři až osm pokusů na úlohu; některé navazující testy měly více opakování.
Router je dispečer, který podle zadání vybírá model nebo postup. Jeho původní pravidla a naučené varianty jsem porovnal s jednoduchou strategií: vždy použít stejný model.
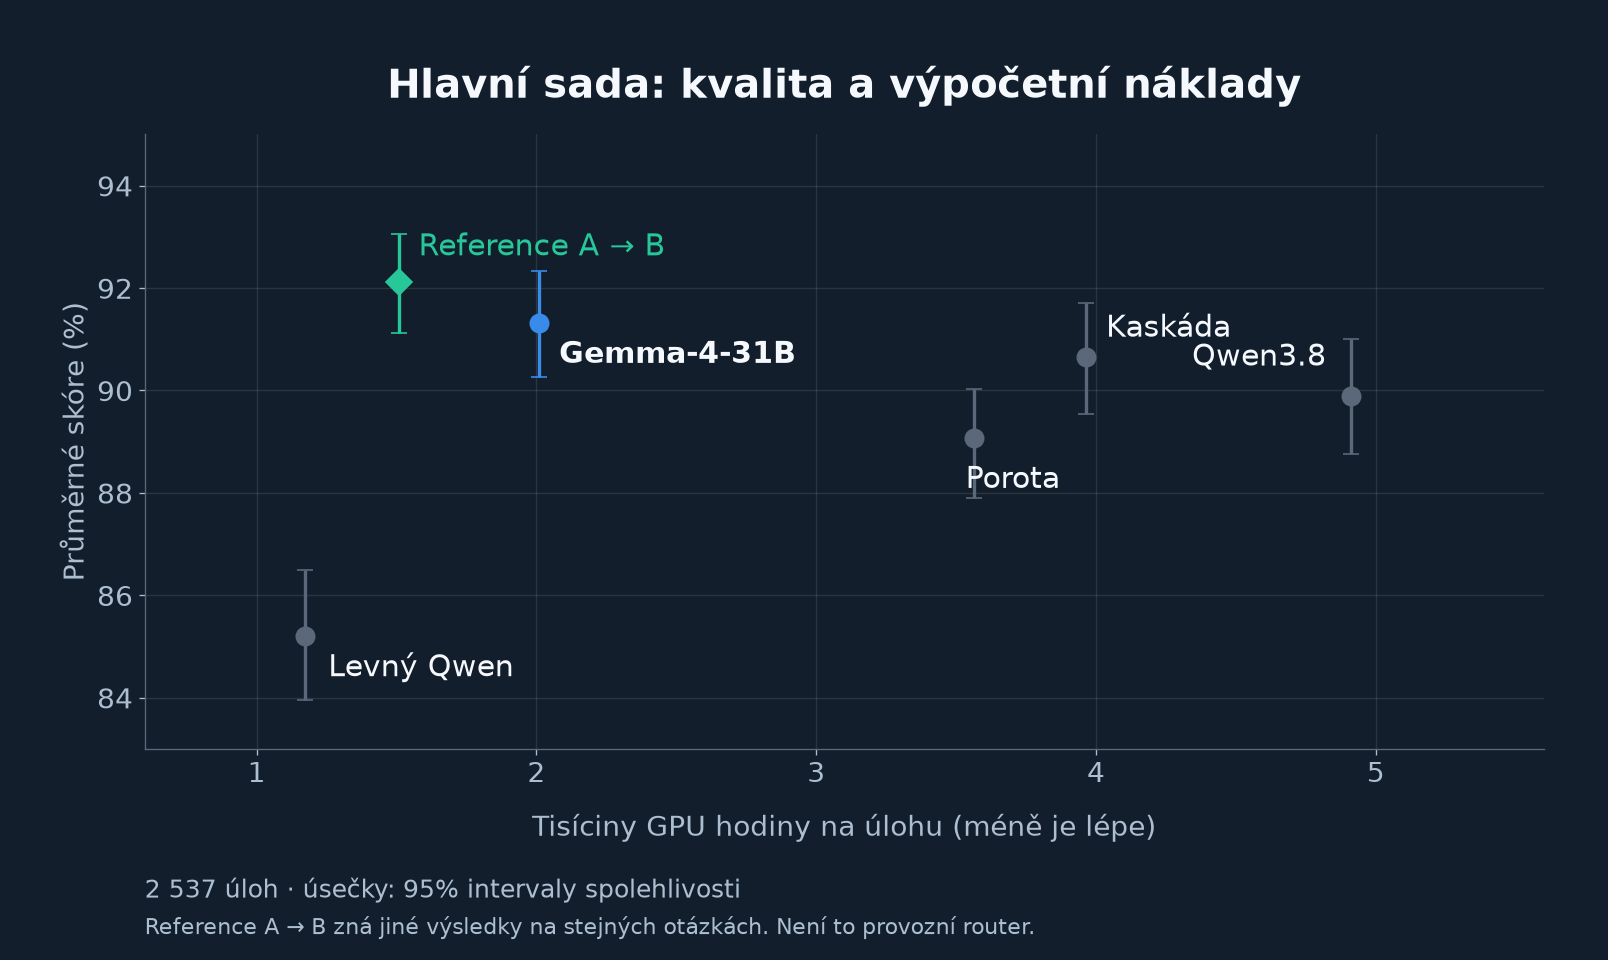
Lépe je nahoře vlevo. Referenční výběr A → B zná výsledky jiných pokusů na stejných otázkách, takže není nasaditelným routerem. Optimistické vybírání podle samotných hodnocených výsledků tu nezobrazuji.
| Postup | Hlavní sada | Nové druhy úloh | Cena hlavní / nové* |
|---|---|---|---|
| Qwen3.6-35B-A3B bez přemýšlení | 85,2 % | 88,7 % | 1,17 / 0,71 |
| Qwen3.8-27B s přemýšlením | 89,9 % | 89,9 % | 4,91 / 3,44 |
| Gemma-4-31B s přemýšlením | 91,3 % | 91,4 % | 2,01 / 1,62 |
| Porota tří modelů | 89,1 % | 88,5 % | 3,56 / 1,30 |
| Kaskáda | 90,7 % | 90,1 % | 3,96 / 1,96 |
| Naučené routery | 90,2 až 91,3 % | 90,3 až 91,4 % | podle nastavení |
| Referenční výběr A → B | 92,1 % | 92,8 % | 1,51 / 0,96 |
Tisíciny GPU hodiny na úlohu. Jde o průměrné skóre na konkrétní směsi úloh, nikoli univerzální pořadí modelů. GPU hodina zde znamená hodinu práce jednoho modulu AMD MI250X.
Gemma byla silná a přitom přemýšlela stručně. V hlavní sadě stál levnější Qwen jen asi 1,7krát méně, ale zaostával o šest bodů. Router tak měl malý prostor pro chybu. S jinou dvojicí modelů a jinými cenami může být situace výrazně příznivější.
Nakolik těm číslům věřit
Hlavní sada obsahovala 2 544 jedinečných úloh, z nichž do přísného porovnání se všemi potřebnými odpověďmi vstoupilo 2 537. Nová sada přidala 1 455 úloh šesti dalších druhů. Router byl uzamčený před otevřením jejich výsledků. Výběr postupů a vyhodnocení navíc používaly oddělená opakování; u učení routerů se oddělovaly i samotné otázky.
Ne každá desetina bodu znamená zlepšení. Například 91,3 % pro Gemmu má v hlavní analýze 95% interval spolehlivosti přibližně 90,3 až 92,3 %. Malé rozdíly proto popisuji jako pozorované výsledky, ne jako prokázanou převahu. Opakované odpovědi na tutéž otázku také nejsou nezávislé nové otázky.
Pozdější pokusy s dalšími recepty a ověřovači už používaly i dříve otevřená data. Jsou užitečné pro hledání dalšího směru, ale potřebují další samostatný test. To platí zejména pro úspory s JEV níže.
Kdy se více pokusů opravdu vyplatilo
| Situace | Co fungovalo | Pozorovaný výsledek |
|---|---|---|
| Programování s testy | Levný model, kontrola, případně silný model | Srovnatelná kvalita za přibližně polovinu GPU času: 85,2 % za 3,0 proti 84,8 % za 5,6 tisíciny GPU hodiny |
| Programování s důrazem na kvalitu | Opakovat silný model a kontrolovat testy | Přibližně +1,4 až +1,9 bodu za o 17 až 40 % vyšší cenu |
| Olympijská matematika | Hlasování více pokusů nebo vhodná porota | V jednom srovnání +3,4 bodu za 2,2násobnou cenu |
| Odborné vědecké otázky | Různé modely nebo kaskáda | Přibližně +1,3 až +2,0 bodu, za dvojnásobnou až šestinásobnou cenu |
| Vyhledání a výpočet z textu | Levný model bez dlouhého přemýšlení | Podobná nebo lepší kvalita, třikrát až sedmkrát levněji |
U matematiky mě překvapilo, jak moc záleží na charakteru chyb. Menší Gemma bez přemýšlení se opakovanými pokusy výrazně zlepšovala. Silnější Gemma-4-31B téměř ne. Hlasování pomáhá, když se pokusy užitečně liší. Opakovanou stejnou chybu většina neodhlasuje pryč.
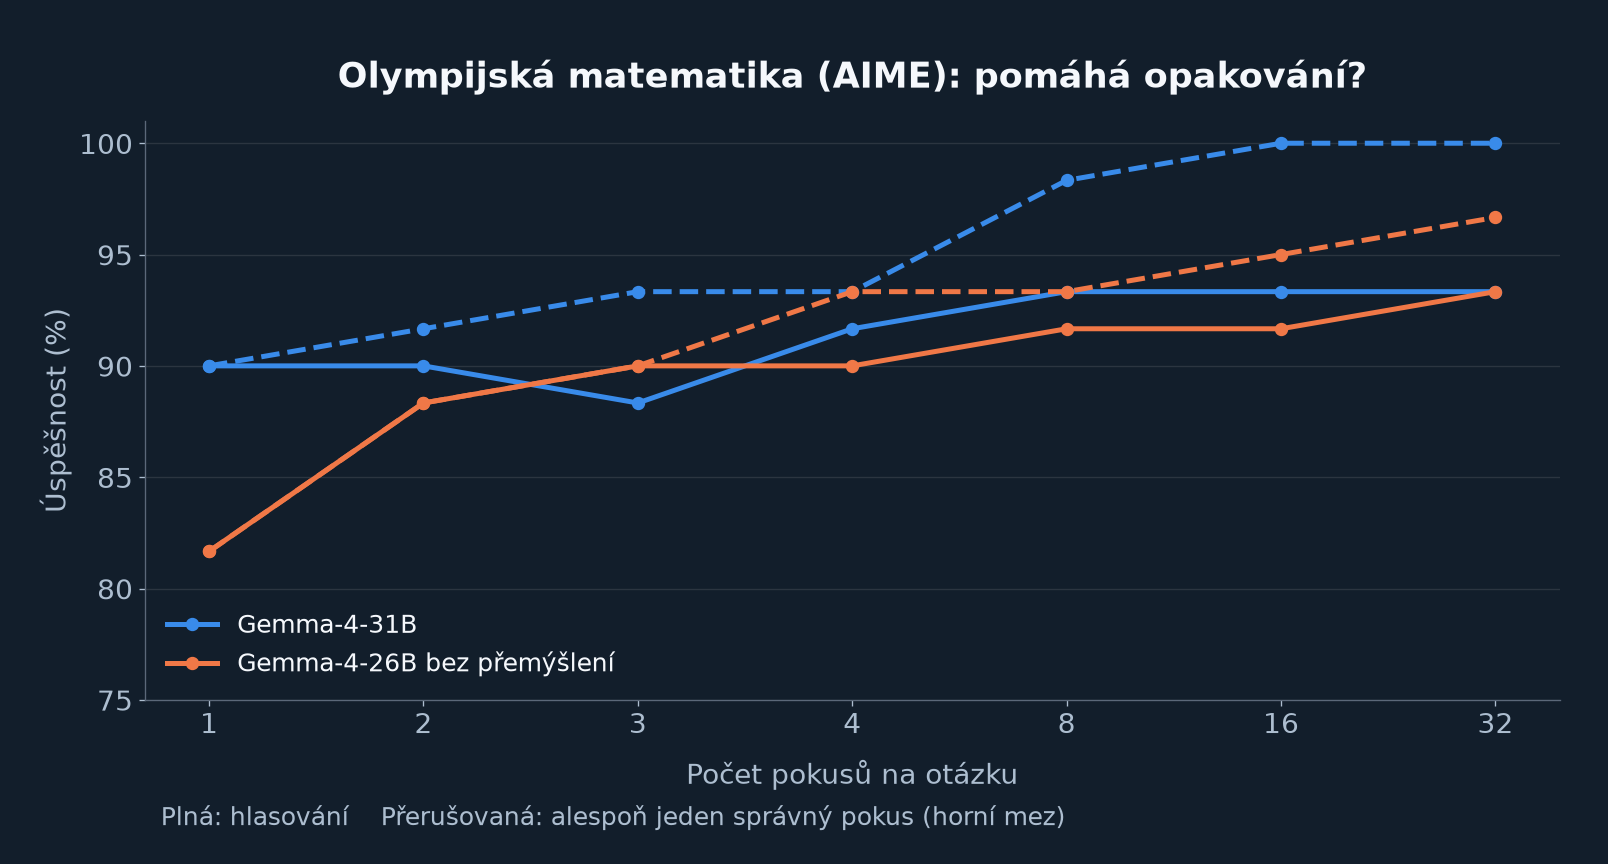
AIME obsahuje 60 olympijských úloh. Plná čára je hlasování, přerušovaná znamená alespoň jeden správný pokus. Malý počet otázek je další důvod nepřeceňovat drobné rozdíly.
ThinkingCap: lepší matematika za 30 GPU hodin
Jeden z nejhezčích výsledků přišel při dotrénování ThinkingCap-Qwen3.6-27B od BottleCap AI, firmy Tomáše Mikolova. Model už sám míří na stručné přemýšlení. Chtěl jsem zjistit, zda ho dokážu posunout ještě dál.
U varianty zobrazené v grafu jsem použil 1 400 matematických příkladů a 469 vlastních odpovědí původního modelu z vědy a programování. U jednodušší matematiky jsem vybíral krátká správná řešení, u obtížnějších příkladů delší. Původní odpovědi měly pomoci uchovat ostatní schopnosti. Jeden tento trénink zabral přibližně 30 GPU hodin. Celá série pokusů a vyhodnocování stála více.
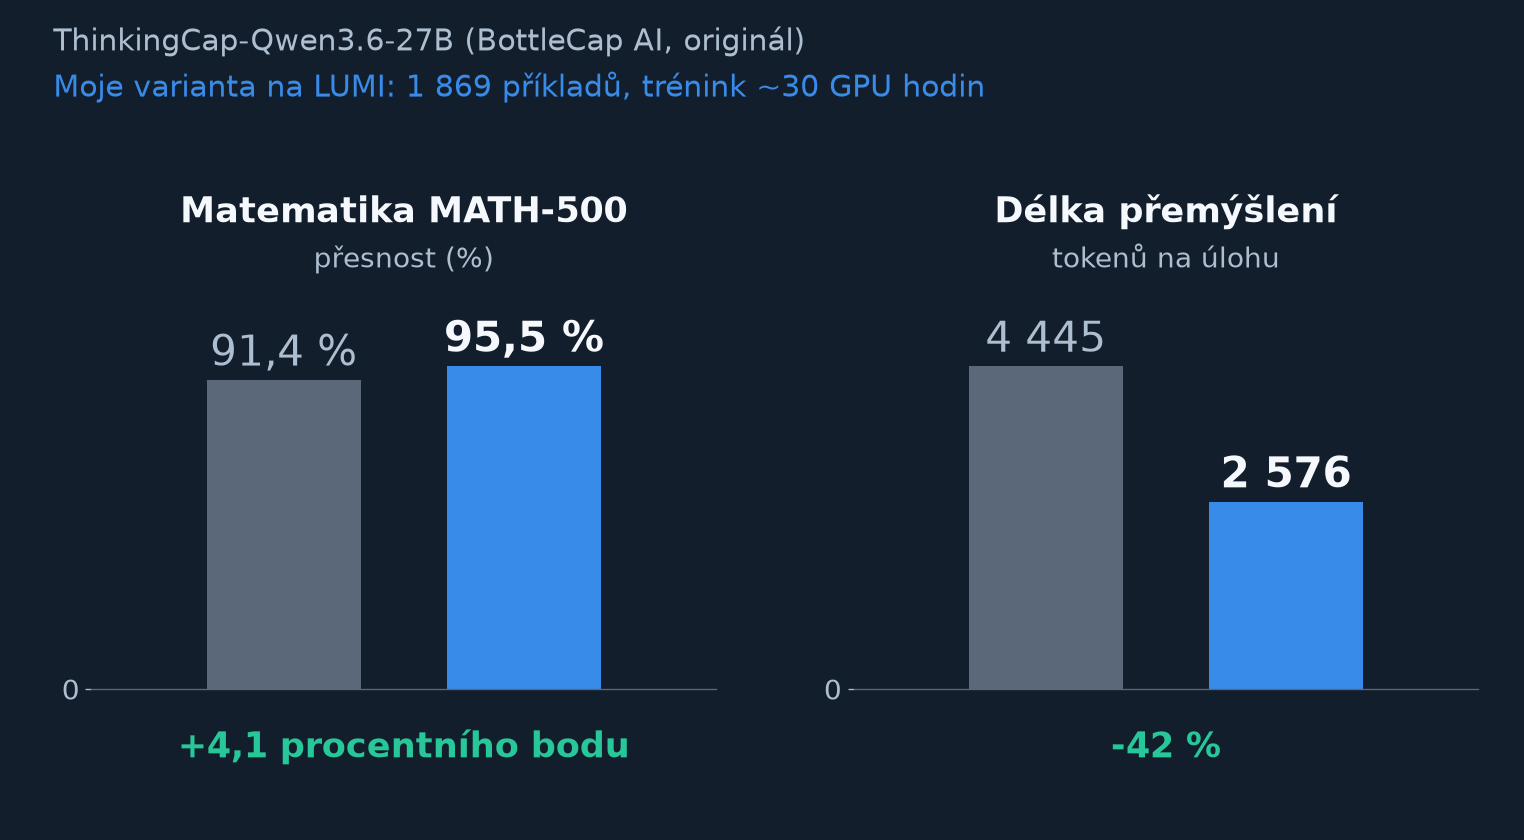
MATH-500: 500 otázek, každá třikrát, tedy 1 500 pokusů na variantu. Stejná dotrénovaná varianta získala 4,1 procentního bodu a zkrátila přemýšlení o 42 %.
Přesnější a současně stručnější než výchozí ThinkingCap. Pro konkrétní matematickou sadu je to velmi pěkný výsledek za malý tréninkový rozpočet.
Má ale svou cenu: stejná varianta klesla na olympijské matematice AIME o 3,3 bodu a na vědeckých otázkách GPQA o 5,6 bodu. Jiný z pěti receptů ztrácel na vědě méně, jenže to byl jiný model. Jejich nejlepší čísla nelze sloučit do jednoho vítěze. Zlepšil jsem konkrétní matematickou schopnost, nepřekonal ThinkingCap ve všem.
Před tréninkem jsem kontroloval přesné i blízké textové překryvy s testy MATH-500, AIME a GPQA; použitá kontrola žádné nenašla. Neznamená to úplnou záruku, že se podobné úlohy nevyskytly v původním předtrénování. A jde o verzi založenou na Qwen3.6: BottleCap mezitím vydal novější ThinkingCap-Qwen3.8, proti kterému tento výsledek neměřím.
Lepší kontrolor místo většího modelu?
Atlas používá rychlý specializovaný model JEV od TypeSafe k odhadu vlastností zadání. Zkusil jsem ho také jako kontrolora už hotové odpovědi. V těchto navazujících pokusech to fungovalo lépe než samotný odhad obtížnosti otázky.
| Signál pro rozhodnutí, kdy stačí levný model | AUC | Kvalita při přibližně polovičním GPU čase oproti Gemmě |
|---|---|---|
| Původní otázky JEV na vlastnosti zadání | 0,77 | 88,8 % |
| Nové otázky JEV na obtížnost | 0,79 | 89,3 % |
| Vlastnosti textu bez JEV | 0,61 | 88,3 % |
| Kontrola odpovědi pomocí Gemmy-4-31B | 0,77 | 89,4 % |
| Kontrola odpovědi pomocí Qwen3.6 | 0,82 | 88,8 % |
| Kontrola odpovědi pomocí JEV | 0,84 | 89,8 % |
AUC popisuje, jak dobře signál řadí případy podle rizika chyby. Hodnota 0,5 odpovídá náhodnému pořadí, 1 dokonalému. AUC 0,84 neznamená 84% přesnost odpovědí.
V tomto nastavení šlo ušetřit přibližně 30 % GPU času za půl bodu kvality, nebo polovinu za bod a půl. Jde o body vybrané z naměřené křivky na už použitých datech, nikoli o hotovou záruku pro nové zákaznické dotazy. API volání JEV stálo navíc asi 0,00005 dolaru na úlohu; tato částka není zahrnutá do GPU hodin.
JEV je stále model, který může chybovat. Není to ekvivalent spustitelného testu. Také ostatní kontrolory jsem zkoušel v konkrétním úsporném nastavení, ne ve všech možných podobách. Přesto je to pro další práci slibnější vodítko než pouhý dojem z obtížnosti zadání.
Nová generace někdy udělá víc než další miliardy parametrů
Během tří měsíců se změnily i samotné modely. Qwen3.8-27B proti stejně velkému Qwen3.6-27B získal v těchto testech zhruba 13 bodů na olympijské matematice a 18 na programování. Zároveň na těchto úlohách spotřeboval přibližně polovinu GPU času.
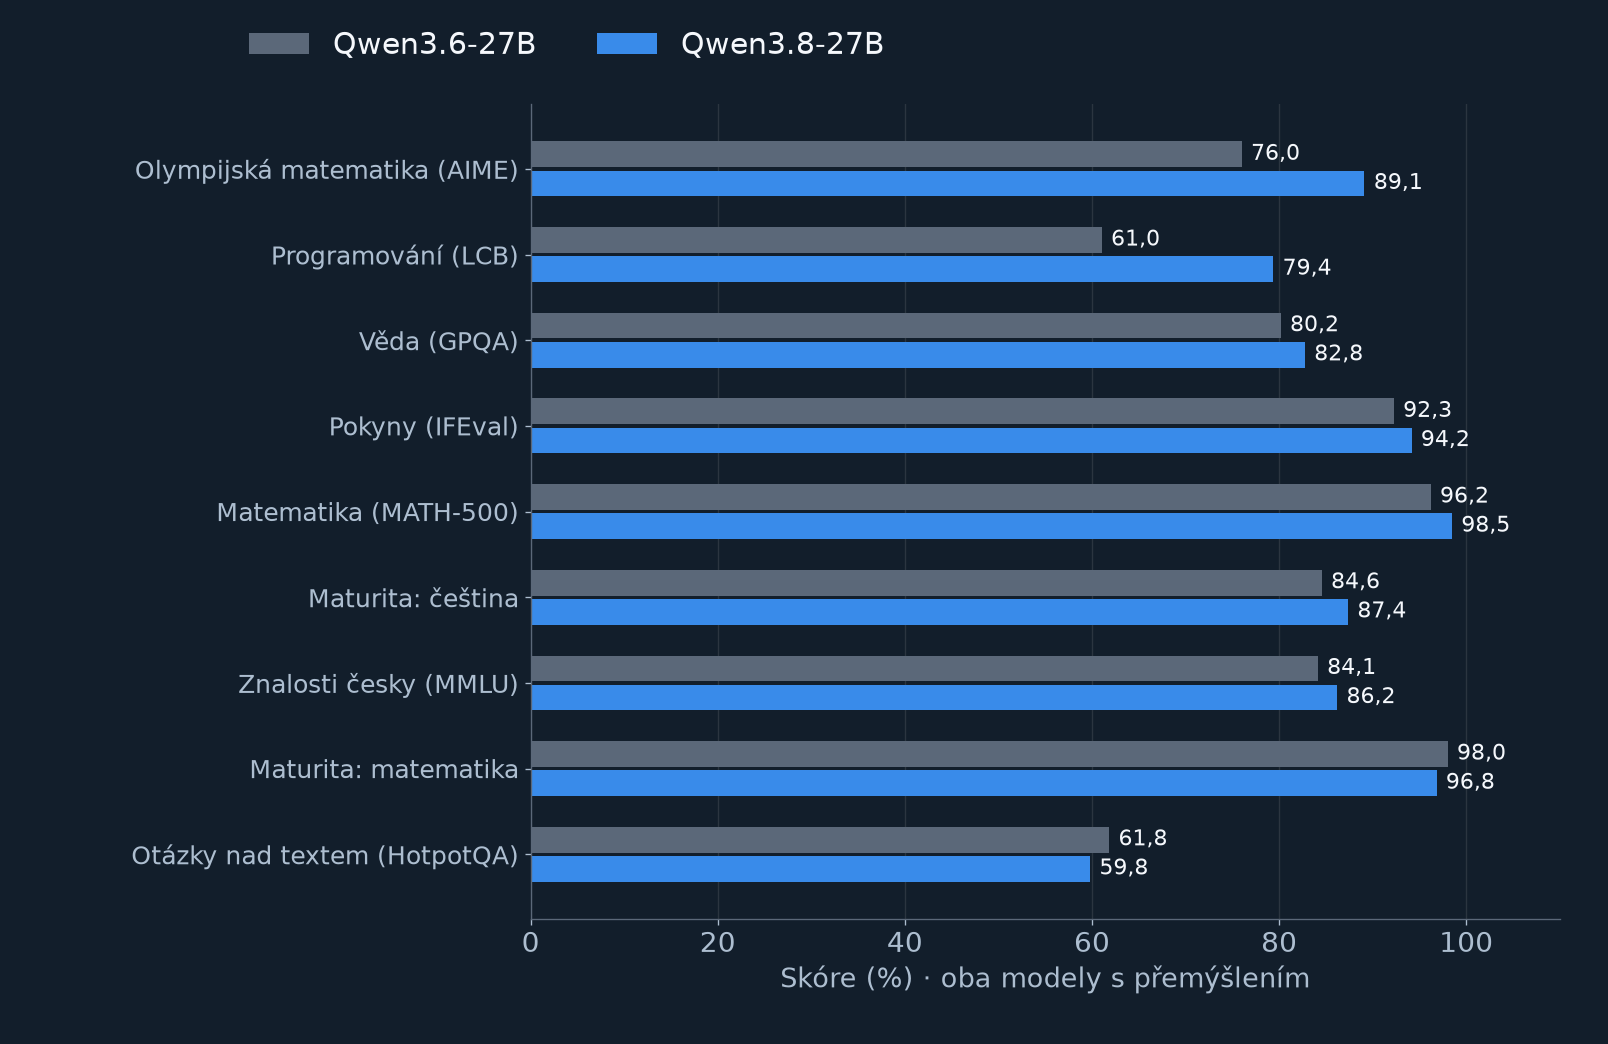
Oba modely s přemýšlením. Zlepšení není plošné: na některých úlohách s textem a českou matematikou novější model mírně ztratil. Modely má smysl průběžně měřit na vlastních úlohách.
Opačné překvapení přinesl MiMo-V2.6-Pro s přibližně bilionem parametrů, největší model ve finálním srovnání. Na jeden uzel se vešel v komprimované podobě s průměrně 3,5 bitu na parametr.
| MiMo-V2.6-Pro, 3,5 bitu | Gemma-4-31B | |
|---|---|---|
| Vědecké otázky GPQA | 78,3 % | 85,9 % |
| Česká maturita | 92,2 % | 91,0 % |
| GPU hodiny na otázku GPQA | přibližně 0,52 | přibližně 0,005 |
MiMo se na české maturitě dařilo, ale na GPQA byl výrazně dražší a méně přesný. U pětiny těžkých otázek narazil na limit délky odpovědi. Přesnější varianta MXFP4 měla na 64 společně dokončených otázkách o 4,7 bodu více a žádnou uříznutou odpověď. Je to zajímavá stopa, ale také malý, vybraný vzorek.
Příčinou může být komprese, kvalita konkrétní verze modelu, způsob jeho spuštění i nastavení limitů. MiMo běžel přes llama.cpp, Gemma přes vLLM. Navíc MiMo používá architekturu MoE, která pro každý token aktivuje jen část parametrů. Tohle není čistý experiment „bilion proti 31 miliardám“ a není z něj možné odsoudit model jako takový.
Podobně opatrně čtu i letní srovnání přes placená API:
| Malý srovnávací test | Přes API | Na LUMI |
|---|---|---|
| GPQA, 138 otázek | Gemini 3.1 Pro 93,5 %, Claude Sonnet 5 86,2 % | Gemma-4-31B 84,1 % |
| GLM-5.2, skórovaná otevřená úloha | 60 bodů z 60 | 4bitová verze: 35 bodů z 60 |
| Kimi K3, 40 programovacích úloh | 31 správně | 2bitová verze: 28 správně |
Poslední řádek znamená asi 90 % relativního výsledku v tomto testu, nikoli zachování 90 % všech schopností Kimi. Rozdíly mezi API a lokální verzí také samy o sobě neizolují vliv kvantizace, tedy komprese číselných vah modelu. Ta může fungovat dobře, ale každý konkrétní soubor a způsob spuštění je potřeba prověřit.
Dvě zjištění, která by byla škoda zapomenout
Dlouhé dokumenty prověří jinou schopnost než krátký benchmark. V testu otázek nad dokumenty jsem přidával rušivý text a prodloužil kontext přibližně z 8 na 120 tisíc tokenů. Testované Qweny ztratily zhruba 2 až 5 bodů skóre F1, gpt-oss asi 18. Nejde o verdikt nad všemi dlouhými dokumenty, ale dobře to ukazuje, proč velikost kontextového okna nestačí jako měřítko kvality.
Záleží, kdo hodnotí. V dřívějším pokusu se shrnováním vycházela syntéza jako vítěz v 92,7 % porovnání, když ji hodnotil stejný model, který ji vytvářel. S nezávislým hodnotitelem Llama to bylo 57,3 %. Změnil se hodnotitel, takže nejde o přesné změření jediné příčiny. Rozdíl ale stačí jako varování před tím, aby model sám sobě vystavoval vysvědčení.
Jak to zapadá do dalšího výzkumu
Moje pokusy nejsou první práce o spolupráci modelů. Pomáhají mi zasadit obecné nápady do konkrétních nákladů a omezení na LUMI:
- Self-Consistency ukazuje přínos více cest k řešení a hlasování. Moje výsledky připomínají, že záleží i na tom, jak podobné chyby pokusy dělají.
- Mixture-of-Agents zkoumá syntézu odpovědí několika modelů. To je odlišný postup od samotného hlasování.
- RouteLLM řeší volbu modelu podle poměru kvality a ceny. Výsledek takového routeru vždy závisí i na tom, mezi kterými modely vybírá.
- Let's Verify Step by Step trénuje kontrolu jednotlivých kroků řešení. Moje data většinou hodnotí až výslednou odpověď, takže pro podobný přístup by bylo potřeba doplnit jiný druh anotací.
- Quantization Inflates Reasoning popisuje, že komprese může prodloužit přemýšlení. Je to možné vysvětlení části mých pozorování, ne důkaz příčiny u konkrétního běhu MiMo.
Co jsem se naučil o samotném superpočítači
Ve finále běželo souběžně až 140 výpočetních úloh ve frontovacím systému. Každá zpracovávala mnoho dotazů. Díky tomuto souběhu se přibližně 2 900 GPU hodin vešlo do jednoho dne a noci; neznamená to, že tak dlouho čekal jeden uživatel na odpověď.
Velký rozdíl udělalo rozdělení práce. Jeden uzel LUMI má čtyři moduly MI250X, dohromady osm výpočetních čipů GCD. Pro model, který se vejde na dva čipy, jsem mohl místo jedné kopie přes osm čipů pustit čtyři samostatné kopie.
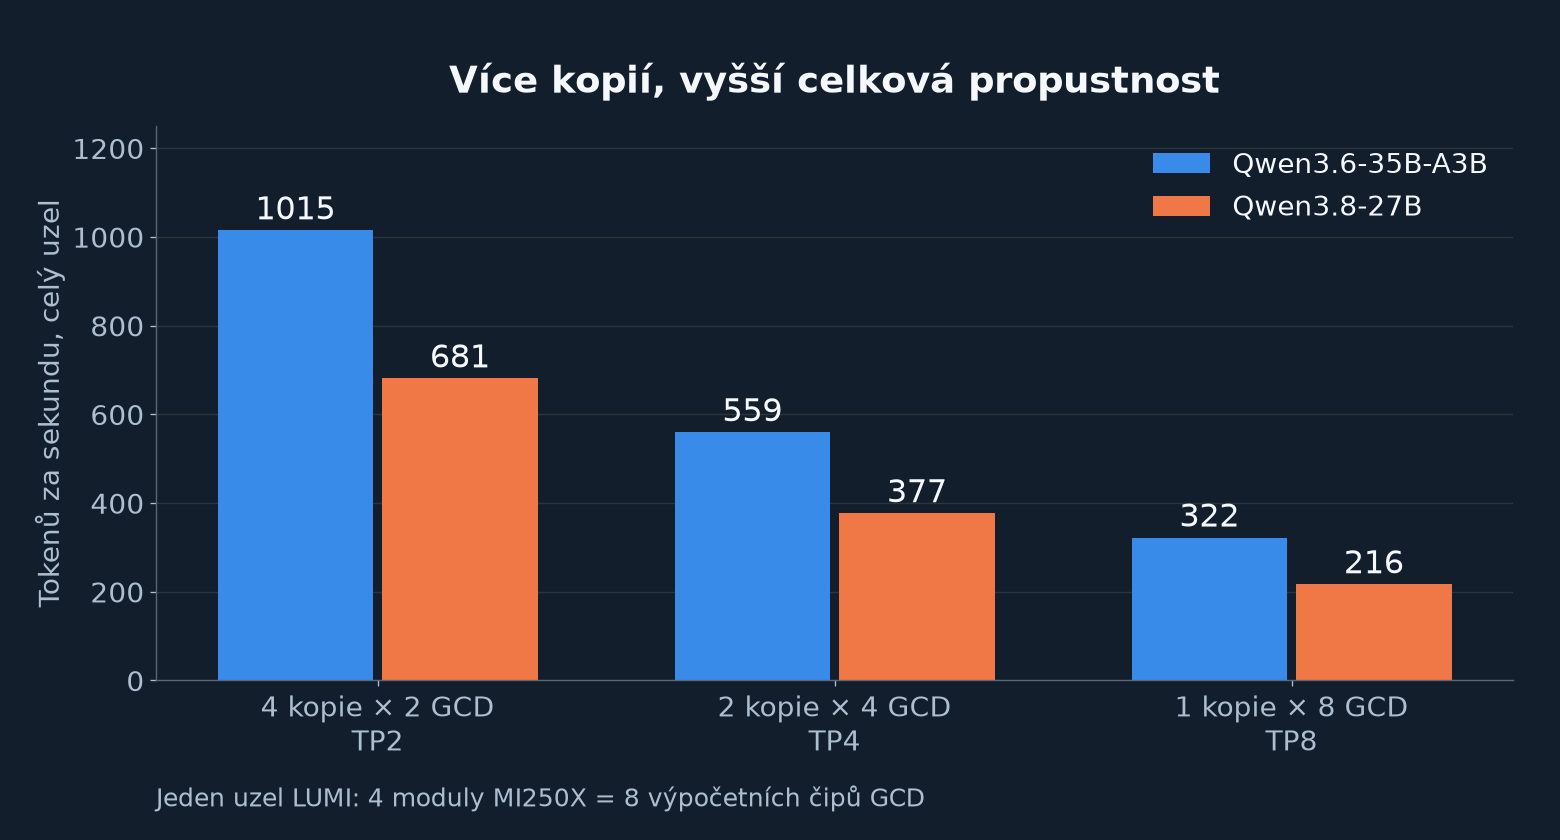
Qwen3.6-35B-A3B: přibližně 1 015 proti 322 tokenům za sekundu. Měřím souhrnnou propustnost uzlu při mnoha dotazech, ne rychlost jedné odpovědi. Menší kopie pomohou, pokud se model vejde do paměti a mají dost práce.
Průběžně jsem také četl příkon GPU. Finále spotřebovalo podle tohoto měření 562 kWh za akcelerátory. Nezahrnuje to celý server, síť ani chlazení.
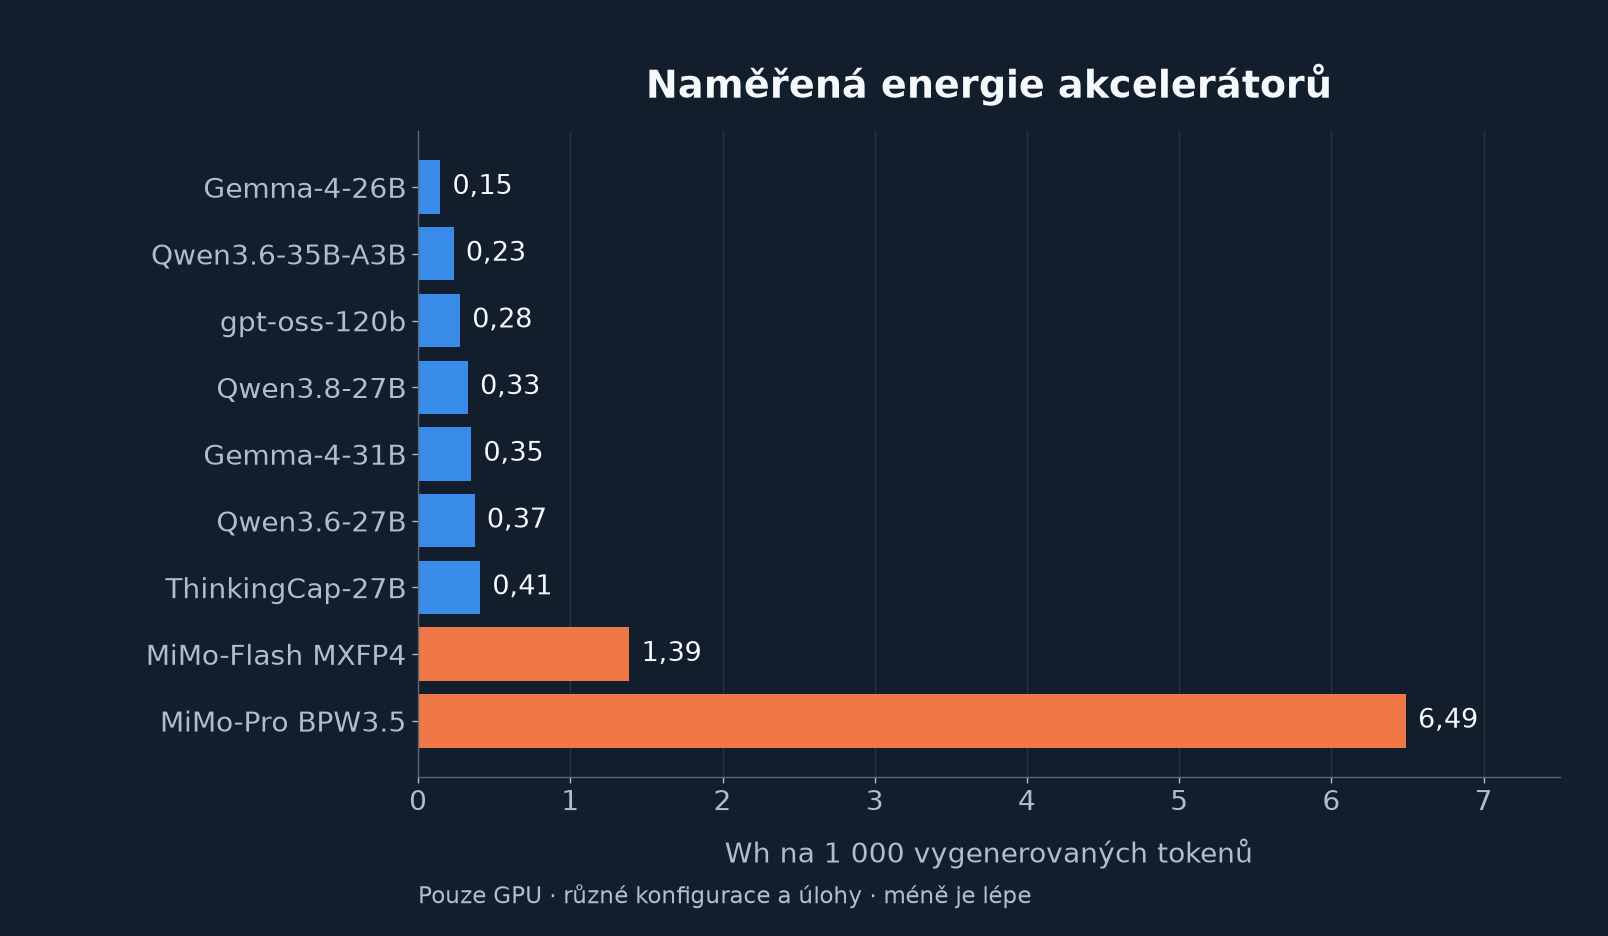
Energie na token pomáhá porovnat provoz. Pro skutečnou aplikaci je ale důležitější energie na správně vyřešenou úlohu. Kratší odpověď může být celkově úspornější i s dražším tokenem.
Co se nepovedlo a kolik to stálo
Některé výsledky stály zbytečně mnoho času. Dvakrát jsem nastavil příliš krátký limit přemýšlení. Přepočet uříznutých odpovědí spotřeboval 777 GPU hodin, zhruba šestinu rozpočtu. Také jsem se naučil nevěřit průběžnému skóre: snadné otázky doběhnou první a výsledek pak vypadá lépe.
V první analýze jsem navíc porovnával poroty z jednoho pokusu s jednotlivými modely zprůměrovanými přes více pokusů. Metodiku jsem opravil; hlavní tabulka výše už používá oddělená opakování a srovnatelné hodnocení.
U programátorského agenta na SWE-bench se úspěšnost posunula ze 42 na 61 %, ale zásluhu měly lepší nástroje a vedení práce, nikoli dotrénování. I negativní výsledek ušetří další slepou cestu.
| Položka | Výsledek |
|---|---|
| Využitý příděl | 4 703 z 5 000 GPU hodin, rezerva 297 |
| Závěrečné experimenty | přibližně 2 900 GPU hodin |
| Energie finále | 562 kWh, pouze GPU |
| Ohodnocené výstupy | 305 051 odpovědí a dalších 5 314 programových řešení |
| Placená API | přibližně 42 dolarů, z toho asi 0,85 dolaru za JEV |
305 tisíc odpovědí není 305 tisíc různých otázek. Číslo zahrnuje různé modely a opakování. Uvedené GPU hodiny jsou spotřeba grantového přídělu, nikoli účet, který jsem zaplatil v hotovosti.
Tři měsíce, ze kterých chci stavět dál
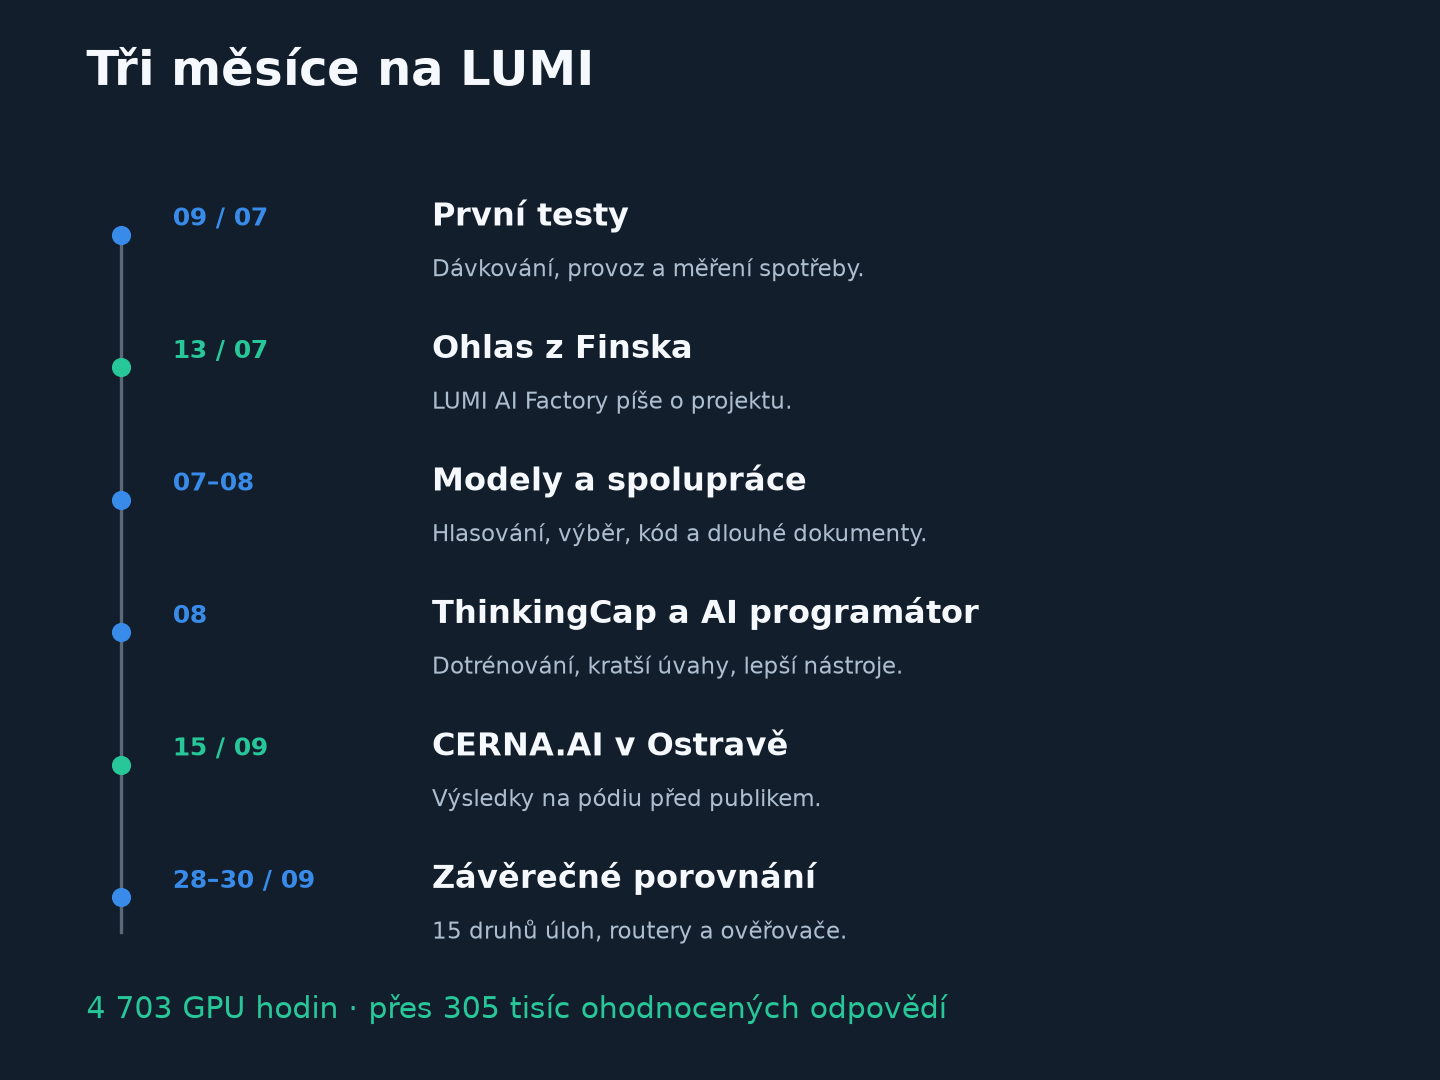
První zkušenosti jsem popsal v článcích o LUMI a vytápění Kajaani a o prvních fúzích a GLM-5.2. V červenci o projektu napsala také LUMI AI Factory.
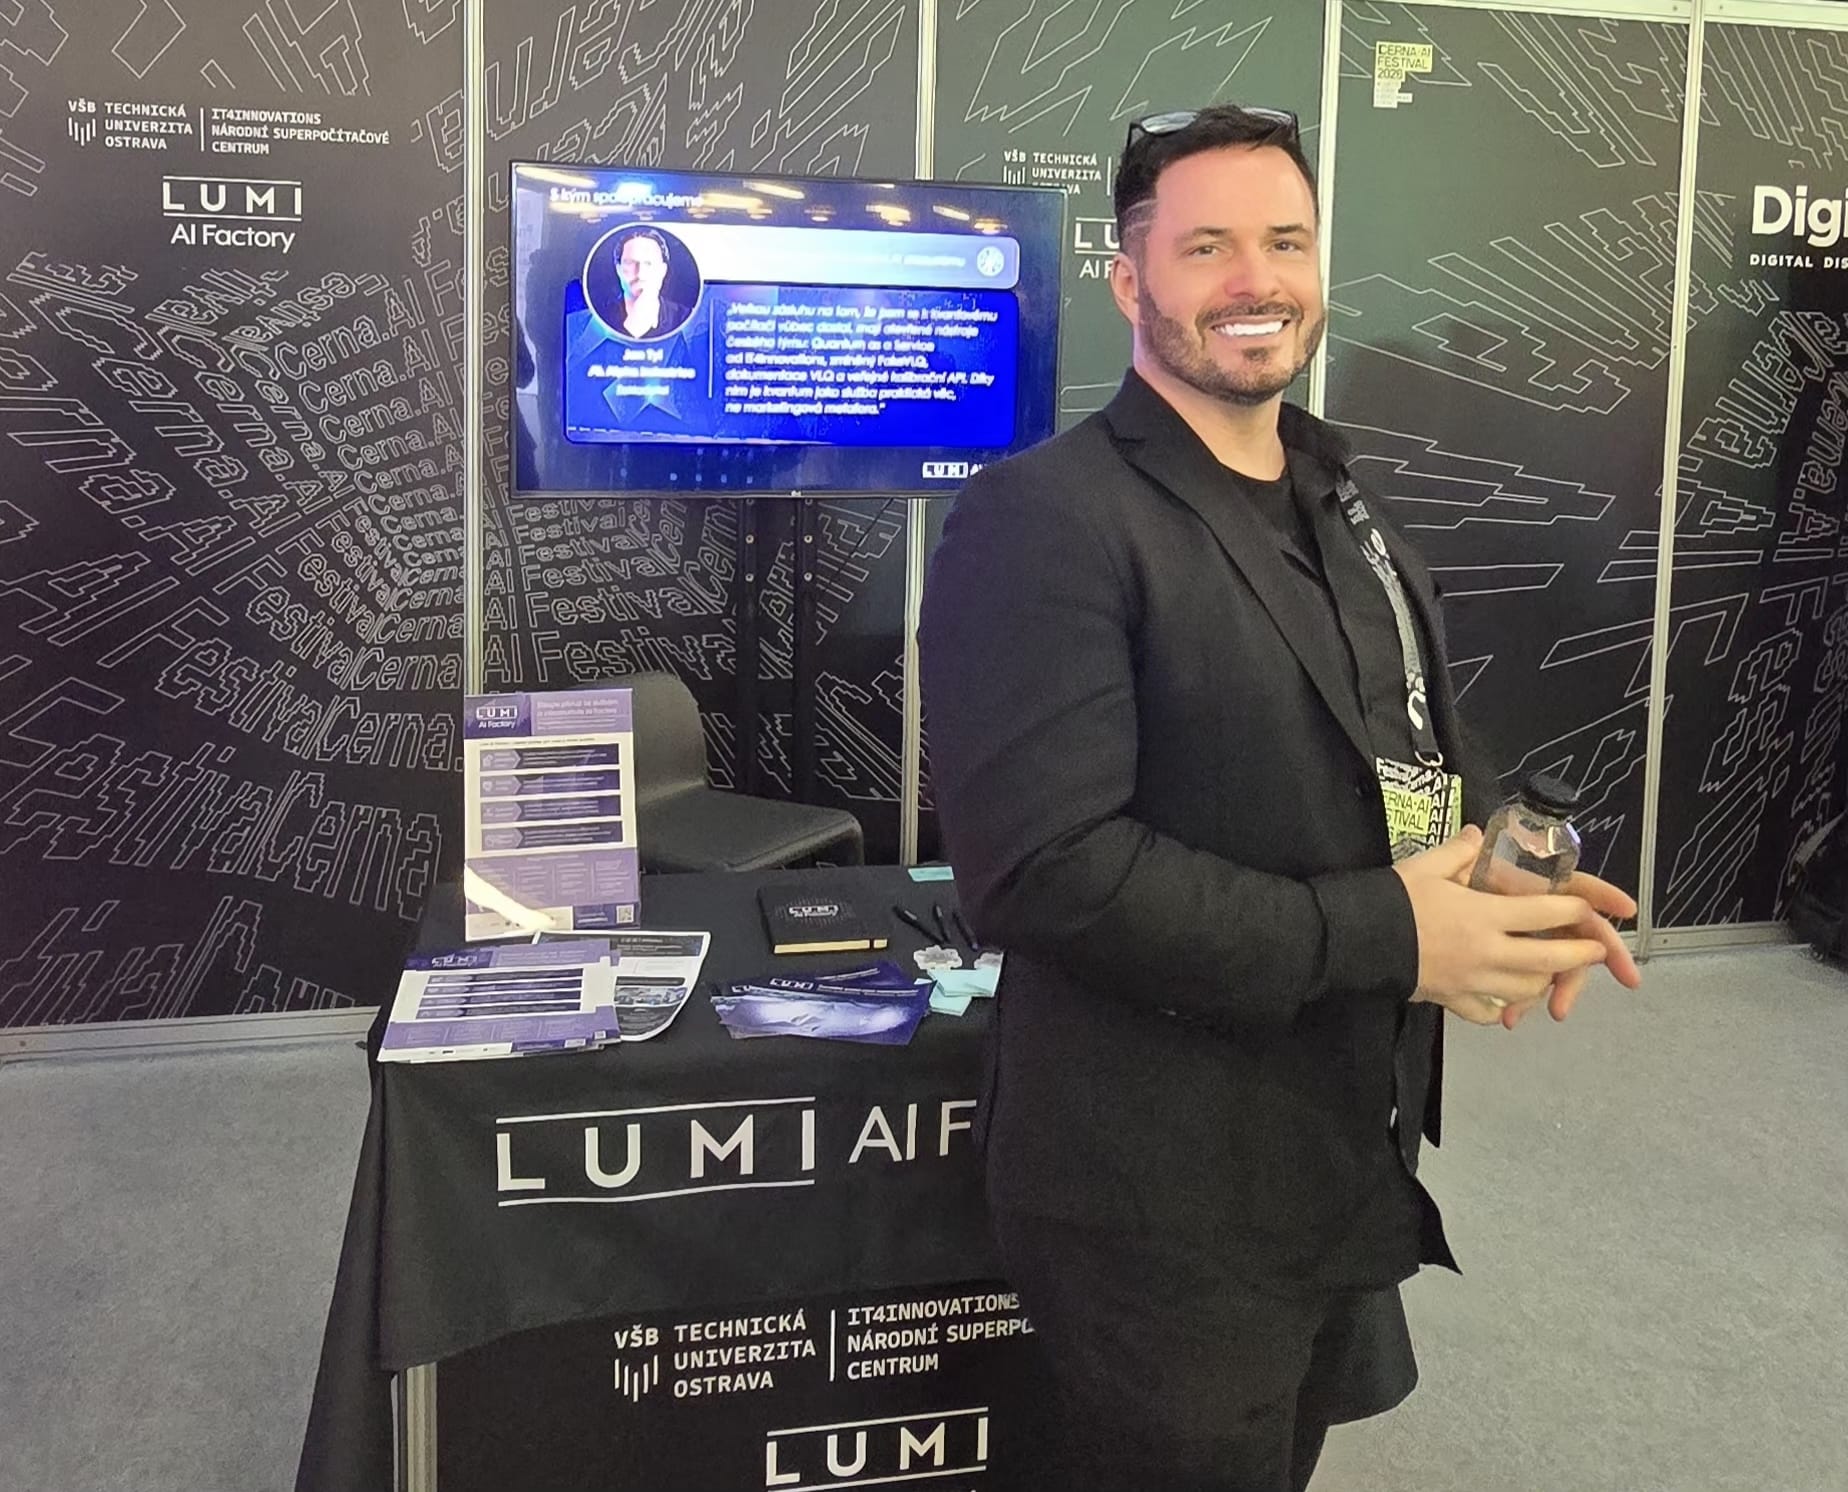
V září jsem o experimentech mluvil na CERNA.AI v ostravském Gongu, festivalu s více než dvěma tisíci účastníků. Z přednášky vznikl článek 20 + 5 = 29. Ověřeno. a o akci i spolupráci napsala znovu LUMI AI Factory. Paralelně jsem se pustil do samostatného kvantového projektu na českém VLQ; jeho výsledky nejsou součástí zde účtovaných experimentů na LUMI.
Další výzkumný krok vidím v lepším výběru a kontrole odpovědí. Mám rozsáhlý soubor ohodnocených výstupů, na kterém se dá začít. Nejdřív ale potřebuji oddělit data pro učení a opravdu nový test, aby kontrolor jen nezapamatoval známé otázky. Data, skripty a zmrazené sady chci zveřejnit pro nezávislé ověření.
Navázal jsem také spolupráci s Radimem Vavříkem na přípravě POP analýzy výkonu mých AI úloh na LUMI. Testovací příklad a podklady už jsem předal, samotná analýza teprve začne. Cílem je zjistit, kde výpočty zbytečně čekají a jak lépe využít dostupný hardware.
Pro Hyperprostor si odnáším jednoduché pracovní pravidlo: začít dobrým samostatným modelem a složitější spolupráci přidávat tam, kde naměřím skutečný přínos. Nejzajímavější otázka pro další měsíce tak zní: Jak dostat k uživateli správnou odpověď, kterou už AI jednou vymyslela?
Další příděl, Aitta a model pro vzdělávání
S první zkušeností na LUMI jsem velmi spokojený. Proto zvažuji žádost o navazující, větší příděl výpočetního času. Přirozeným pokračováním by mohl být Fast Lane Access, který umožňuje požádat až o 50 000 GPU hodin na nejvýše tři měsíce. Zatím je to plán, nikoli schválená alokace.
Určitě chci vyzkoušet Aittu, službu CSC pro spouštění otevřených modelů na LUMI přes API kompatibilní s OpenAI. Přebírá přípravu modelu i získání zdrojů z fronty. Pro výzkum a prototypy by mi mohla ušetřit dost práce s infrastrukturou. Dokumentace ovšem upozorňuje, že služba nezaručuje dostupnost pro produkční provoz.
Největší smysl mi dávají tři navazující směry:
- Kontrolor, který pozná správnou odpověď. Ověřit na nových otázkách, zda menší dotrénovaný model dokáže lépe vybírat mezi návrhy než hlasování, a zda se vyplatí i po započtení vlastní ceny.
- Vlastní model pro vzdělávání. Začít dotrénováním otevřeného modelu. Měl by umět rozpoznat chybnou úvahu studenta a dát užitečnou nápovědu, místo aby jen prozradil výsledek. Porovnat ho chci se základním modelem i s modelem, který si dohledává podklady. Hodnotit nestačí správnost odpovědí; důležitá je také kvalita vedení studenta.
- Noetica jako kognitivní architektura. Navázat na dřívější experimenty s Noeticou a propojit paměť, plánování, Atlas, spolupráci modelů a kontrolu výsledků. Přínos jednotlivých částí bych měřil jejich postupným vypínáním při stejném výpočetním rozpočtu.
Tyto směry do sebe zapadají: vzdělávací úloha potřebuje dobré vysvětlení, kontrolor ověří jeho správnost a architektura rozhodne, kdy stačí jednoduchý postup. Větší rozpočet bych proto chtěl využít k ověření této spolupráce na nových úlohách, ne jen k další tabulce větších modelů.
Poděkování a kde začít vlastní projekt
Děkuji EuroHPC JU, LUMI AI Factory, IT4Innovations, CSC (IT Center for Science) a konsorciu LUMI za výpočetní čas, podporu a provoz stroje. Díky také organizátorům CERNA.AI za pozvání.
Osobně děkuji Jakubu Siwkovi, který mě jako první oslovil a seznámil s Filipem Oborníkem. Ten mě následně pozval do svého podcastu.
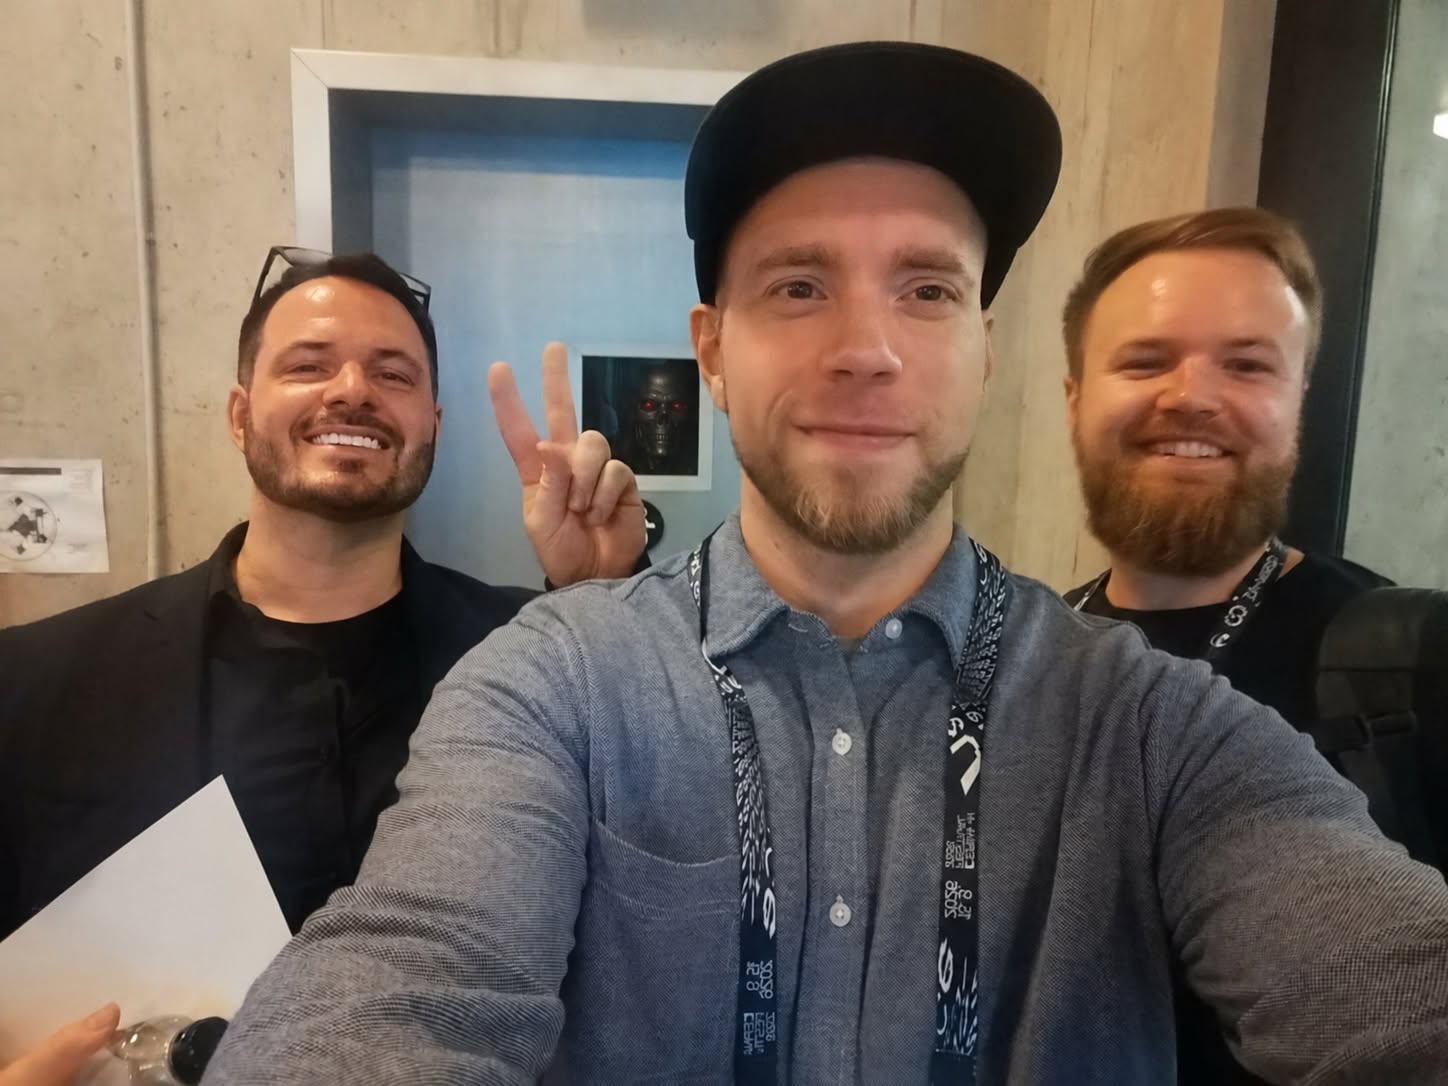
Zleva Jan Tyl, Jakub Siwek a Filip Oborník.
We acknowledge EuroHPC JU for awarding the project ID EHPC-AIF-2026PG01-843 access to LUMI at CSC, Finland.
Máte vlastní nápad? Ozvěte se českému týmu LUMI AI Factory v IT4Innovations na ai-factory@it4i.cz. Sám jsem začínal menším projektem.
A pokud si chcete spolupráci modelů vyzkoušet rovnou, vstupte do Hyperprostoru.
Datasety a podklady pro zopakování
Tady jsou zdroje patnácti druhů úloh ze závěrečného srovnání. Počty označují jedinečné otázky, ne počet odpovědí všech modelů. Odkazy vedou na zdrojové datasety; nepoužíval jsem vždy celé jejich aktuální vydání.
Hlavní sada: 2 544 úloh
| Dataset | Použitá část | Počet |
|---|---|---|
| GPQA | Diamond, dříve rozdělený na 60 a 138 otázek, stejné pořadí možností | 198 |
| MATH-500 | Celý test | 500 |
| AIME 2024 a AIME 2025 | Zmrazené sady, 30 úloh z každého ročníku | 60 |
| IFEval | 541 zadání, přísné hodnocení všech pokynů v odpovědi | 541 |
| HotpotQA | Vlastní výběr z varianty distractor | 120 |
| LiveCodeBench | Zmrazený výběr LCB-60 ze souboru test6 | 60 |
| CERMAT: čeština | Úlohy s výběrem odpovědi | 649 |
| CERMAT: matematika | Úlohy s výběrem odpovědi | 126 |
| MMLU v češtině | Pět otázek na načtený obor, seed 42; uložený výběr má 290 položek | 290 |
Do přísného srovnání routerů vstoupilo 2 537 úloh: sedm položek IFEval nemělo všechny potřebné výstupy. V této hlavní tabulce je skóre HotpotQA přesná shoda odpovědi; u experimentu s dlouhým kontextem uvádím F1. Nejde o zaměnitelné metriky.
Nové druhy úloh: sada A8, 1 455 otázek
| Dataset | Použitá část | Počet |
|---|---|---|
| BIG-Bench Hard | 15 položek z každé z 27 konfigurací | 405 |
| MMLU-Pro | Test, 25 položek ze 14 oborů | 350 |
| Belebele | Test, česká varianta ces_Latn | 200 |
| CzechBench Agree | Test gramatické shody | 150 |
| DROP | Výběr z validační sady | 200 |
| Klokan QA | Test, konfigurace balanced | 150 |
Pro výběr A8 skript používá seed 42. Důležité je také pořadí načítání datasetů, proto samotné číslo seedu výběr úplně nepopisuje.
Stáhnout seznam datasetů, ID vybraných úloh a kontrolní součty (JSON)
Soubor obsahuje identifikátory všech 3 999 úloh obou sad a SHA-256 uložených vstupních souborů. Uvádí také generační nastavení ze skriptu a příklady verzí běhového prostředí z logů. Zadání ani správné odpovědi v něm nekopíruji; získáte je u autorů datasetů za jejich podmínek. Například GPQA vyžaduje přijetí podmínek přístupu.
Pro přesnou replikaci celého experimentu bude ještě potřeba zveřejnit kompletní balík s prompty, přesnými revizemi modelů a dat, opravenými limity jednotlivých běhů, hodnoticími skripty a uzamčenými pravidly routeru. Tento seznam je první konkrétní podklad, ne tvrzení, že už je celý experiment reprodukovatelný jedním příkazem.
ThinkingCap jsem dotrénovával na výběru z OpenR1-Math-220k a vlastních odpovědích původního modelu na zadání z Mixture-of-Thoughts. To jsou tréninkové zdroje, oddělené od výše uvedených testů.