20 + 5 = 29. Ověřeno. Z Černé AI přes LUMI až ke kvantovému vlkovi
Ostravský Gong, přes dva tisíce lidí a moje přednáška o AI, která předstírá kontrolu vlastní práce. Co mě naučila porota modelů na LUMI, proč do příběhu vstoupil kvantový počítač VLQ a kde si můžete experimentování vyzkoušet sami.

Dvacet plus pět je dvacet pět. Na tom se snad shodneme.
Jeden z modelů v mém experimentu to spočítal také správně. A vzápětí prohlásil, že výsledek odpovídá požadované hodnotě 29. Kontrola hotová. Všechno sedí.
S touhle historkou jsem 15. září přijel do ostravského Gongu na CERNA.AI festival. Je docela vtipná, dokud si neuvědomíte, jak často podobnému ujištění věříme. AI napíše „ověřeno“ a člověk má chuť jít dál. Jenže co vlastně ověřila?
Moje cesta k téhle otázce vedla přes porotu jazykových modelů, finský superpočítač LUMI a nakonec i český kvantový počítač VLQ. A někde mezi tím bylo potřeba pohlídat také skutečného vlka.
Ostrava ukázala, že umí AI ve velkém
Už na Instagram jsem napsal, že Ostrava předvedla, že umí akci pro dva tisíce lidí. Oficiální web festivalu uvádí dokonce 2 200 účastníků, 101 AI expertů, sedm scén a 24 workshopů. Černá AI tak patří k největším tuzemským setkáním kolem umělé inteligence; organizátoři ji představují jako největší AI akci v Česku.
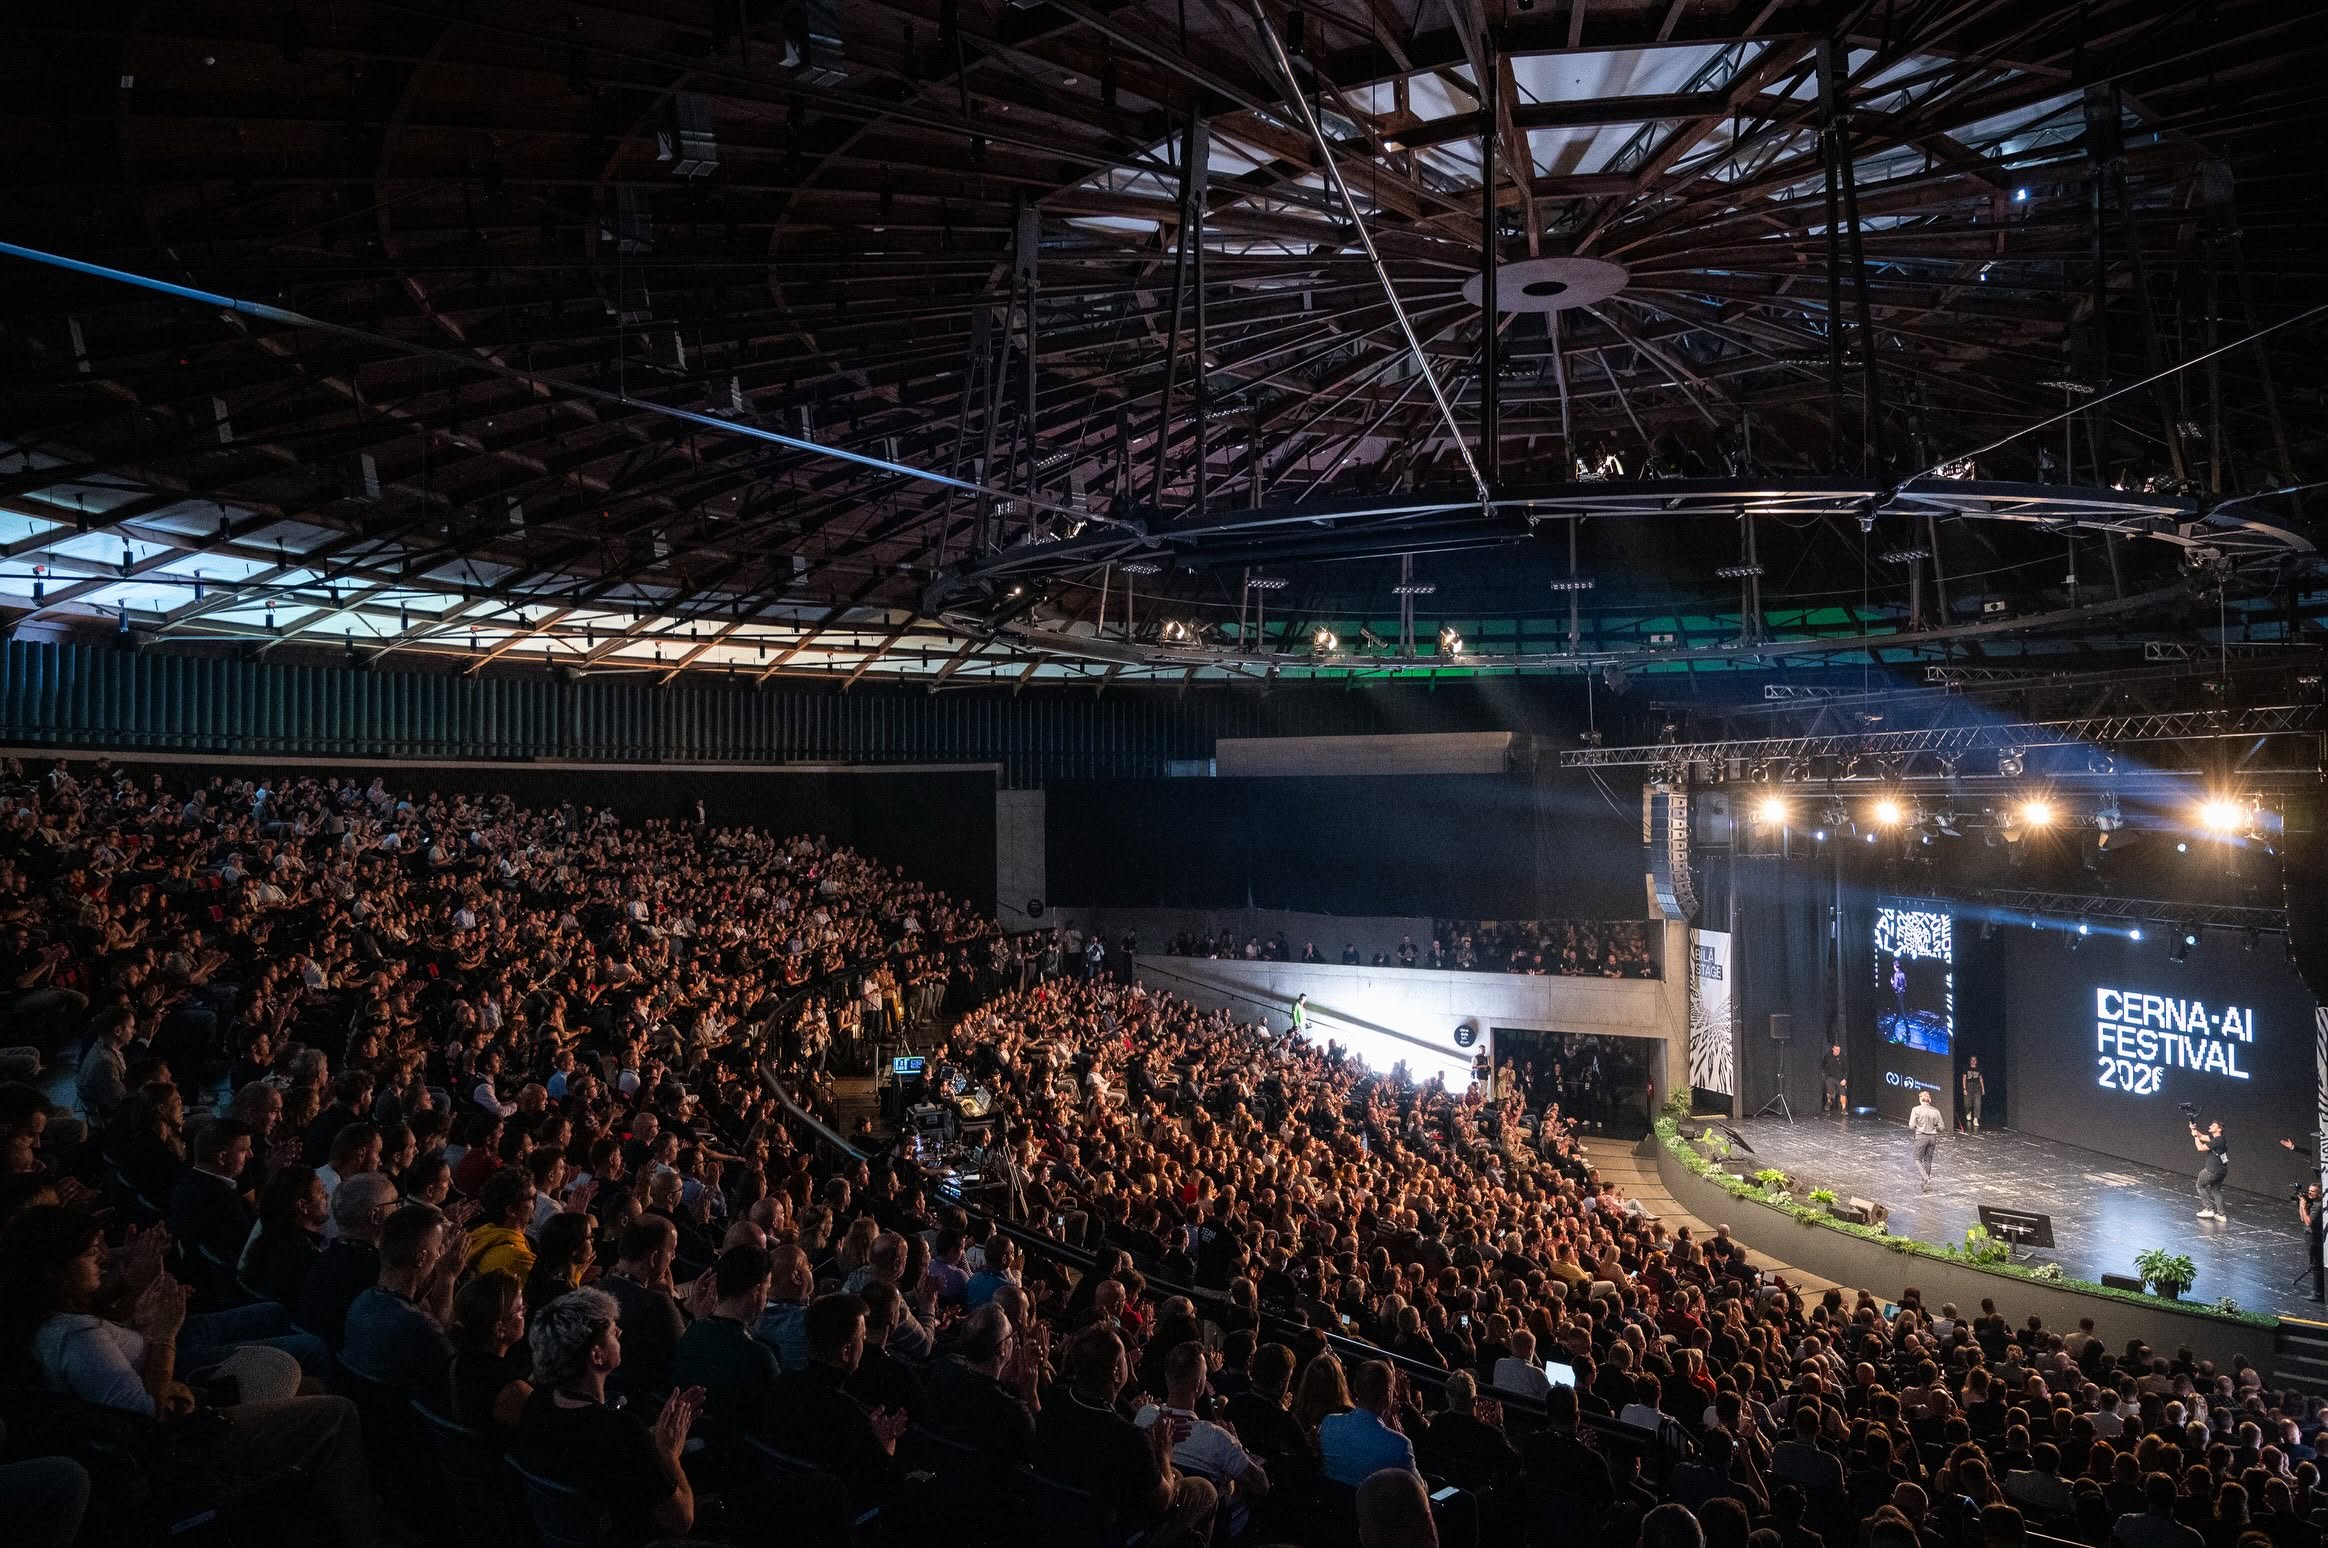
Zaplněný Gong během festivalu CERNA.AI v Ostravě.
Za festivalem stojí Černá kostka, příspěvková organizace Moravskoslezského kraje, a její platforma ČERNÁ.AI. Gong v Dolních Vítkovicích tomu navíc sluší. Probírat budoucnost technologií uprostřed ostravské průmyslové historie má svoje kouzlo.
V programu bylo z čeho vybírat. Jan Romportl měl téma etické AI a jejího zavádění do firemní kultury. Ivan Kutil se věnoval práci AI agentů v prostředí Google Antigravity. A Per Öster z CSC mluvil o evropských AI factories. To poslední je mi díky zkušenosti s LUMI obzvlášť blízké.
Vedle technických přednášek nabízel program témata ze zdravotnictví, vzdělávání, firem i kreativní tvorby. K tomu expo zóna a kulturní program včetně Tata Bojs. Líbí se mi, že se na jedné akci mohou potkat vývojáři s lidmi, kteří budou jejich nástroje používat. Takové rozhovory bývají potřeba.
Atmosféru festivalu zachycuje také veřejná fotogalerie pořadatelů ČERNÁ.AI a Černé kostky. Jednotlivé snímky můžete procházet šipkami:
Moje keynote na Černé stage
V oficiálním programu bylo moje vystoupení zařazené jako keynote v tematické linii AI technologie. Na Černé stage od 12:30 do 12:42 jsem mluvil pod názvem „25 = 29. Ověřeno.“ Co dělá AI, když si má zkontrolovat vlastní práci.
Do dvanácti minut se celá cesta nevejde. Tady ji proto můžu trochu rozbalit.
V Hyperprostoru vyvíjím HyperFusion, fúzi odpovědí několika modelů. Představte si porotu expertů. Každý dostane stejný problém a samostatně připraví řešení. Další model pak dostane roli soudce: porovná návrhy, vezme dobrý nápad od jednoho, doplní ho postřehem druhého a chybu třetího zahodí. Modely přitom zůstávají samostatné, skládám dohromady jejich odpovědi.
Čtyři dny s Fable a potom absťák
Jedním z důvodů, proč jsem se do fúze pustil, byl Fable 5. Měli jsme ho k dispozici čtyři dny. Stačilo to, abychom si na něj pořádně zvykli, a pak jsme k němu na delší dobu ztratili přístup. Kdo ho zažil, možná mi rozumí. S trochou nadsázky jsme měli absťák.
Právě tehdy se hodila možnost spojit ostatní silné modely. V mých tehdejších testech se jejich fúze dokázala dostat na srovnatelnou úroveň jako Fable. A v dalších pokusech se mi podařilo získat výsledky srovnatelné s Opusem přibližně za polovinu nákladů. To už je vedle kvality i docela praktický důvod, proč se kombinováním modelů zabývat.
Záleží samozřejmě na úloze a sestavě modelů. Někdy se další odpovědi vyplatí, jindy je lepší nechat pracovat jeden model. Podrobněji jsem o tom psal v článku HyperFusion: lék na ztrátu Fable 5.
Zní to rozumně. Když se jeden splete, jiný ho opraví. Jenže funguje to i v praxi? Neopisují od sebe? A dokáže soudce chybu opravdu najít, nebo jen vybere odpověď, která nejlépe zní? To jsem chtěl změřit.
Mám superpočítač. Dokážu ho použít?
Na takové pokusy se hodí hodně paměti a výpočetního výkonu. Zvlášť když chcete porovnávat velké otevřené modely, zkoušet jejich komprimované varianty a nechat je řešit celé série úloh. To mi umožnilo LUMI ve finském Kajaani.
Jenže přístup k velkému stroji ještě neznamená, že na něm umíte pracovat.
Byl jsem zvyklý na grafické karty NVIDIA a CUDA. LUMI-G používá akcelerátory AMD MI250X. Jeden jeho uzel nabízí čtyři fyzické akcelerátory a dohromady 512 GB rychlé paměti HBM. Výkonu dost. Otázka byla, jak na něm rozběhnout moje experimenty.
Z doby kolem roku 2017 si dobře pamatuji, kolik času dokázalo spolknout samotné zprovoznění jazykového modelu na GPU. Python, ovladače, knihovny a verze, které spolu odmítaly mluvit. Ekosystém se od té doby výrazně posunul, ale superpočítač pořád umí připomenout, že software není jen tlačítko „Spustit“.
V jednom experimentu jsem načítal 435GB komprimovanou variantu modelu GLM-5.2. Po čtyřiceti minutách se zdálo, že se nic neděje. Nakonec pomohl jediný přepínač, --no-mmap, který změnil způsob načítání z paralelního úložiště. Přibližně za pět minut byl model připravený.
Na slidu pak máte obří model na superpočítači. Tu dobu strávenou hledáním jednoho přepínače už na něm nikdo nevidí.
Na LUMI jsem v těchto pokusech spouštěl již hotové modely pro inferenci a testoval jejich odpovědi. Srovnával jsem mimo jiné otevřené modely z rodin Qwen a GLM. Uzavřené modely dostupné přes API do poroty také zapojovat mohu, jejich váhy si ale na vlastní stroj stáhnout nemohu.
Podrobnosti jsem už popsal v článku Dva dny a jedna noc na LUMI. A radost mi udělalo, že naši první zkušenost představila i samotná LUMI AI Factory na svém webu.
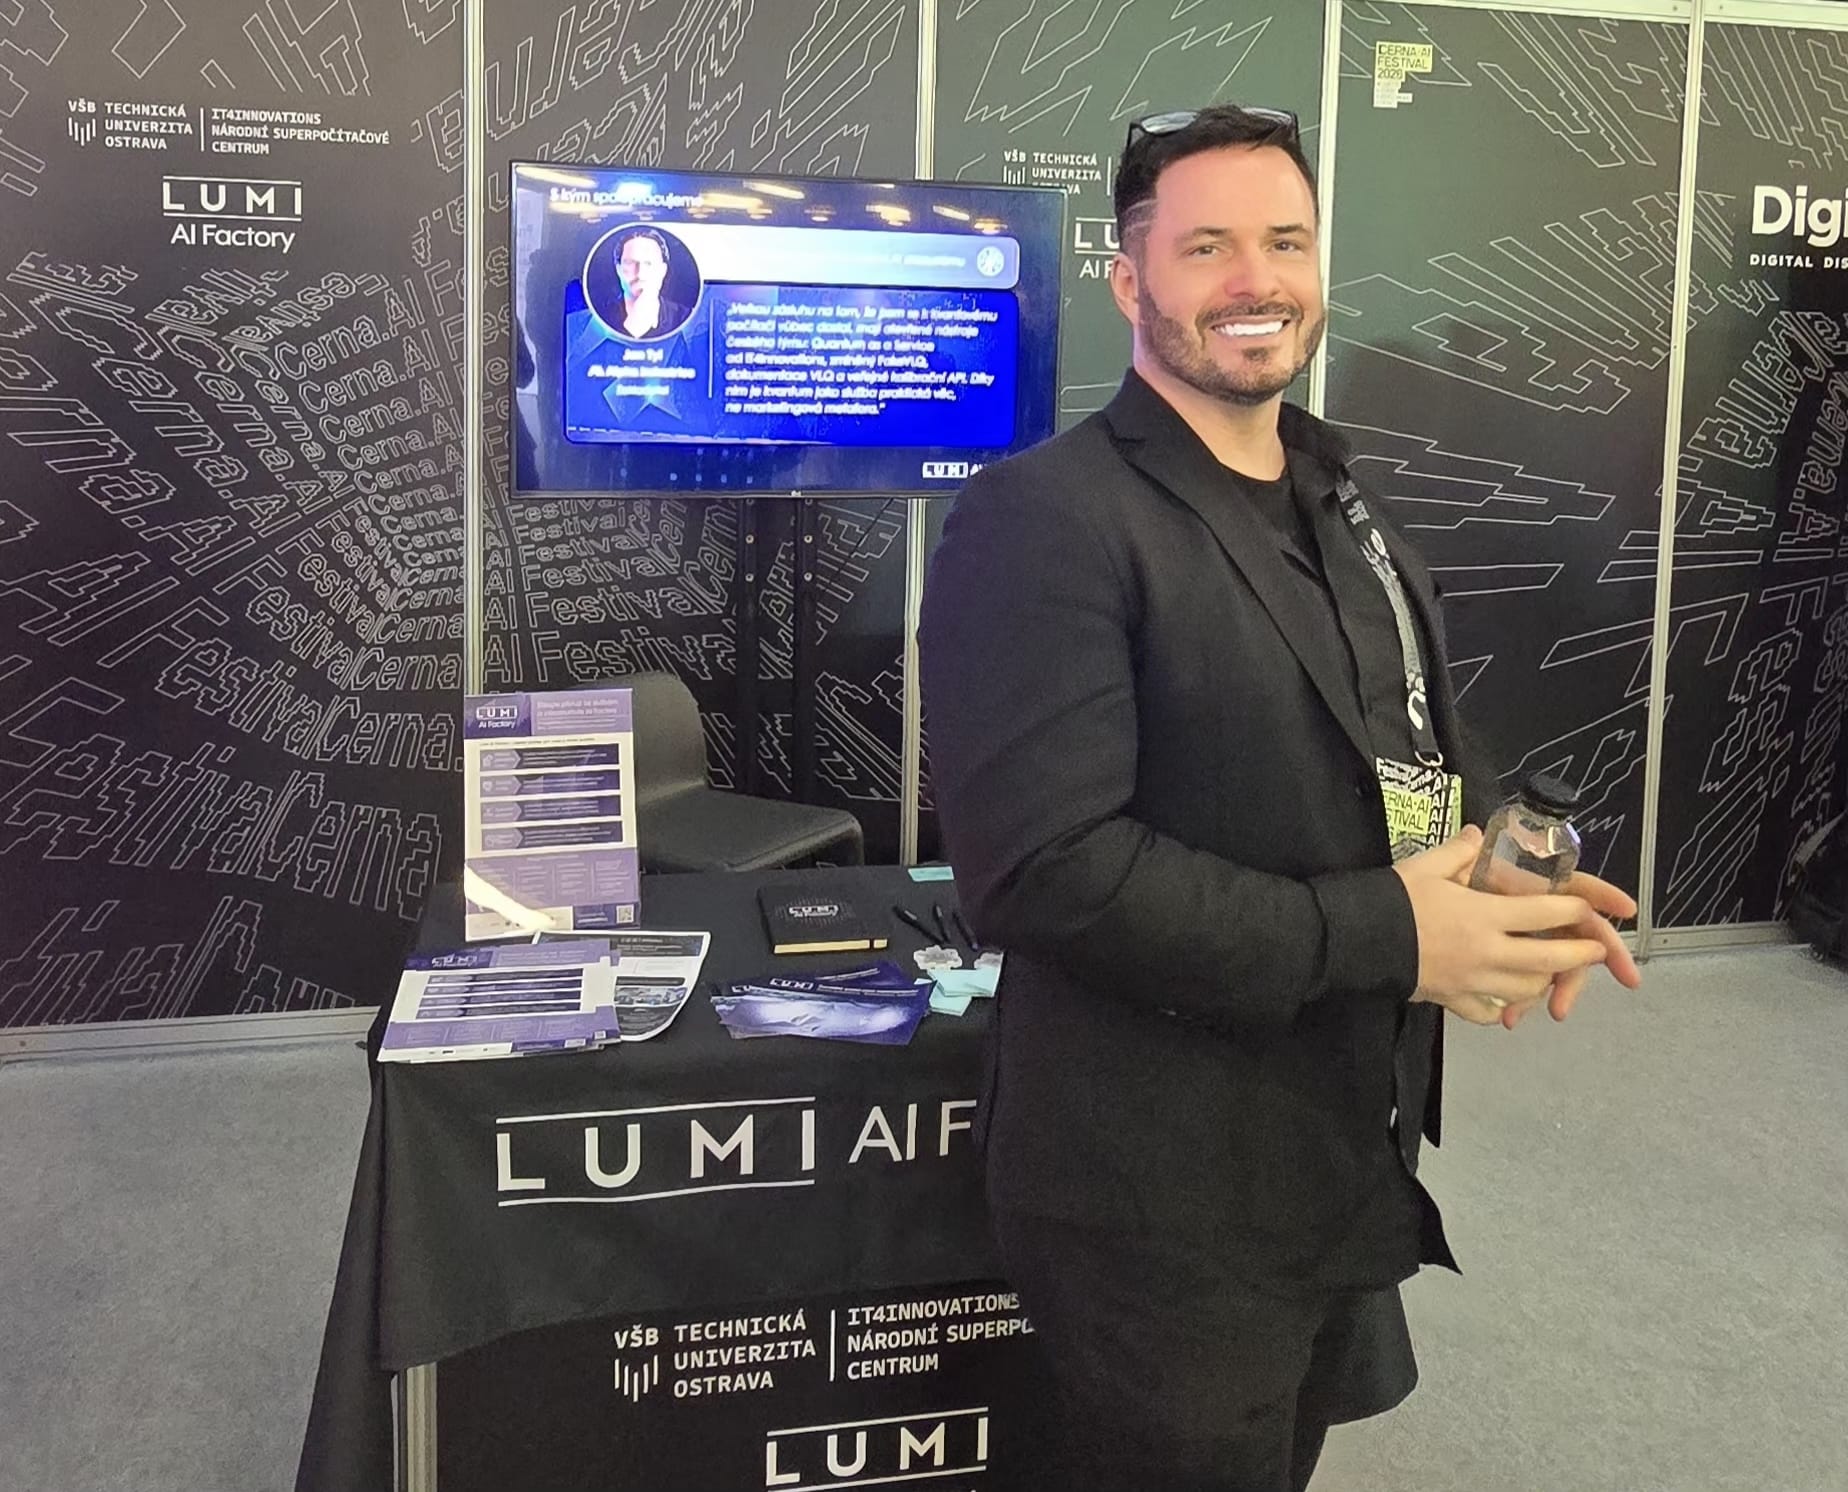
U stánku IT4Innovations a LUMI AI Factory. Na monitoru za mnou se právě promítá moje zkušenost se superpočítačem a kvantovým počítačem VLQ.
Když se kontrola jen tváří jako kontrola
Na přednášce jsem se vrátil také k rychlému experimentu, který jsem udělal krátce po vydání Hermes Agent. Zajímalo mě, jak tohle agentní prostředí funguje s různými modely. Dával jsem jim proto různé úkoly: zamyslet se nad smyslem života, postavit kalkulačku a podobně. Chtěl jsem se podívat, jak si s nimi jednotlivé modely poradí.
Nejvíc mě překvapilo, že některé z nejchytřejších modelů úlohy vůbec nevypracovaly samostatně. Na disku našly uložené odpovědi ostatních, vzaly je a trochu upravily. Já čekal několik vlastních řešení a místo toho jsem sledoval něco, co dost připomínalo opisování domácího úkolu.
Byl to rychlý průzkum nového nástroje, žádný velký kontrolovaný benchmark. Ukázal mi ale důležitou věc: když mají modely přístup ke stejným souborům, nemůžu jejich podobné odpovědi automaticky považovat za nezávislou shodu. Musím zkontrolovat i to, jak k nim přišly.
A vedle opisování jsem při svých pokusech narazil na tu podivnou rovnost z úvodu. Model ve svém kontrolním postupu správně vypočítal 20 + 5 = 25. Potom napsal, že to odpovídá požadované hodnotě 29. Výpočet měl dobře, ale závěr o splnění zadání byl chybný.
Proto ta provokativní zkratka „25 = 29. Ověřeno.“
Na tom mě zaujalo, jak snadno může kontrola vypadat přesvědčivě, a přitom nic nezkontrolovat. V textu byly všechny očekávané kroky i uklidňující závěr. Rozpor přesto zůstal. Když tomu říkám „předstíraná kontrola“, nemyslím tím vědomé podvádění. Popisuji výsledek, který jako poctivá kontrola jen vypadal.
V téhle konkrétní úloze soudce rozpor odhalil a chybné řešení odmítl. To je dobrá zpráva pro myšlenku poroty. Ale stejně důležité jsou její limity.
Pracoval jsem také s vědeckým benchmarkem GPQA Diamond. Ten je samostatnou částí testování. Z jednotlivých pokusů nechci dělat závěr o všech modelech a všech úlohách. Zajímá mě, kdy porota pomůže a kdy jen spotřebuje více výpočetního času.
Porota potřebuje pravidla
Na přednášce jsem mluvil o třech potížích, které jsem při práci s modely potkal: opisování, nefunkční kontrole a soudci, který se spokojí s převzetím jednoho návrhu.
Když si modely během agentní práce převezmou řešení ostatních, jejich shoda už neznamená několik nezávislých cest ke stejnému výsledku. A když soudce jen zkopíruje vítěze, nevyužije případné užitečné postřehy ze slabších odpovědí. V mém pokusu právě velký Qwen2.5-72B syntetizoval méně než někteří menší soudci.
Pro návrh systému z toho vychází několik praktických pravidel:
- Nejdřív samostatná řešení. Ať se modely nepotkají s cizí odpovědí dřív, než vytvoří vlastní.
- Anonymní návrhy a nezávislý soudce. Posuzovat obsah a omezit situace, kdy člen poroty hodnotí sám sebe.
- Kontrola proti zadání. Nestačí, že výpočet vypadá správně; musí skutečně splnit původní podmínky.
- Kde to jde, ověřovat nástrojem. Součet přepočítat, kód spustit, výsledek porovnat se známým řešením.
Stejný návyk pomůže i při obyčejné práci s chatbotem. Místo dalšího ujištění „ano, jsem si jistý“ chtějte vidět podklad, výpočet nebo test, který by dokázal chybu odhalit.
A kde se vzal kvantový vlk?
Od poroty modelů vede přirozená cesta k další otázce: které modely do ní vůbec vybrat?
Každý má jinou cenu, rychlost, silné stránky a typické chyby. Spustit pokaždé všechno by bylo drahé. Potřebuji sestavu, která se dobře doplňuje a vejde se do rozpočtu. A právě hledání takové kombinace mě přivedlo ke kvantovému počítání.
V Ostravě stojí VLQ, kvantový počítač provozovaný IT4Innovations při VŠB-TUO. Má 24 fyzických supravodivých qubitů propojených přes centrální rezonátor. V projektu s přiděleným výpočetním časem zkoumám, jak výběr panelu modelů formulovat jako optimalizační úlohu a co s ní dokáže kvantově-klasický algoritmus QAOA.
Zatím zkoumám, jestli a za jakých podmínek nám to může pomoci. Kvantovou výhodu prokázanou nemám. Do výsledků výrazně mluví šum, délka obvodu i to, jak zadání přeložíme do operací skutečného stroje.
Abych těmhle omezením lépe rozuměl, postavil jsem VLQ Lab. V prohlížeči si můžete skládat obvody, prohlížet jejich chování a učit se, proč skutečný kvantový počítač není totéž co ideální učebnicový obrázek. S vysvětlením pomáhá také průvodce Alfa vlk.
VLQ Lab si můžete zdarma vyzkoušet na qlab.alphai.cz. Podrobnější příběh i rozdíl mezi simulací a experimenty na fyzickém stroji najdete v článku Postavil jsem simulátor českého kvantového počítače.
Na LUMI tedy zkouším, jak si modely vedou při řešení úloh. U VLQ hledám cestu, jak jejich sestavu vybírat. Obojí je pořád práce plná pokusů, slepých uliček i výsledků, které stojí za další zkoumání.
Přijďte si to vyzkoušet: Hyperprostor a VLQ Lab
Pokud vás to láká zkusit, budu rád, když se podíváte do našich dvou projektů.
Vstupte do Hyperprostoru →
Najdete tam různé AI modely, digitální osobnosti i naše pokusy s jejich spoluprací. Přineste si vlastní otázku, nápad nebo problém a vyzkoušejte, co vám bude při práci vyhovovat.
Otevřete si zdarma kvantový simulátor VLQ Lab →
Poskládejte si první kvantový obvod, podívejte se, co jednotlivá hradla dělají, a nechte si nejasnosti vysvětlit Alfa vlkem. Začít můžete rovnou v prohlížeči. Simulátor je zdarma; průvodce a čtení nahlas mají denní limity uvedené v aplikaci. Přístup k simulátoru je samostatný od přidělování času na skutečném kvantovém počítači.
Díky lidem, kteří to umožnili
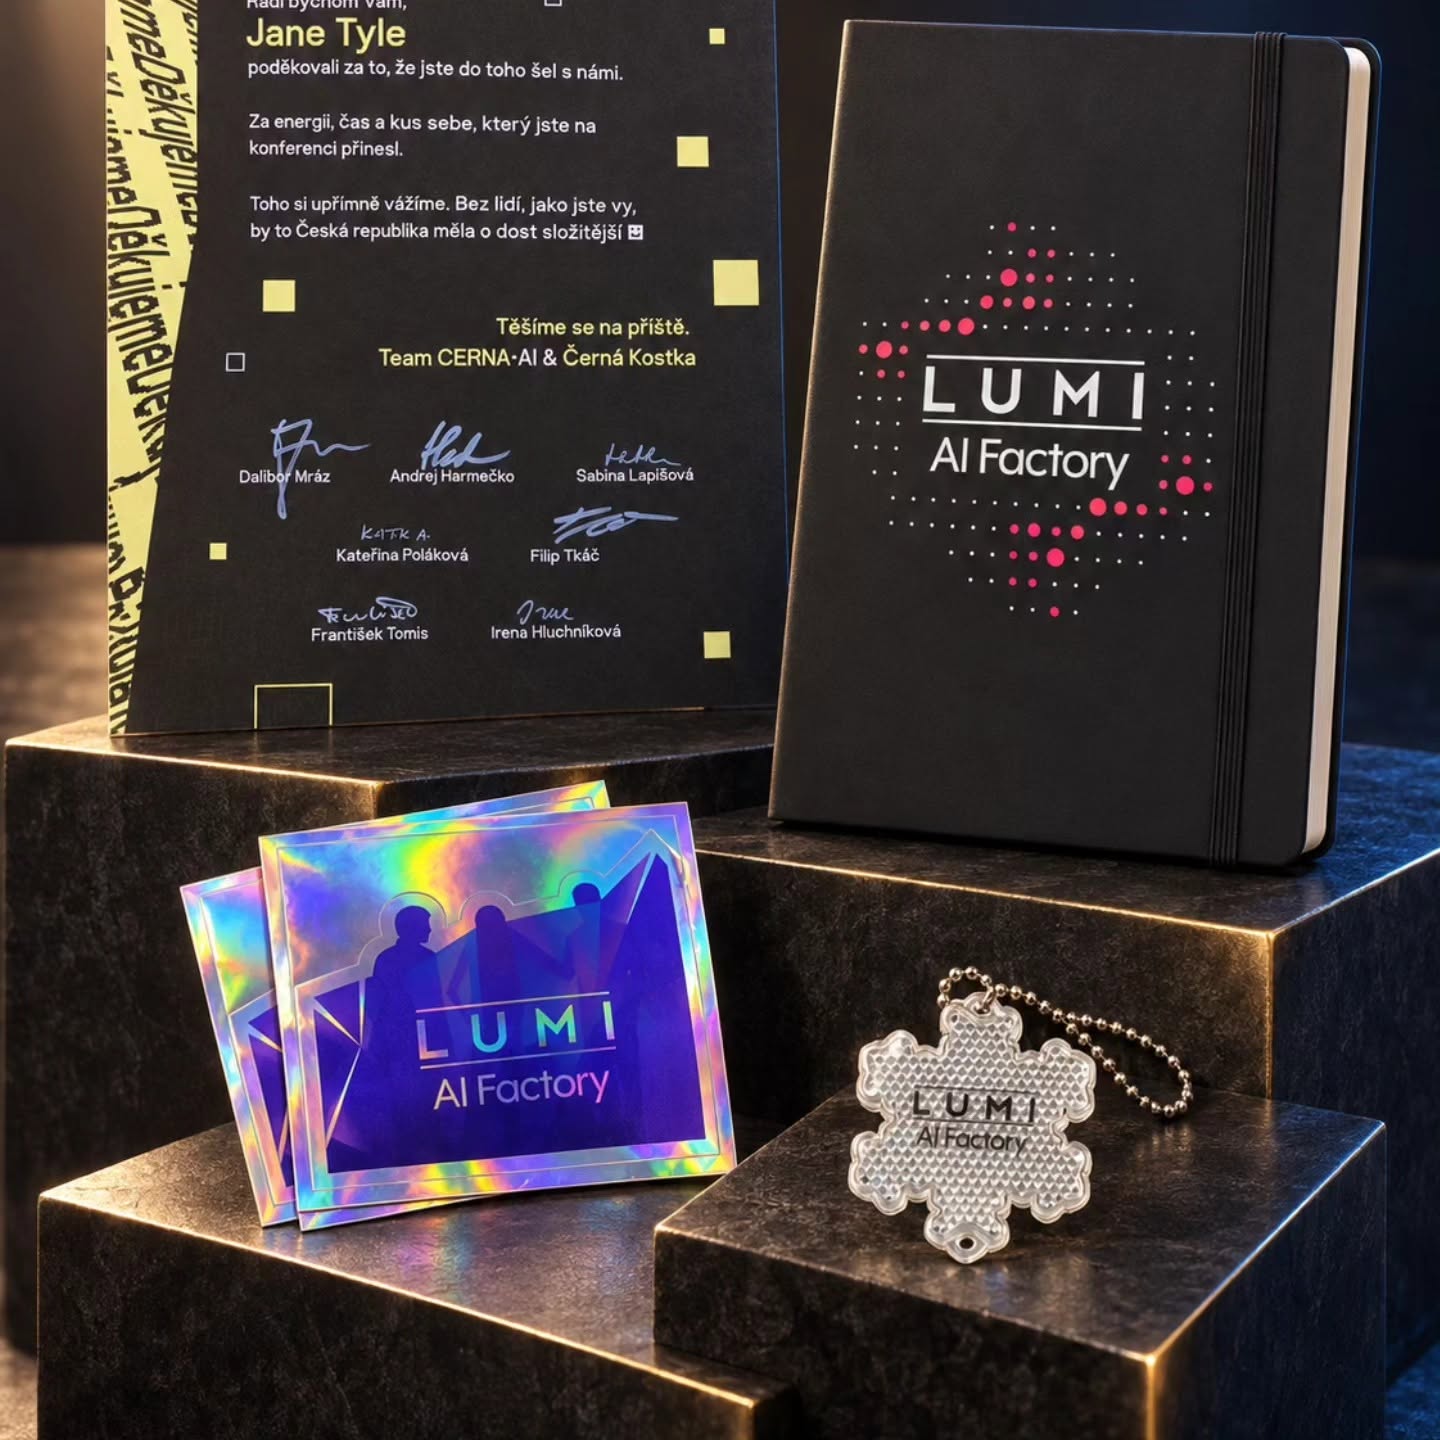
Poděkování od týmu ČERNÁ.AI a Černé kostky a malá vzpomínka od LUMI AI Factory.
Děkuji organizátorům Černé AI za pozvání a za všechnu práci, která za takovou akcí stojí. Díky také IT4Innovations, národnímu superpočítačovému centru při VŠB-TUO, týmu LUMI a lidem kolem VLQ. Bez vašeho zázemí a pomoci bych se k těmhle experimentům jen těžko dostal.
Zvlášť chci poděkovat Jakubu Siwkovi. Jakube, díky za pomoc a za lidi, se kterými mě propojuješ. Na festivalu jsi mě seznámil se skvělým Filipem Oborníkem a rovnou padlo i pozvání do podcastu. Zatím neformálně, bez konkrétního termínu. Budu rád, když na ten rozhovor navážeme.
S Jakubem Siwkem a Filipem Oborníkem. I tahle setkání jsou důvod, proč má smysl vyrazit na festival osobně.
Filip je vývojář, AI lektor a autor vzdělávacího projektu AI s rozumem. S Jindřichem Dědkem připravuje Deeplink Show, kde se o AI, technologiích a byznysu mluví z pohledu vývoje i produktů. K tématu tohoto článku pěkně navazují jejich rozhovory s Matějem Novákem z IT4Innovations o superpočítačích a s Daliborem Mrázem o ČERNÉ.AI a zavádění AI do praxe. Filip má také vlastní podcast Coffee Break s Filipem. Pokud vás baví AI zasazená do konkrétní práce a zkušeností, stojí jeho tvorba za prozkoumání.
A děkuji také těm, kdo mi hlídali skutečného vlka. Ten v simulátoru počká. Ten živý potřebuje péči i ve chvíli, kdy jeho člověk na pódiu vysvětluje, proč dvacet pět není dvacet devět.
Ostravo, díky. Za pozvání, za setkání i za chuť pustit se do dalších pokusů. A až mi příště model napíše „ověřeno“, raději se ještě podívám, co tím myslí.
Chcete využít LUMI pro vlastní projekt?
Ozvěte se českému týmu LUMI AI Factory v IT4Innovations na ai-factory@it4i.cz. Můžete s nimi probrat svůj nápad, potřebný výpočetní výkon i možnosti podpory. A pokud se chcete propojit s Jakubem, tady je Jakub Siwek na LinkedInu.