DevDay 2026: Sol skoro jako Astra. Co z novinek OpenAI opravdu využijeme v Česku?
Sol, Astra a konkurence: benchmarky, ceny a rychlost. Dots proti Hermesovi a OpenClaw, dostupnost v Česku a přehled předplatných. Co znamená 20×, kolik práce odhadnout a na co vystačí 62 500 kreditů?

OpenAI na DevDay 29. září oznámilo přes dvacet novinek. Část z nich je působivá, část budeme moci pořádně posoudit až po delším používání. Pro mě jsou teď nejdůležitější tři otázky: Co umí nový model za své peníze? Kolik práce skutečně udělám v předplatném? A co si vůbec mohu zapnout z Česka? Přehled oznámení OpenAI
GPT-6.1 Sol už jsme si prošli v mém Hyperprostoru. To ale ještě není kontrolovaný benchmark. Čísla níže pocházejí z veřejných měření, u každého rozlišuji jejich původ. Vlastní doporučení berte jako návrh, co vyzkoušet na své práci.
Článek k události z 29. září 2026. Dostupnost, dvojice medium/max, ohlasy na Dots a část o kreditech byly ověřeny a doplněny 30. září. Zavádění funkcí se může lišit podle účtu a firemního nastavení.
DevDay v kostce: šest novinek a co od nich čekat
-
Dots: osobní agent s vlastním cloudovým počítačem. Pohání ho GPT-6 Astra, může pracovat na pozadí a podle OpenAI se přes pluginy propojit s více než 4 000 aplikacemi. Přístupy mu ale musíte povolit a práce čerpá limity. V Česku je osobní Pro z úvodního zavádění vynechané; Business Premium a Enterprise se zavádějí celosvětově, u Enterprise rozhoduje správce. VPN není ověřená záruka přístupu. Co Dots umějí, dostupnost podle tarifu.
-
GPT-6.1 Sol: silný kandidát pro každodenní práci za rozumnou cenu. Standardní API stojí 2 USD za milion vstupních a 10 USD za milion výstupních tokenů při vstupu do 272 tisíc tokenů. To je pětina běžné vstupní a výstupní sazby Astry, ne automaticky pětina ceny celého úkolu. Výkon se jí v některých testech blíží, jinde vede Astra nebo konkurence. V ChatGPT ho najdete ve Work a Codexu, zatím ne v běžném Chatu. Parametry a ceny, dostupnost.
-
Agents API: vlastní agent bez stavění celého provozu od nuly. OpenAI spravuje běhové prostředí Codexu, průběh úloh a zkracování kontextu. Přidává práci více agentů, vyhledávání nástrojů a ovládání počítače v podporovaném prostředí. Vývojář stále určuje nástroje, přístupy a kontrolu výsledků. Dokumentace Agents API.
-
MCP Events: automatizace spouštěné událostí. Podporovaný plugin může upozornit ChatGPT třeba na nový úkol nebo komentář a spustit domluvenou práci. Specifikace je stále návrh, ChatGPT už ale dokumentuje implementaci přes webhooky, tedy zprávy o událostech odeslané z připojené služby. Neplatí to automaticky pro každý plugin. Jak MCP Events fungují.
-
Decisions API: Luna pro úzká, opakovaná rozhodnutí. Vývojář předem určí možné odpovědi, například kategorie požadavků nebo další krok agenta. Při oznámení jde o omezený preview přístup. Zajímavé pro směrování práce, ale cenu a chybovost bude potřeba ověřit na vlastních datech. Oznámení Decisions API.
-
Astra Ultrafast: méně čekání za vyšší spotřebu. OpenAI uvádí až 8× rychlejší generování tokenů v Codexu. Nejde o příslib osmkrát rychleji hotového projektu. Režim je dostupný v API a ve Work/Codexu na Pro 500 a způsobilých Enterprise/Edu tarifech. Pro Sol 6.1 je teprve ohlášený. Rychlost, limity a dostupnost, režim v API.
Vedle této šestice bych nepřehlédl Space a Pages pro společnou práci a změny limitů předplatného. Bonus 62 500 kreditů je příjemný, dlouhodobě je ale důležitější, kolik práce zvládne Pro 200 po změně zahrnutého využití. Obojí rozebírám níže.
Sol se přiblížil Astře. Konkurence ale nezmizela
OpenAI prezentuje GPT-6.1 Sol jako model blízký Astře při agentním programování, ovládání počítače a odborné práci, za pětinu jejích standardních vstupních a výstupních tokenových cen. To je tvrzení výrobce. Zajímavější je, co z něj přežije pohled zvenčí. Oznámení GPT-6.1 Sol
Kde ho hledat: v ChatGPT Work a Codexu na Plus, Pro a firemních tarifech, případně přes API jako gpt-6.1-sol. V běžném Chatu zatím dostupný není. Pokud ho nevidíte v klasickém výběru modelů, nemusí být problém v českém účtu.
Následující tabulka porovnává medium s medium a max s max. U každého modelu tak vidíme i cenu posunu mezi oběma nastaveními. AA Intelligence Index je souhrnné skóre, nikoli procento správných odpovědí. USD za úlohu znamená vážený průměr nákladů v tomto indexu, ne cenu libovolného zadání v ChatGPT.
| Model | Medium: AA index | Medium: USD/úloha | Max: AA index | Max: USD/úloha |
|---|---|---|---|---|
| GPT-6.1 Sol | 48 | 0,21 | 52 | 0,72 |
| GPT-6 Astra | 50 | 1,54 | 53 | 3,26 |
| Claude Opus 5.5 (s fallbacky) | 51 | 1,34 | 58 | 5,98 |
| Claude Sonnet 5.5 (s fallbacky) | 41 | 0,59 | 56 | 7,60 |
| GPT-6 Sol | 40 | 0,25 | 48 | 1,05 |
| GPT-6 Luna | 29 | 0,02 | 37 | 0,07 |
| Gemini 3.8 Flash | 40 | 0,93 | není v sadě | není v sadě |
Zdroj: Artificial Analysis, stav 30. 9. 2026, index v4.3.2 a zaokrouhlené hodnoty. „Není v sadě“ znamená, že tento řádek v použitém žebříčku není; není to nula. U Claude zachovávám označení AA „with fallback“.
Stejné názvy nastavení ještě neznamenají stejný výpočetní rozpočet. Medium ani max nejsou společná norma výrobců. Claude s fallbacky a GPT se navíc liší postupem vyhodnocení. Tabulka odstraňuje míchání úrovní, ale není experimentem se stejným počtem tokenů nebo stejnou cenou. Proto ukazuji zároveň skóre i skutečné náklady testu.
U dvou modelů je potřeba dodat další dostupné výsledky. Gemini má v AA vedle medium také high, které nepřejmenovávám na max. MiMo zde nemá rozlišené úrovně medium/max.
| Další zveřejněná konfigurace | AA index | USD za úlohu indexu |
|---|---|---|
| Gemini 3.8 Flash, high | 41 | 1,24 |
| MiMo-V2.6-Pro, bez rozlišení úrovně v AA | 46 | 0,13 |
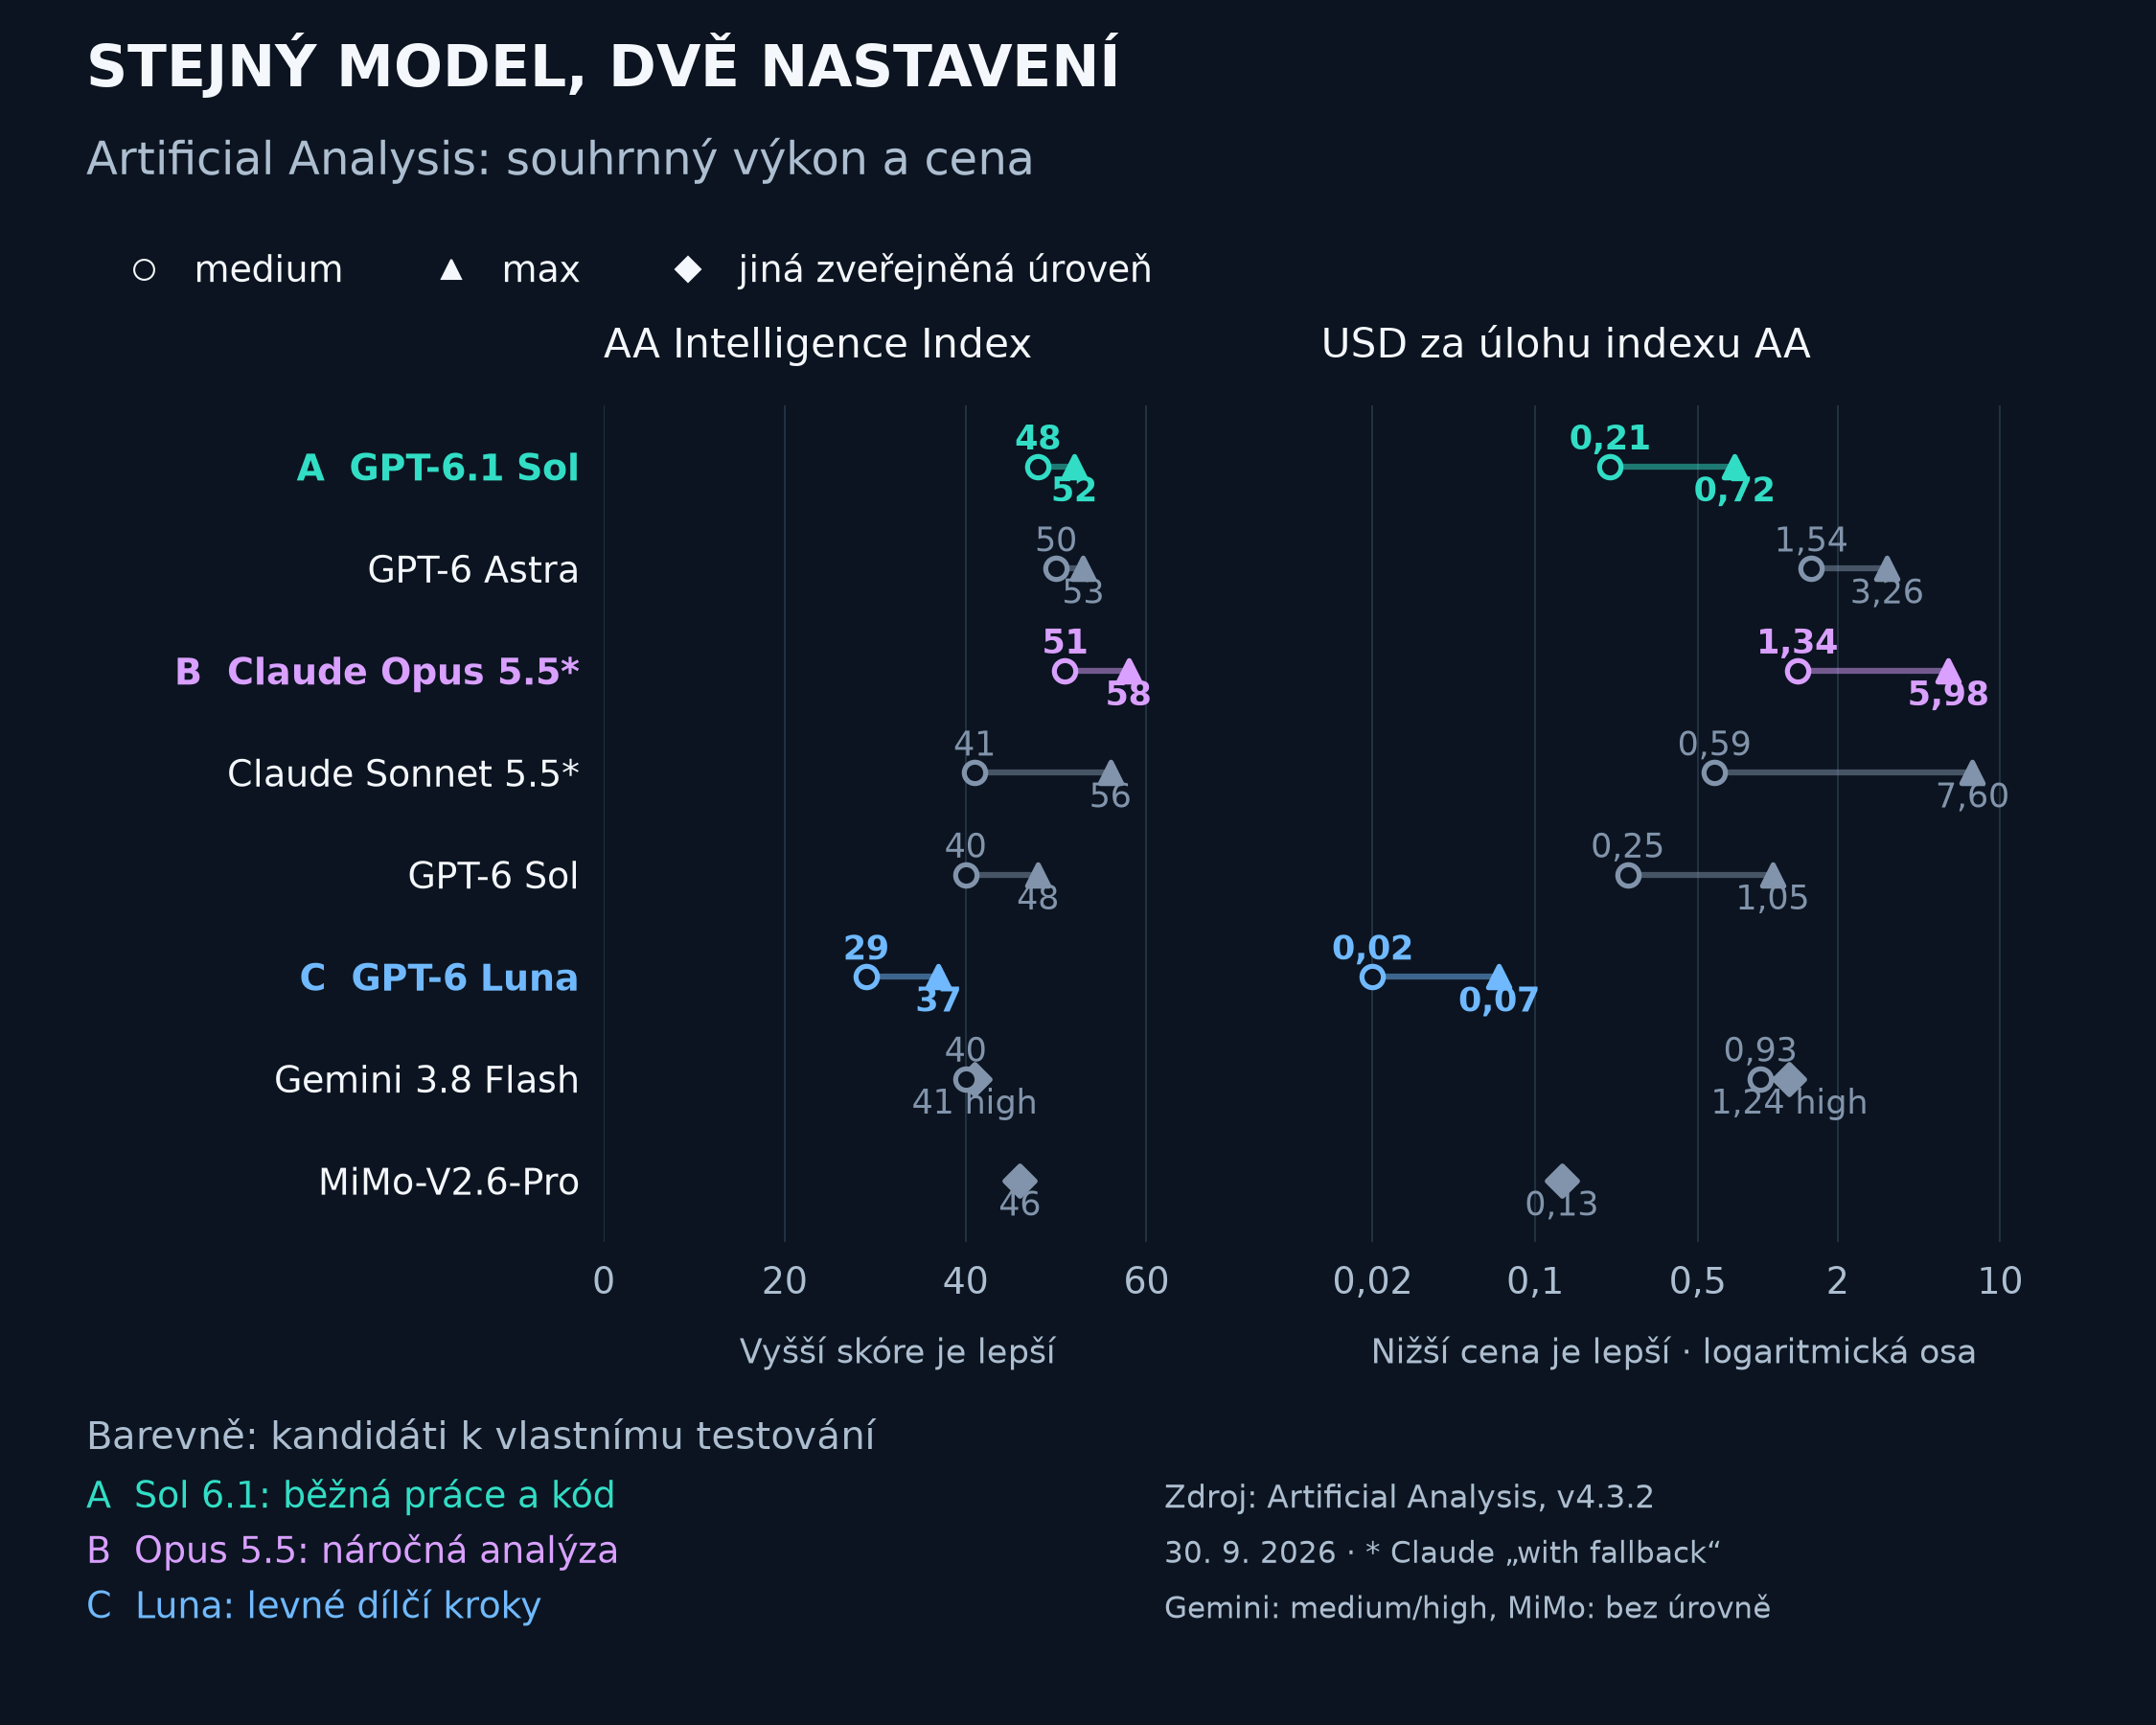
Otevřít graf v plné velikosti · Stáhnout všech 15 konfigurací jako CSV
V grafu porovnávám dvě nastavení vždy na jednom řádku. Cenová osa je logaritmická: stejná vzdálenost znamená stejný násobek ceny. Zvýraznění je můj výběr kandidátů k vlastnímu testování, ne další nezávislý žebříček:
- A: Sol 6.1 pro každodenní práci. Medium bych zkusil na běžné úpravy kódu, přípravu podkladů a práci s dokumenty. Max na obtížnější analýzy, kde přínos ověřím. V AA získává přechodem z medium na max čtyři body, cena roste z 0,21 na 0,72 USD.
- B: Opus 5.5 pro náročná zadání. Nejvyšší skóre z tohoto výběru má na max, ale medium stojí za samostatné vyzkoušení. Proti Astře medium má v AA o bod více při nižší ceně úlohy. Zvlášť u důležitého výstupu bych porovnal oba a započítal čas na kontrolu.
- C: Luna pro levné, úzce vymezené kroky. Třídění požadavků, extrakce údajů podle schématu nebo jednodušší automatizace. Nízká cena se vyplatí jen tehdy, když si ověřím dostatečnou úspěšnost a obtížné případy předám dál.
MiMo bych přidal do cenově citlivého testu. Gemini má zase vedle textu podporu zvuku a videa na vstupu, takže pro multimodální úlohu může být zajímavý i při nižším souhrnném skóre. Doporučená použití jsou moje návrhy k ověření, nikoli schopnosti prokázané samotným souhrnným indexem. Profil Gemini a srovnání s Opus
Programování: medium a max také ve FrontierCode
FrontierCode od Cognition hodnotí změny v reálných repozitářích. Používám jeho verzi 1.1, sadu Main a metriku Score. Opět ukazuji obě nastavení, tentokrát s cenou jedné úlohy tohoto programátorského testu. Tato cena není USD za úlohu indexu AA a obě skóre spolu nesčítám.
| Model | Medium: skóre % | Medium: USD/úloha | Max: skóre % | Max: USD/úloha |
|---|---|---|---|---|
| GPT-6.1 Sol | 50,2 | 0,36 | 47,6 | 0,85 |
| GPT-6 Astra | 48,8 | 2,43 | 53,3 | 4,59 |
| Claude Opus 5.5 | 54,6 | 0,80 | 54,4 | 6,19 |
| Claude Sonnet 5.5 | 36,5 | 0,24 | 46,2 | 20,78 |
| GPT-6 Sol | 45,9 | 0,77 | 49,3 | 2,07 |
| GPT-6 Luna | 35,5 | 0,05 | 42,4 | 0,10 |
| Gemini 3.8 Flash | 41,2 | 2,60 | není v sadě | není v sadě |
Zdroj: Cognition, FrontierCode a jeho veřejná data, 30. 9. 2026. Skóre odpovídá poli new_score, nikoli correct (pass rate). Claude běží v Claude Code, GPT v Codexu a Gemini v Chisel. Cognition je výrobcem konkurenčního nástroje Devin.
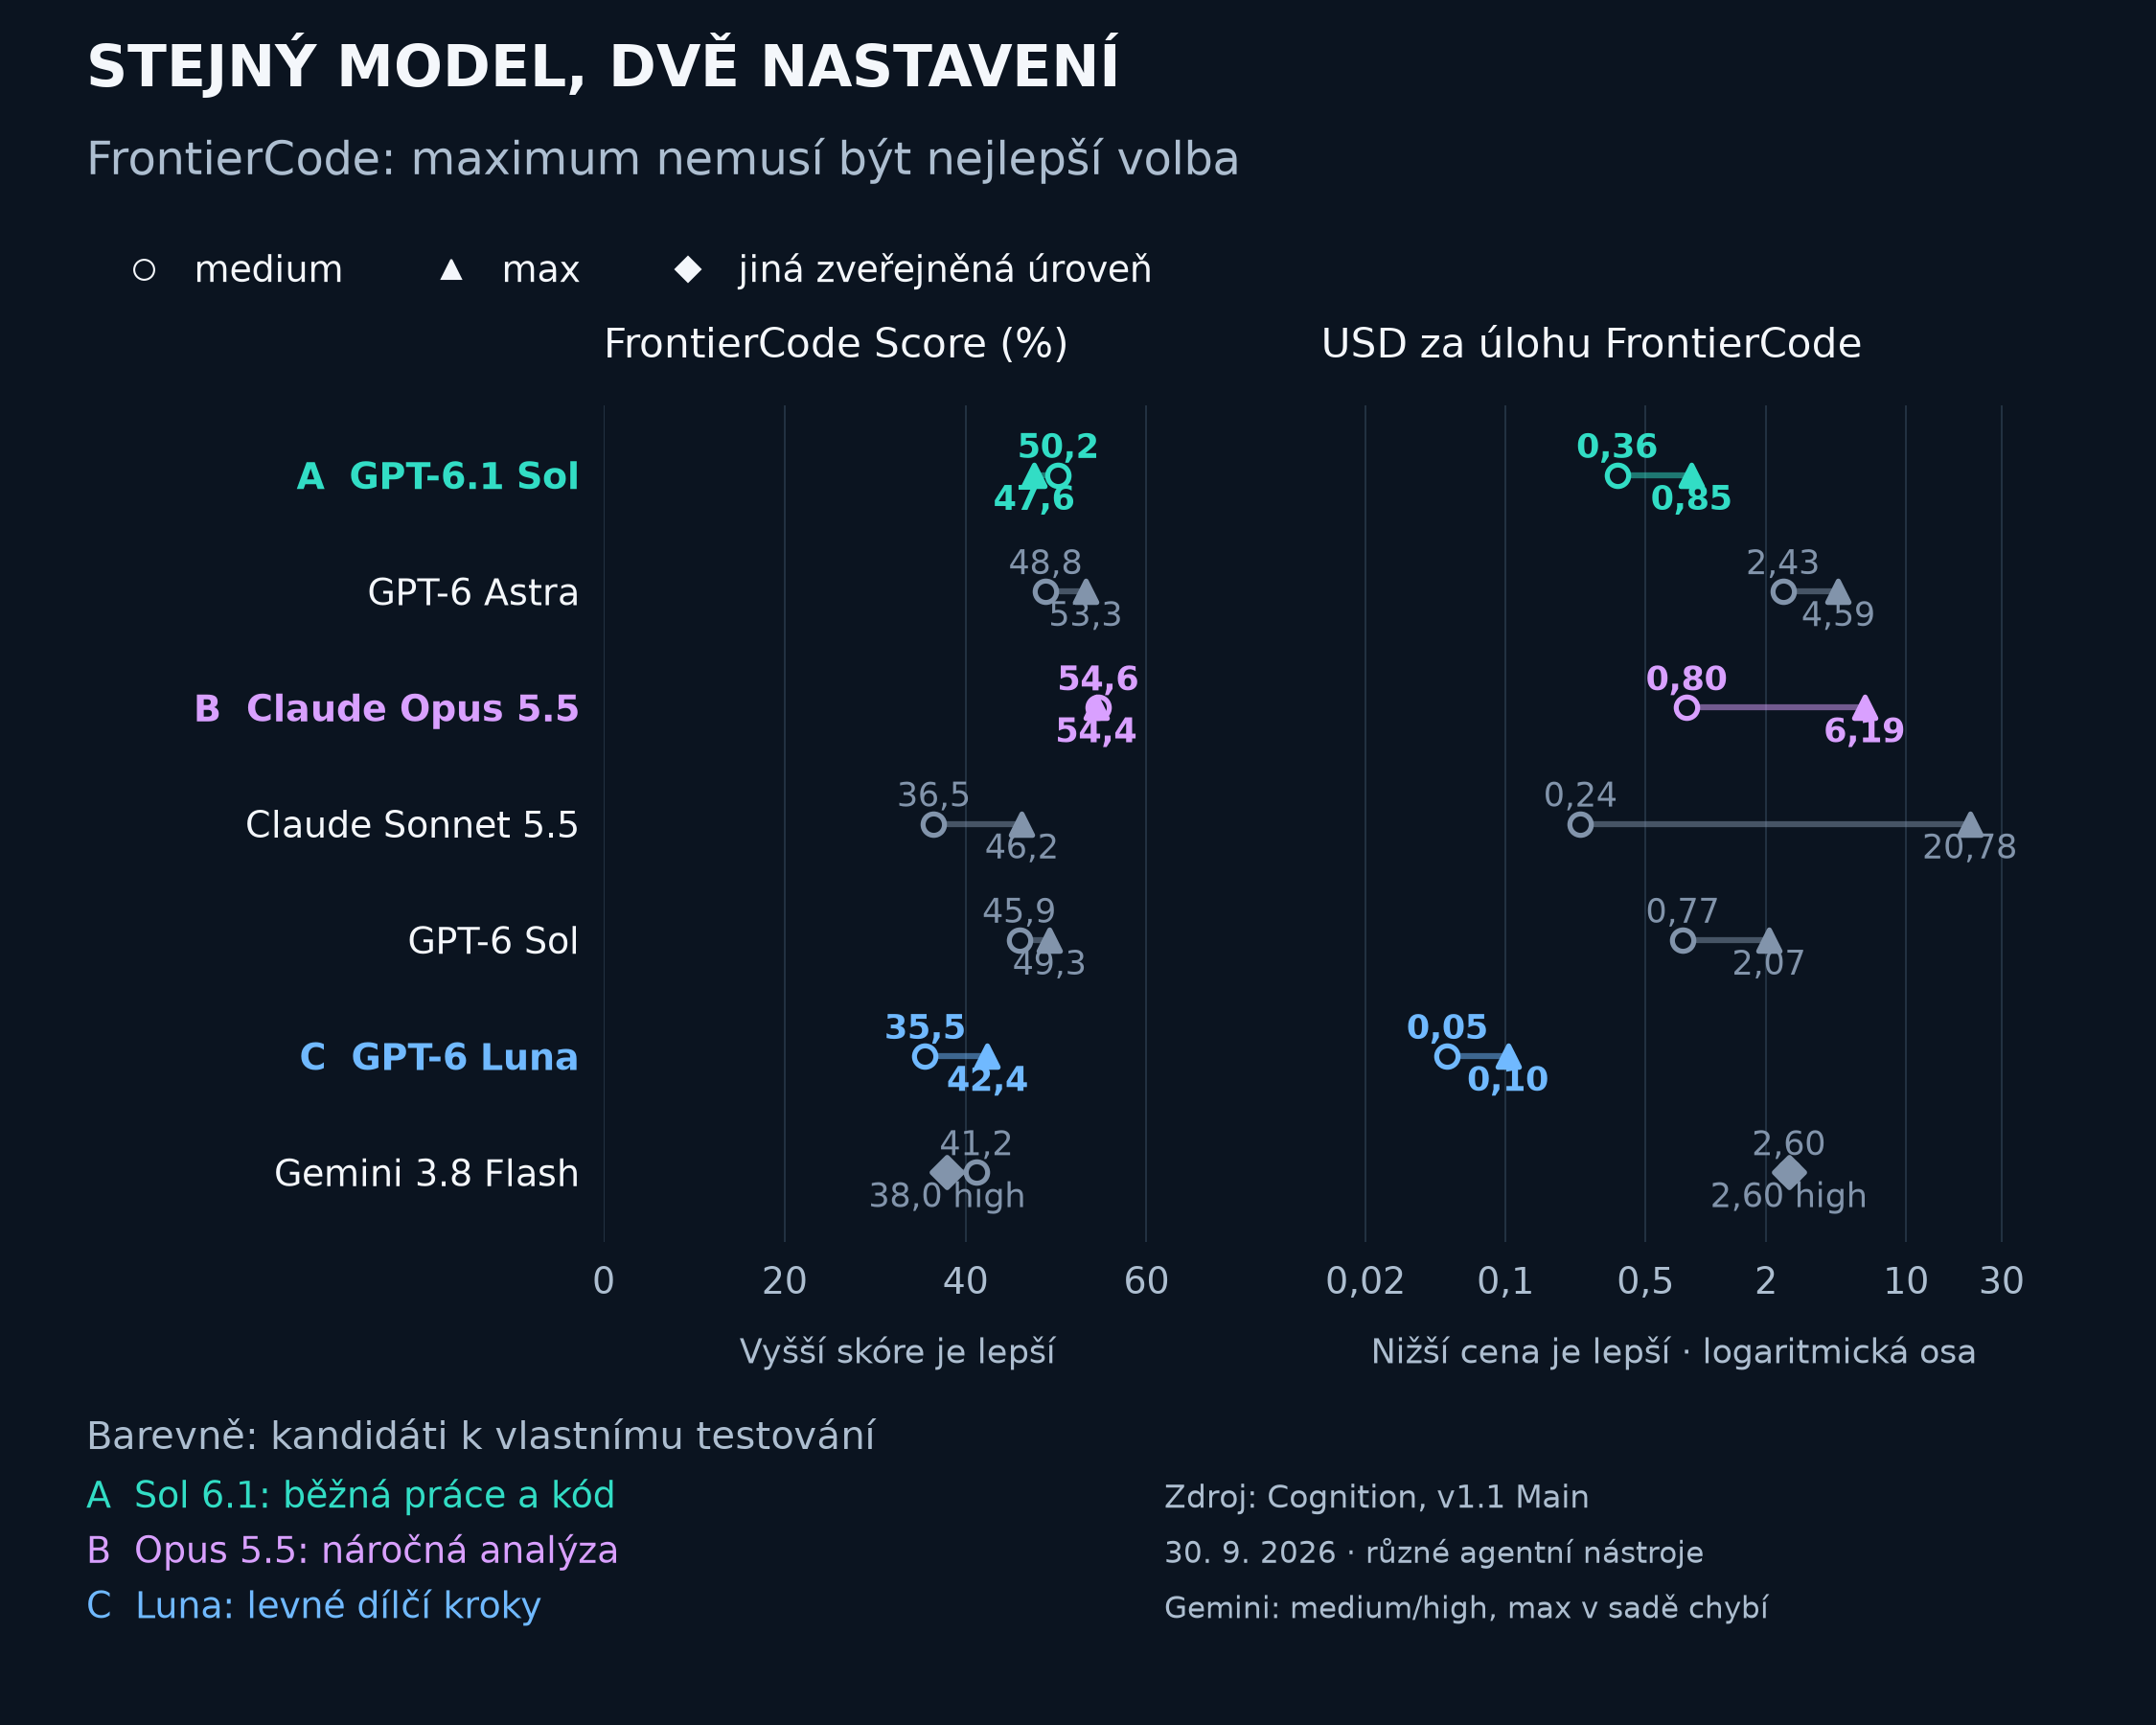
Otevřít programátorský graf · Stáhnout data FrontierCode jako CSV
Tady je dobře vidět, proč bych automaticky nezapínal maximum. Sol 6.1 medium má v této sadě 50,2 %, max 47,6 %. U Opus je medium prakticky na stejné úrovni jako max, ale výrazně levnější. To jsou výsledky této sady, nikoli důkaz, že delší přemýšlení obecně škodí.
Ani dvě krajní nastavení neukazují celý průběh: Sonnet 5.5 má na xhigh 52,1 % za 1,59 USD, zatímco max vychází na 46,2 % za 20,78 USD. Tento doplňkový údaj do sloupce max neschovávám. MiMo-V2.6-Pro v této sadě chybí; Gemini má medium a high, nikoli řádek max. Dostupný výsledek high je v přiloženém CSV.
Kde Sol šetří a kde zaostává: šest grafů OpenAI
Následující obrázky pocházejí z českého představení Solu 6.1. Jsou to grafy zveřejněné výrobcem. OpenAI měří své modely ve výzkumném prostředí nebo API a výsledky konkurence přebírá z veřejných zpráv. Nelze proto předpokládat, že každý bod vznikl ve stejném agentním prostředí jako ostatní.
V prvních pěti grafech hledáme body vysoko a vlevo: vyšší skóre při nižší ceně. U faktických chyb je lepší nízko a vlevo. Každý graf má vlastní stupnici a vlastní úlohy. Jejich procenta ani dolarové ceny se mezi sebou nesčítají.
Body zachycují různá nastavení přemýšlení, která v těchto statických obrázcích nejsou jednotlivě označená. Pro přímé porovnání medium s medium a max s max slouží tabulky výše. Zde je důležité číst celý průběh křivek. Pod každým rozbalovacím nadpisem je graf v původní podobě a můj komentář.
1. Programování: Sol se v DeepSWE blíží Astře za menší rozpočet
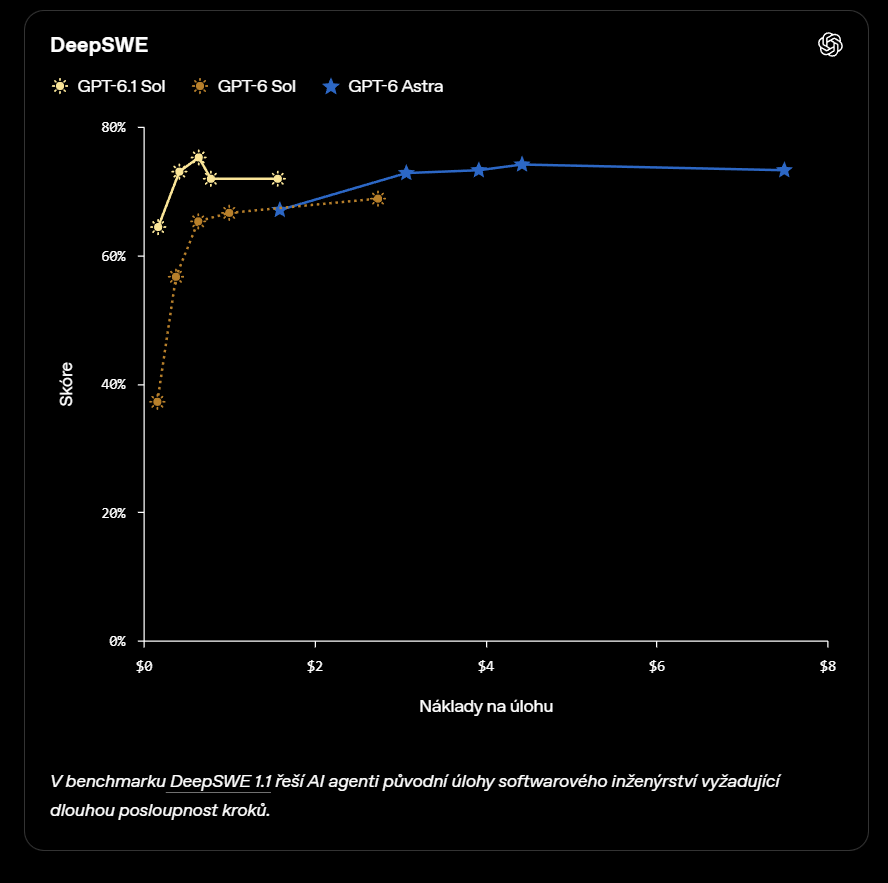
Graf: OpenAI. Zvětšit obrázek.
DeepSWE 1.1 zkouší původní úlohy v reálných repozitářích, které vyžadují delší práci. Žlutá křivka nového Solu v dodaném grafu dosahuje podobné výšky jako modrá Astra, přitom leží výrazně vlevo. To je zajímavý argument pro každodenní vývoj s omezeným rozpočtem.
Neznamená to vítězství v programování obecně. Graf neobsahuje Claude ani Gemini a výsledky FrontierCode výše vycházejí jinak: Opus 5.5 medium má vyšší skóre než obě konfigurace Solu 6.1. Pro můj repozitář by rozhodl vlastní test. Ani tady vyšší útrata nezlepšuje skóre při každém kroku.
2. Čtení PDF: zajímavá cena, ale pozor na svislou osu
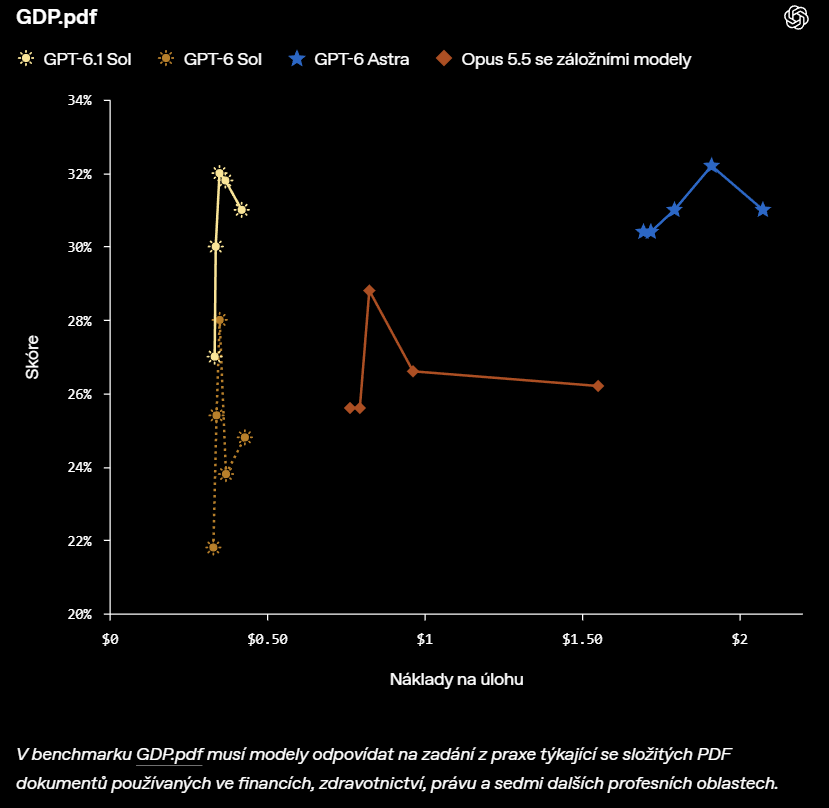
Graf: OpenAI. Zvětšit obrázek.
GDP.pdf prověřuje práci se složitými profesními dokumenty, včetně tabulek a diagramů. V tomto grafu nový Sol dosahuje přibližně 32 % při ceně pod půl dolaru, blízko nejvyššímu bodu Astry. Zobrazený Opus 5.5 se záložními modely je níže a stojí více. Pro opakovanou analýzu PDF je to dobrý důvod Sol vyzkoušet.
Svislá osa ale začíná na 20 %. Rozdíl výšek proto opticky působí větší než na ose od nuly. Skóre kolem 32 % navíc není potvrzením, že model spolehlivě přečte každý dokument. V praxi bych požadoval číslo stránky, původní údaj a kontrolovatelný výpočet. Ve veřejné tabulce Surge jsou také jiné konfigurace a hodnoty než v tomto obrázku; jejich čísla do něj nelze jednoduše přenést.
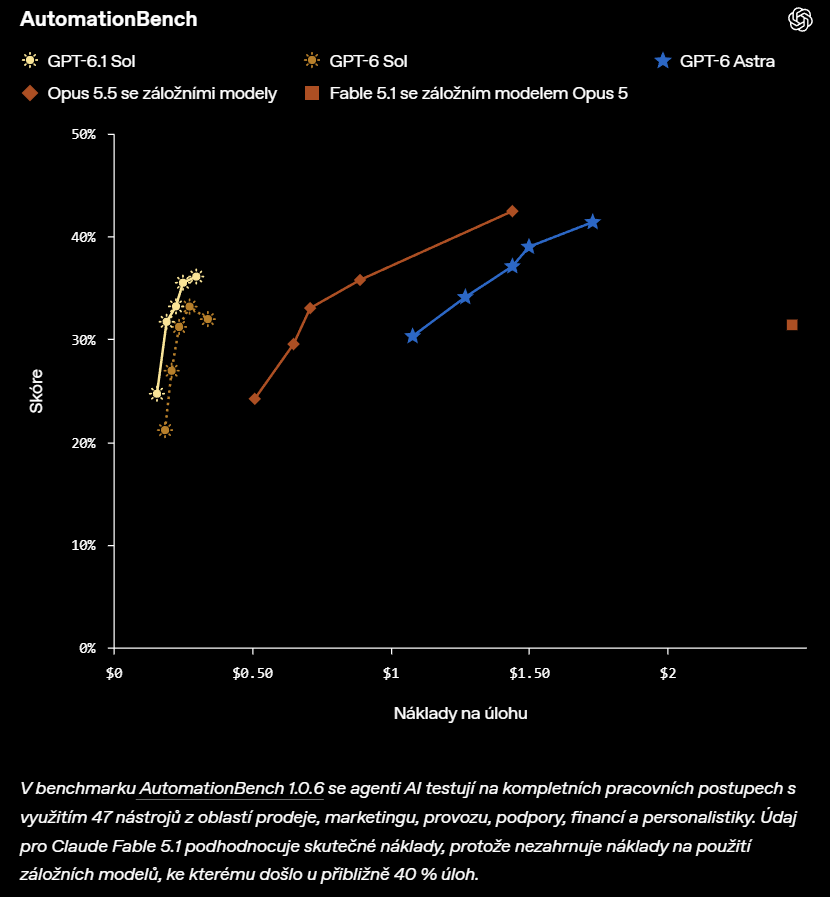
3. Firemní automatizace: Sol šetří, Claude může dosáhnout výš
Graf: OpenAI. Zvětšit obrázek.
AutomationBench kontroluje výsledný stav simulované firmy po práci agenta: zda správně upravil záznamy, vyhledal informace nebo doručil zprávu správnému příjemci. Sol má v grafu levnější použitelné body, nejvyšší skóre ale patří Opus 5.5 se záložními modely, nikoli Solu. Astra také dosahuje výše. Záleží, zda optimalizujeme rozpočet, nebo úspěšnost náročného postupu.
Ještě zajímavější je tabulka přímo od Zapieru, která k 30. září uvádí Sonnet 5.5 max se záložními modely: 44,75 % za 1,14 USD, Opus 5.5 max: 42,47 % za 1,44 USD a Astru max: 41,4 % za 1,73 USD. Sonnet v obrázku OpenAI vůbec není. Pro firemní automatizaci bych jej proto do vlastního výběru určitě přidal.
„Fallback“ zde znamená použití záložního modelu při odmítnutém kroku, ne prostě další pokus stejného modelu. U Fable 5.1 pomáhal Opus 5 přibližně ve 40 % úloh a jeho náklady v zobrazené ceně chybějí. Fable proto nelze podle tohoto bodu férově prohlásit za výhodnější ani dražší v určitém přesném poměru.
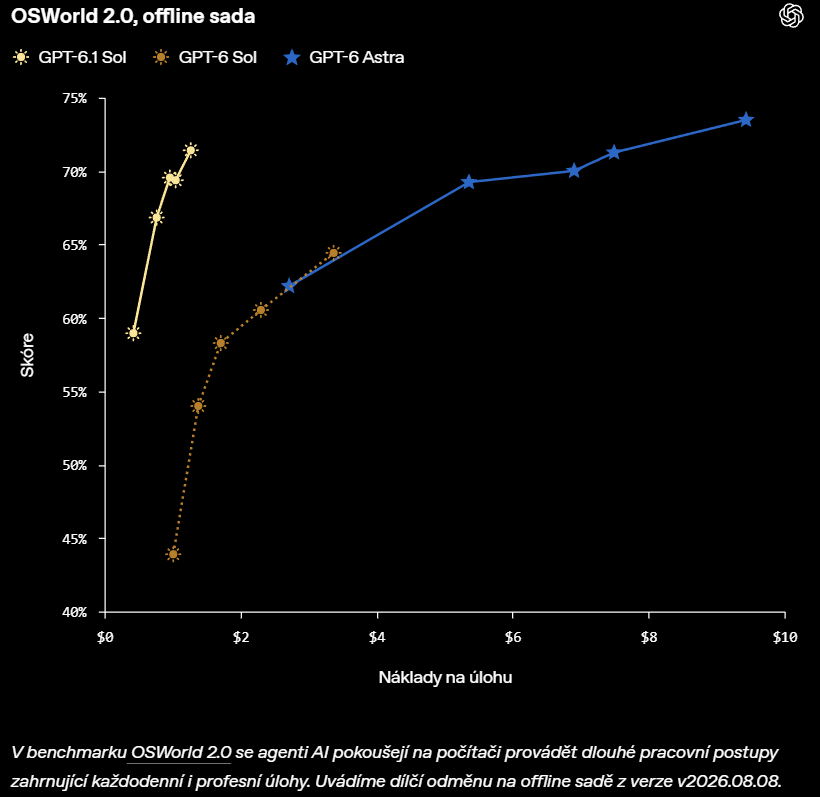
4. Ovládání počítače: vysoké dílčí skóre není počet hotových úloh
Graf: OpenAI. Zvětšit obrázek.
Sol se v přiloženém grafu dostává přibližně na 71,5 %, Astra na 73,6 %. Pro opakovanou práci s aplikacemi to vypadá jako zajímavá úspora. Nečtěme to ale jako „Sol samostatně dokončí sedm z deseti úkolů“. OpenAI zde ukazuje dílčí odměnu na offline sadě OSWorld 2.0 z verze v2026.08.08.
Autoři OSWorld rozlišují dílčí skóre a úplné dokončení. Agent může správně provést mnoho kroků a selhat v závěru. Pro nasazení bych proto měřil i hotové úlohy, zásahy člověka a chybné změny dat. Graf navíc nesrovnává Dots s jinými agenty a neobsahuje konkurenci mimo OpenAI.
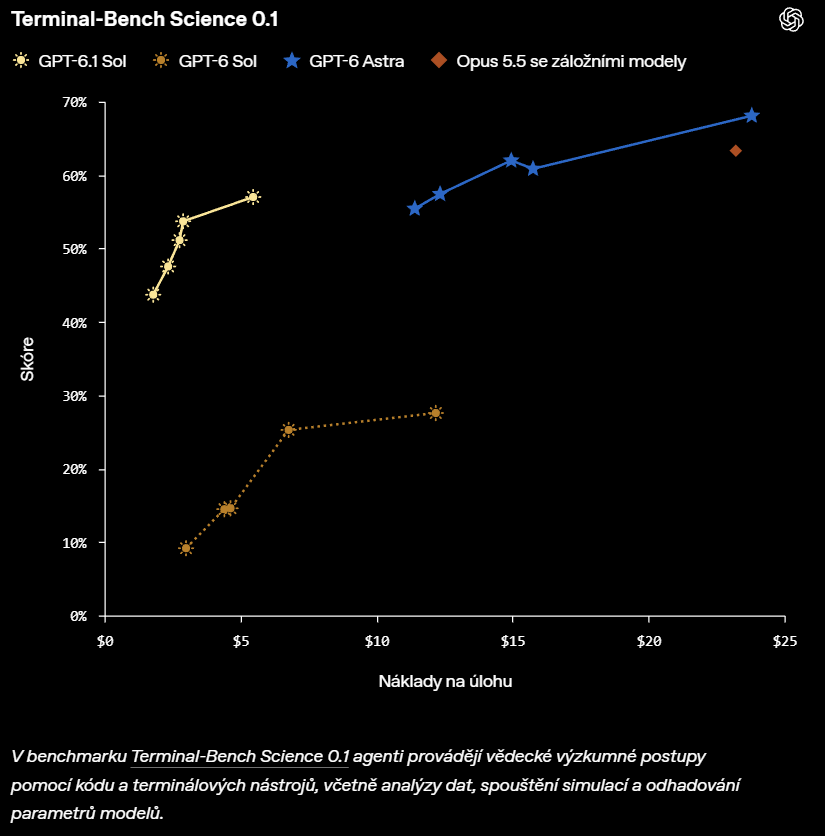
5. Vědecká práce: tady je náskok Astry stále vidět
Graf: OpenAI. Zvětšit obrázek.
Terminal-Bench Science míří na vědecké postupy s kódem a terminálem. V obrázku je Sol 6.1 výrazně nad starým Solem, ale na nejvyšší body Astry a Opus 5.5 se záložními modely nedosahuje. Tohle je konkrétní protiváha k heslu „Sol je jako Astra“.
Pro levnější průzkum dat nebo přípravu pomocných skriptů bych Sol zkusil. Pokud rozhoduje zvládnutí nejtěžší analýzy a chyba může stát dny práce, porovnal bych Astru a Opus. Nejvyšší skóre v tomto výběru má Astra. Nižší účet za API nemusí vyvážit čas ztracený nesprávným vědeckým závěrem.
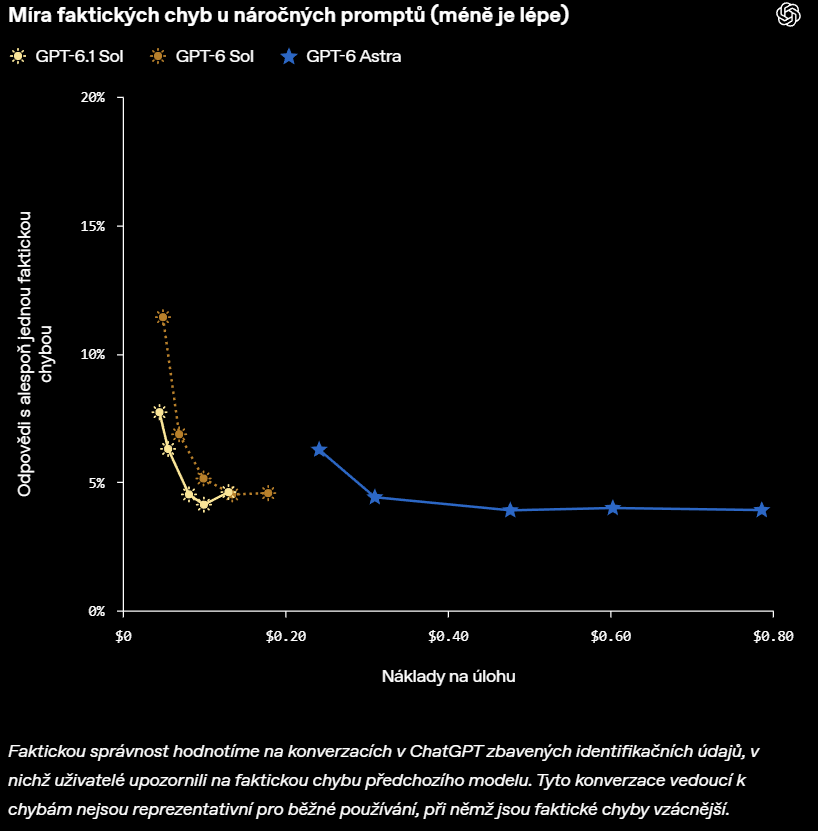
6. Faktické chyby: zlepšení na obtížných otázkách, nikoli záruka pravdy
Graf: OpenAI. Zvětšit obrázek.
V posledním obrázku je směr hodnocení obrácený: nižší křivka je lepší. Nový Sol se na vybraných obtížných otázkách dostává blízko Astře při nižší ceně. Jde však o podíl odpovědí s alespoň jednou faktickou chybou, nikoli o podíl chybných jednotlivých tvrzení.
Zadání pocházejí z konverzací, kde uživatelé upozornili na chybu předchozího modelu. Výběr tedy záměrně obsahuje problematické případy. Hodnotu okolo 4 % nelze přeložit jako „model má vždy 96% pravdivost“. Malé rozdíly mezi modely bych bez nejistoty měření nepřeceňoval. U důležitých faktů chci stále dohledatelný zdroj; konkurence mimo OpenAI v tomto grafu chybí.
Co bych podle toho vybíral
| Moje práce | První kandidát k ověření | Kdy zkusit jiný model |
|---|---|---|
| Běžný vývoj a opakovaná práce s dokumenty při omezeném rozpočtu | Sol 6.1 medium | Opus 5.5 medium, když potřebuji zvýšit kvalitu kódu; ve FrontierCode vyšel lépe. |
| Obtížná vědecká úloha | Astra, případně Opus | Sol pro levnější průzkum a dílčí kroky, pokud projdou kontrolou. |
| Vícekrokový firemní proces | Porovnat Sol se Sonnetem 5.5 a Opus 5.5 | Rozhodnout podle úspěšně dokončených procesů; u Claude započítat i záložní modely. |
| Velké množství jednoduchých, ověřitelných kroků | Luna nebo MiMo jako levnější kandidáti | Přesunout obtížné případy k Solu, Opus nebo Astře. |
Tohle je moje interpretace uvedených měření, nikoli univerzální pořadí. Pro češtinu, vlastní dokumenty a konkrétní nástroje potřebujeme vlastní ověření. Sol má velmi zajímavý poměr schopností a ceny. Z dat ale nevychází, že by byl nejlepší na všechno.
Pětkrát levnější tokeny nejsou pětkrát levnější projekt
DevDay čtu hlavně jako sázku na dostupnější výkon, který se vyplatí používat každý den. Pokud levnější model zvládne naši úlohu stejně spolehlivě, můžeme si dovolit nasadit AI i tam, kde se dosud ekonomicky nevyplácela. U Solu bych proto sledoval hlavně to, kolik použitelných výsledků přinese za daný rozpočet. Tvrzení „stejný výkon jako Astra za pětinu ceny“ bych bral opatrně: cena tokenů má jasný poměr, shoda výkonu záleží na úloze a nastavení.
Standardní API ceník GPT-6.1 Sol uvádí 2 USD za milion vstupních a 10 USD za milion výstupních tokenů, čtení z cache 0,10 USD. Astra má standardní vstup a výstup za 10 a 50 USD. Sol v API dokumentaci, srovnání modelů
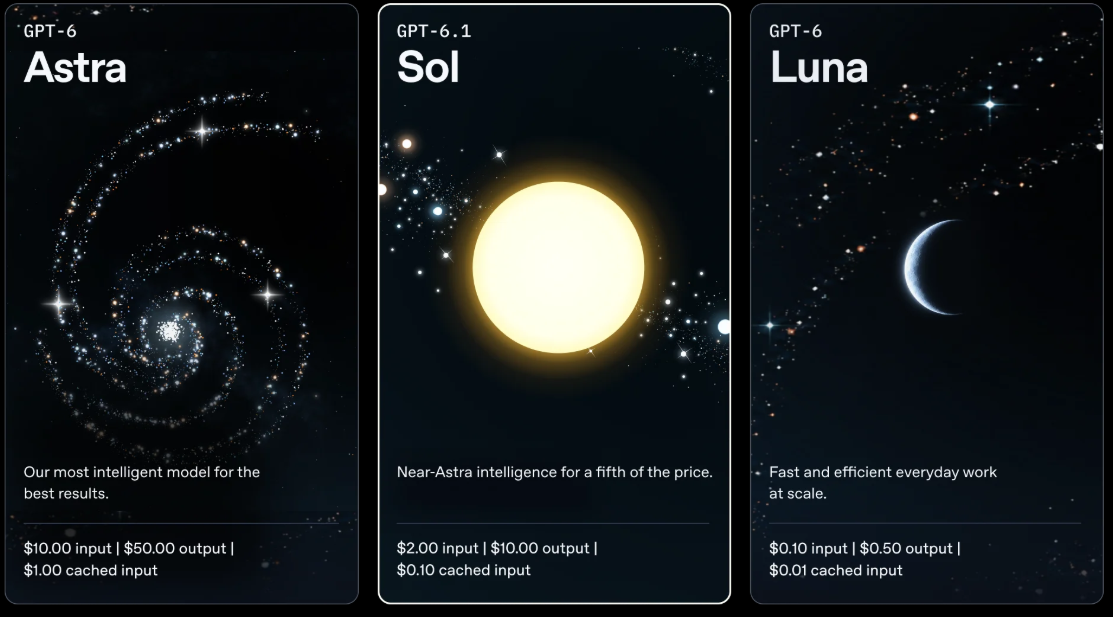
Oficiální produktové rozdělení OpenAI. Částky v kartách jsou USD za milion tokenů, nikoli za úlohu ani za předplatné. Texty v kartách jsou tvrzení výrobce; srovnání s konkurencí najdete výše. Zdroj · Zvětšit obrázek.
Modelový výpočet: 100 tisíc nezacachovaných vstupních a 10 tisíc celkových účtovaných výstupních tokenů vyjde na 0,30 USD u Solu a 1,50 USD u Astry. Počítám standardní režim, bez nástrojových poplatků a dalších příplatků. Agent ale může udělat deset kroků, spustit další pracovníky, opakovat chybu nebo vyprodukovat mnoho interních reasoning tokenů. Ty je třeba zahrnout do výstupu.
Moje užitečnější metrika je proto cena přijatého výsledku: celkové výdaje za všechny pokusy dělené počtem výstupů, které projdou kontrolou. Vedle toho měřím svůj čas na opravy. Levná odpověď, kterou půl hodiny předělávám, pro mě levná není.
Pro vývojáře má Sol ještě několik důležitých detailů. Podporuje přemýšlení od low po max, výchozí je medium. Pro volání nástrojů je potřeba Responses API, samotná změna názvu modelu ve staré integraci s Chat Completions nestačí. Nad 272 tisíc vstupních tokenů se mění sazby celého požadavku. Milionový kontext tedy není pozvánka posílat pokaždé celý archiv. Technické parametry a cenové hranice
Dots v Česku: záleží na tarifu, ne jen na mapě
Dots jsou průběžně pracující agenti pohánění GPT-6 Astra. Mají vlastní cloudový počítač, kontext a připojené aplikace. Smyslem je zadat dlouhodobou odpovědnost a nechat je vracet se s výsledky. OpenAI uvádí propojení s více než 4 000 aplikacemi přes ekosystém pluginů. To neznamená, že Dot od začátku vidí všechny vaše účty nebo zvládne každou operaci v každé aplikaci. Konkrétní připojení a oprávnění mu musíte zpřístupnit. Představení Dots
Barevní maskoti z oficiálního představení Dots. Vizuál: OpenAI. Zdroj obrázku a oznámení.
U dostupnosti je ovšem zásadní drobné písmo:
| Kde chci Dots používat | Stav při spuštění |
|---|---|
| Osobní Pro v Česku | EHP je z úvodního zavádění vynechané, stejně jako Švýcarsko a Británie. |
| Business Premium | Dokumentace uvádí všechny podporované regiony ChatGPT. Není to totéž jako běžný Business tarif. |
| Enterprise, Edu, Healthcare | Beta vyžaduje povolení správce; standardně je vypnutá. Podmínky ověřte ve svém workspace. |
Zdroj: Getting started with your dot. Zavádění může trvat několik dní. Vytvoření Dota je zatím na desktopu nebo desktopovém webu, ne na mobilním webu.
VPN bych nepovažoval za spolehlivé řešení. Změna IP adresy sama neprokazuje oprávnění účtu ani zpřístupnění funkce. Nemám ověřený postup, který by Dots na českém osobním Pro garantovaně zprovoznil. Oficiálně doložená cesta pro Česko vede přes způsobilý firemní tarif a jeho nastavení; před nákupem bych ověřil dostupnost konkrétního účtu.
Kdo nechce měnit tarif, může zatím řadu konkrétních úloh řešit přes Work, Codex nebo vlastní automatizaci nad API. Není to úplná náhrada Dota. Často ale potřebujeme spíš každé ráno zkontrolovat tři zdroje než dalšího virtuálního kolegu, kterému svěříme úplně všechno.
Dots, Hermes a OpenClaw: co získám navíc k API klíči?
Když už používáte Hermes nebo OpenClaw, samotný příslib paměti a práce na pozadí vás asi nepřekvapí. Model rozhoduje, agentní software mu poskytuje nástroje, paměť a způsob práce. Připojit silný model přes API k Hermesovi proto skutečně může vytvořit podobného pomocníka. Klíč ovšem sám nepřidá vaše dokumenty, přihlášení do služeb ani spolehlivý provoz.
| Co řeším | Dots | Hermes Agent | OpenClaw |
|---|---|---|---|
| Model | GPT-6 Astra podle OpenAI | Volitelný poskytovatel a model | Volitelný poskytovatel a model |
| Provoz | Cloudové prostředí spravuje OpenAI | Vlastní počítač, server nebo hosting | Vlastní počítač, server nebo hosting |
| Paměť | Kontext z ChatGPT a vlastní poznámky | Uložená paměť, historie, pracovní postupy | Paměťové soubory ve vlastním prostoru |
| Opakovaná práce | Plánované úkoly a průběžná práce | Plánovač, nástroje, další agenti | Plánovač, události, chatovací kanály |
| Úpravy | V mezích funkcí služby | Konfigurace i otevřený zdrojový kód | Konfigurace i otevřený zdrojový kód |
| Náklady | Způsobilý tarif a jeho pracovní limity | Model, případný hosting a údržba | Model, případný hosting a údržba |
Srovnání podle dokumentace Dots, Hermes a OpenClaw. Nejde o vlastní test jejich spolehlivosti.
Výhoda Dots je hotové propojení. Nemusím skládat cloudový počítač, připojené aplikace a návaznost na ChatGPT. Samovolná proaktivní rešerše ale používá nástroje pouze ke čtení; to není totéž jako zadaný úkol, kterému výslovně povolím konkrétní akce. První Dot je součástí způsobilého tarifu, náročnější práce má limity. Dostupnost 24/7 tedy neznamená neomezené výpočty. Fungování a limity Dots
Výhoda vlastního agenta je volnost. U Hermese můžu zkoušet různé modely, napojit vlastní nástroje a prohlédnout uloženou paměť. Jeho učení zahrnuje ukládání zkušeností a pracovních postupů, nikoli automatické přetrénování modelu. OpenClaw zase stojí za pozornost při propojování asistenta s různými chatovacími kanály. Oba ale vyžadují péči o provoz a oprávnění. Funkce Hermes, paměť OpenClaw
Vlastní server také automaticky neznamená soukromý výpočet. Pokud agent volá cloudový model přes API, posílá mu obsah potřebný k vyřešení úlohy. Záleží na zvoleném poskytovateli, nástrojích a jejich pravidlech pro data.
Ani stejný model nezaručuje stejný výsledek. Výzkum WildClawBench z května ukázal změnu skóre stejného modelu až o 18 procentních bodů jen při výměně agentního prostředí. Dots netestoval. Přímý srovnatelný benchmark Dots proti Hermesovi nebo OpenClaw jsem k 30. září nenašel, takže bych žádného vítěze nevyhlašoval.
Praktická novinka: někdy už nepotřebujete API klíč
OpenAI nyní uvádí Hermes Agent a OpenClaw mezi podporovanými integracemi Sign in with ChatGPT. Pokud dané připojení nabízí využití tarifu, můžete povolit čerpání z předplatného Plus nebo Pro. Spotřeba se počítá do stávajících limitů Work/Codex, nevzniká nový balík zdarma. V Settings → Usage lze aplikaci omezit týdenním podílem. Samotné přihlášení nepředává historii chatů ani paměť ChatGPT. Oficiální seznam integrací a pravidla
Pro experimenty s modely a vlastními postupy mi proto dává smysl Hermes. Pro běžnou asistenci bez správy serveru chci vyzkoušet Dots. Rozhodující pro mě bude počet použitelných výsledků a čas, který strávím opravami.
Tři úlohy, na kterých bych Dota vyzkoušel
Následují návrhy konkrétních zadání, nikoli moje již ověřené výsledky s Dots. Počítají s připojenými zdroji a potřebnými oprávněními. U každého chci na konci něco, co lze snadno zkontrolovat.
1. Ranní příprava na schůzky
Každý pracovní den v 7:30 podle času Europe/Prague projdi můj připojený kalendář a související e-maily. Pro dnešní schůzky připrav stručný podklad: účastníci, poslední domluva, otevřené otázky a odkazy na zdroje. Chybějící informaci označ. Nic neodesílej a schůzky nepřesouvej. Potvrď uložený rozvrh.
Hodnotil bych, jestli podklad odpovídá skutečné domluvě a jestli se z něj během dvou minut připravím. Na pouhé upozornění v 7:30 stačí připomínka. Přidanou hodnotou agenta má být propojení měnících se podkladů.
2. Rešerše, která udržuje krok s novými výsledky
Každé pondělí projdi tyto konkrétní zdroje k výběru a fúzi jazykových modelů. Připrav nejvýše pět nových relevantních prací, ke každé odkaz, metodu, omezení a jeden návrh experimentu. Porovnej je s přiloženým seznamem už přečtených studií. Pokud není nic podstatného, napiš to. Názvy ani výsledky nedoplňuj odhadem.
Tady bych sledoval hlavně dohledatelnost zdrojů, duplicity a to, zda návrh experimentu skutečně souvisí s mojí otázkou. Hodnota je v udržovaném kontextu, ne v délce ranního seznamu odkazů.
3. Od hlášení chyby k opravě na kontrolu
Každý pracovní den zkontroluj určený kanál s hlášeními chyb. Vyber jednu reprodukovatelnou drobnou chybu v kontaktním formuláři a ověř, že pro ni ještě není otevřená oprava. V připraveném Codex cloudovém prostředí založ samostatnou větev, připrav opravu, spusť relevantní ověření a vrať návrh změn se screenshotem. Nenasazuj ho a neměň jiné části webu.
Nejprve je potřeba připravit repozitář a cloudové prostředí. Připojení aplikace samo o sobě nevytváří hlídání událostí. Pokud chci reakci hned po novém hlášení, nechám si potvrdit, zda to konkrétní integrace podporuje; jinak zadám rozvrh. Úlohy, plánování a Codex prostředí pro Dots
Po týdnu bych zapsal, kolik úloh Dot správně dokončil, kolikrát jsem musel zasáhnout a kolik spotřeboval limitu. Stejná zadání lze zkusit s Hermesem nebo OpenClaw. Na předem naplánované úlohy nemusí být Dot automaticky nejlepší volba.
Co říkají první uživatelé Dots
Doplněno 30. září: jde o jednotlivé veřejné ohlasy z prvního dne po uvedení. Diskuse nejsou reprezentativní průzkum, účty nemají nutně stejné funkce a podmínky testů neznáme. Rozlišuji popsanou zkušenost od očekávání.
Co se líbí: v diskusi na r/codex autor i přes celkovou kritiku chválí kvalitu hlasu. Jiný uživatel tam píše, že mu Dot pomáhá s připomínkami a sledováním poznámek v Obsidianu a e-mailů. V další diskusi přitahuje autora návaznost na ChatGPT, který už dlouho používá a který zná jeho kontext. Poslední bod je očekávaná výhoda, nikoli doložený výsledek dlouhodobého testu Dots.
Co zatím drhne: autor první diskuse popisuje i více než pětiminutové čekání na jednoduché úkony, potíže s cloudovým prohlížečem a ovládáním počítače. Jsou to jeho pozorování, ne změřená průměrná latence služby. Pro práci na pozadí může být čekání přijatelné; pokud se úloha zasekne a potřebuje moje vedení, její přínos rychle klesá.
Uživatel, který porovnával Dots se svou sestavou Hermes, oceňuje u Hermese volbu modelu a vlastní úpravy. U Dots popisuje odmítnuté použití své integrace s uloženými přihlašovacími údaji. Z této zkušenosti bych ale nedělal obecné tvrzení, že Dots neumějí vlastní integrace nebo MCP. Konkrétní propojení je potřeba ověřit včetně přístupů a pravidel účtu.
V jednom z uživatelských shrnutí, které se ke mně dostalo, se Dots srovnávají také s Grokem. Je to zajímavá asociace kolem osobního AI asistenta. Sama ale neříká, zda stejně fungují paměť, práce na pozadí nebo připojené nástroje. Ty bych porovnával na stejných zadáních, podobně jako výše u Hermese a OpenClaw.
V diskusi o dostupnosti se objevuje i čekání na aktivaci u placených účtů. To podporuje praktickou radu: před změnou tarifu ověřit konkrétní účet. Není to důkaz, že oficiálně podporovaná země má plošný zákaz.
Můj průběžný dojem: nejpřesvědčivější první použití jsou drobné opakované povinnosti. Schopnost dlouhodobě a spolehlivě vést složité projekty musí teprve ukázat více zkušeností. Vedle chvály nebo kritiky bych chtěl znát i zadání, připojené nástroje, výsledek a nutné zásahy člověka.
Ještě jeden užitečný detail z dokumentace: pozastavit Dota, zastavit jím vytvořenou úlohu a zrušit rozvrh jsou tři různé věci. Při zkoušení kontrolujte Activity i Scheduled; samotné Pause nezastaví každou delegovanou úlohu ani budoucí běhy. Ovládání a zastavení Dots
Space, Pages a Decisions: méně efektní, ale možná důležitější
Space je domov pro stránky a soubory, který u způsobilých účtů nahrazuje Library. Pages jsou sdílené pracovní dokumenty. Pro, Business a Enterprise je mohou vytvářet a upravovat na webu a desktopu; na mobilu zatím hlavně číst a sdílet. Společné úpravy prezentací a tabulek jsou teprve ohlášené. Dostupnost a fungování Space
Pro můj způsob práce je zajímavá kontinuita. Mít jednu průběžně opravovanou rešerši je užitečnější než pět chatů s pěti mírně odlišnými závěry. U sdílení bych ale vždy zkontroloval výslednou stránku: soukromý chat se tím sám nesdílí, jeho obsah se však může dostat do textu dokumentu.
Decisions API jde opačným směrem než všeobecný agent. Nad Lunou nabízí rozhodování mezi předem určenými odpověďmi. Například: je tento požadavek dotaz na cenu, technická podpora, nebo reklamace? Při oznámení jde o omezený preview přístup, ne o službu automaticky dostupnou každému. Oznámení Decisions API
Ve stejném uživatelském shrnutí se objevuje srovnání Decisions API s JEV od TypeSafe. Pro mě je to dobrý námět: JEV už používám v Atlasu jako pomocníka při rozhodování, kdy stačí levnější model, a zkoušel jsem ho i ke kontrole hotových odpovědí. O těchto pokusech píšu v navazujícím článku z 30. září o třech měsících na LUMI. Společné téma je rychlé specializované rozhodování; srovnatelnou přesnost, cenu a latenci obou služeb zatím změřené nemám.
Tohle mě zajímá pro směrování práce. Jednoduché požadavky může řešit levnější model, složité přeposlat silnějšímu. Zda to bude výhodnější než běžný malý model se strukturovaným výstupem, zatím bez vlastního měření ceny, latence a chyb nerozhodnu. Do návrhu bych přidal také možnost „nevím, předej člověku“, jinak systém nutíme sebevědomě zařadit i nesrozumitelný vstup.
Agents API a MCP Events: méně vlastní infrastruktury, více práce podle událostí
Agents API zpřístupňuje běhové prostředí Codexu jako spravovanou službu. OpenAI udržuje stav úlohy, koordinuje práci a zkracuje kontext; vývojář připojuje vlastní nástroje a volí prostředí. Podpora ovládání počítače přidává například práci v hostovaném prohlížeči. Není to automatický přístup do vašeho notebooku. Model, nástroje a hostované prostředí mají své účtování. Agents API
MCP Events řeší, kdy má práce začít. Představte si zadání: „Když na projektové nástěnce přibude hlášení chyby, projdi podklady a připrav návrh opravy.“ Aplikace pošle událost, ChatGPT zareaguje podle domluvených instrukcí. Nemusí jen pravidelně kontrolovat, zda se něco změnilo. Specifikace zatím není definitivní standard, ale dokumentace ChatGPT už popisuje podporu webhooků pro MCP 2.0. Konkrétní plugin musí události implementovat; samotné připojení aplikace tuto schopnost nezaručuje. MCP Events a podporované doručování
Pro mě jsou tyto dvě novinky zajímavé dohromady: událost spustí úzce vymezenou práci a agent připraví výsledek ke kontrole. Začal bych návrhem odpovědi nebo opravy, u kterého snadno poznám, zda se povedl.
Co se zlepšuje v Codexu
Prakticky mi dává největší smysl připravené cloudové prostředí. Jednou nastavit instalaci závislostí a ověření projektu, potom zadávat samostatné úlohy a přebírat výsledky. Cloudová práce nemusí čekat na otevřený notebook; práci na připojeném místním počítači ale nelze zaměňovat za cloudovou. Dokumentace Codex Cloud
Z dalších oznámení stojí za pozornost obnovené CLI s hlasovým zadáváním a přehledem /agents, nový přehled code review a Codex Security Cloud, který hledá problémy v repozitářích a připravuje opravy. Na vývojářské straně přibývá Agents API s ovládáním počítače a hostovaným prostředím. Oficiální přehled funkcí a tarifů
Nechal bych Codex například souběžně prověřit tři oddělené chyby. Každé zadání by mělo mít vlastní větev, jasné hranice změn a ověřitelnou podmínku dokončení. Výsledkem má být kontrolovatelná úprava, ne jen zpráva „hotovo“. U bezpečnostního skenu bych chtěl i postup reprodukce a vysvětlení, proč navržená oprava problém skutečně řeší.
Ultrafast kupuje rychlost, ale také rychleji čerpá limit
Při uvedení OpenAI u Astry uvádí až 300 tokenů za sekundu, až 8× rychlejší generování v Codexu a až 6× v API. Jde o údaje výrobce, nikoli garantovanou rychlost každého požadavku. Aktuální průvodce API už obecně uvádí až 8× proti Standardu, takže bych tyto násobky vždy četl spolu s konkrétním zdrojem a podmínkami měření. Nejde o stejně velké zrychlení celé práce. Čekání na testy, síť nebo vaše rozhodnutí zůstává. Čísla z oznámení DevDay, aktuální průvodce API
Ve Work a Codexu je režim dostupný na Pro 500 za 500 USD měsíčně a způsobilých Enterprise/Edu tarifech. API má samostatné účtování a vlastní limity, předplatné Pro 500 k němu nepotřebujete. Ultrafast pro GPT-6.1 Sol je zatím teprve ohlášený. Dostupnost a čerpání limitů, podporované režimy Solu
Kolik je to tokenů za sekundu? U Astry máme následující vodítka. Nejde o jeden společný test: rozlišuji měření API, podmíněný odhad a údaj výrobce pro Codex. Přesnou trojici rychlostí naměřenou ve stejném Codexu na stejných úlohách jsem nenašel.
| GPT-6 Astra: režim | Rychlost generování a původ údaje | Čerpání limitu | Čerpání kreditů |
|---|---|---|---|
| Standard | Asi 50 tokenů/s v API. AA u max uvádí 51,2; průběžně měřený údaj. | 1× | 1× |
| Fast | Při 2× zrychlení asi 100 tokenů/s v API. Výpočet z 50 × 2, nikoli vlastní měření ani garance. | 2,5× | 2× |
| Ultrafast | Až 300 tokenů/s v Codexu. Údaj OpenAI při uvedení. | 8× | 6× |
Rychlost Standardu: Artificial Analysis, Astra max, odečteno 30. 9. 2026. Pro Astru Fast výrobce uvádí až dvojnásobnou rychlost v API. Poslední dva sloupce platí pro spotřebu ve Work/Codexu podle dokumentace rychlostních režimů. API rychlost se do aplikace nemusí přenést a 2,5× čerpání neznamená 2,5× rychlejší psaní.
Pro představu: samotné vygenerování 3 000 tokenů při 50, 100 a 300 tokenech/s trvá 60, 30 a 10 sekund. To je početní příklad, ne slib času dokončení. Nezahrnuje čekání na první token, další přemýšlení, nástroje ani testy. Token navíc není totéž co slovo.
Ultrafast není dostupný pro workspace vyžadující zpracování inference mimo USA; samotné sídlo firmy rozhodující není.
Když mě čekání blokuje, příplatek může dávat smysl. Pro noční úlohu bych začal se Standardem. Také bych rozlišoval rychlost a hloubku přemýšlení: Ultrafast a maximální reasoning jsou dvě různé volby.
Kterou Astru OpenAI vlastně pozastavilo?
Tady se snadno spletou názvy. Zpráva se týká připravované GPT-6.1 Astra. Podle vyjádření šéfky bezpečnostních systémů OpenAI pro média model nesplnil požadovanou úroveň bezpečnosti, mimo jiné v respektování oprávnění a rozsahu práce. Jeho vydání bylo odloženo. Zpráva AP s vyjádřením OpenAI
Dosavadní GPT-6 Astra zůstává v nabídce a pohání i Dots. Vedle toho existuje samostatná bezpečnostní kontrola, která může pozastavit nebo ukončit konkrétní konverzaci, pokud vyhodnotí možné překročení zadání. Takové zastavení není samo o sobě důkazem, že model opravdu pochybil. Vysvětlení bezpečnostních kontrol
Pro mě je to připomínka, že schopnost úkol dokončit a schopnost zůstat v jeho mezích jsou dvě odlišné vlastnosti. Když modelu zadám opravit formulář, nechci, aby si k tomu přestavěl celý web nebo měnil oprávnění. Vlastní testování agentů proto musí měřit i dodržení zadání, ne pouze to, zda výsledek funguje.
Přišlo 62 500 kreditů. Co je za tím?
Doplněno 30. září. I mně přišla zpráva o kreditech. Není to ale důvod přehlédnout změnu dlouhodobých podmínek.
OpenAI potvrzuje, že způsobilým stávajícím předplatitelům Pro 200 zachová původní limity do 29. října, poté přejdou na nižší zahrnuté využití. Cena zůstává 200 USD měsíčně. A už existuje také Pro 500 za 500 USD měsíčně, včetně přístupu k Ultrafast. Aktuální podmínky Pro
Konkrétní rozpis rozesílaného oznámení, který zveřejnili také další předplatitelé, uvádí tyto změny a přechodové podmínky:
- Od 30. října 2026 Work a Codex u dotčeného Pro 200: z 20násobku na 10násobek zahrnutého využití Plus.
- Od téhož data GPT-6 Pro v běžném Chatu: z 200 na 100 zpráv týdně.
- Jednorázově 62 500 kreditů, oznámením oceněných na 2 500 USD, s expirací 31. prosince 2026.
- Pro 500: 25násobek využití Plus. Je to násobek kapacity, nikoli počet úspěšně dokončených úkolů.
Tyto podrobnosti popisují přechodovou nabídku pro dotčené účty. Nepovažoval bych je za příslib stejného bonusu každému novému předplatiteli.
Kredity nejsou peníze na účtu ani univerzální API kredit. Nejdříve se spotřebovává zahrnuté využití, poté kreditní zůstatek pro podporované funkce. Stav a podmínky najdete v ChatGPT v Settings → Usage, v Codexu v Usage & Billing. Platnost konkrétního propagačního balíku je potřeba odlišit od běžně koupených kreditů. Pravidla kreditů
Jaké tarify existují a vůči čemu se počítá 20×
Základem násobků je zahrnuté využití ChatGPT Plus ve Work a Codexu. Původní Pro 200 měl 20× tuto kapacitu. Neznamená to 20× rychlejší odpověď, 20× lepší model ani dvacetkrát více všech funkcí běžného Chatu. Work a Codex čerpají společný rozpočet; jeho velikost také není pevný balík dolarů nebo tokenů. Jak se využití sdílí
| Tarif | Referenční cena v USD | Co znamená pro Work a Codex |
|---|---|---|
| Free | 0 | Omezené využití, v desktopu Luna Standard podle zavádění. Bez Codex Cloud. |
| Go | 8 měsíčně | Více běžných funkcí Chatu, lehká práce s Lunou Standard. Bez Codex Cloud. |
| Plus | 20 měsíčně | Základ 1×, přístup k Solu a Astře; kratší i týdenní limity. |
| Pro 100 | 100 měsíčně | 5× Plus, bez pětihodinového limitu. |
| Pro 200 | 200 měsíčně | 10× Plus pro nové předplatitele; způsobilí stávající mají 20× do 29. října. Bez pětihodinového limitu. |
| Pro 500 | 500 měsíčně | 25× Plus, bez pětihodinového limitu, navíc Astra Ultrafast. |
| Business Standard | 25 za osobu měsíčně; 20 při roční platbě | Týmové prostředí; zveřejněné orientační počty lokálních zpráv odpovídají Plus. |
| Business Premium | 125 za osobu měsíčně; 100 při roční platbě | 5× Business Standard, bez pětihodinového limitu. Tento násobek se vztahuje ke Standard místu. |
| Enterprise / Edu | Individuální nabídka | Kapacita, účtování a funkce podle smlouvy a nastavení organizace. |
Stav 30. 9. 2026. Jde o referenční dolarové ceny, ne konečný český ceník s daní; místní měna a nákupní kanál mohou částku změnit. Business vyžaduje alespoň dvě placená místa. Zdroje: ceny a orientační využití, varianty Pro, Business Standard a Premium. Poměry 1×, 5× a 10× výslovně potvrzuje Tibo Sottiaux z OpenAI, 25× uvádí oznámení DevDay.
Na aktuálních osobních tarifech vychází 20 USD za jednu jednotku kapacity Plus: 100 / 5, 200 / 10 i 500 / 25. Vyšší tarif kupuje více prostoru a další funkce, samotným násobkem už nedává množstevní slevu. Původní Pro 200 při 20× vycházel na 10 USD za jednotku. Je to můj přepočet cen a násobků, nikoli tokenový ceník.
Ještě podstatnější je volba rychlosti. Při stejném modelu a stejném objemu tokenů odpovídá Pro 500 v Ultrafast přibližně 3,1× kapacitě Plus ve Standardu: 25 / 8. Pro 200 s novým limitem ve Fast vychází na 4×: 10 / 2,5. To vysvětluje, proč ani drahý tarif nemusí při nejrychlejším režimu vydržet dlouho. Nejde o počet hotových úkolů, které mohou spotřebovat různý objem tokenů.
Kolik zpráv je jeden Plus? OpenAI odhaduje za pět hodin přibližně 5 až 45 lokálních zpráv s Astrou, 15 až 160 se Solem 6.1 a 350 až 3 000 s Lunou. Jsou to alternativy pro různé modely, nesčítají se. Dlouhé zadání může limit vyčerpat výrazně rychleji a platí i další omezení. Pro nyní pětihodinový limit nemá, takže násobky nelze přepsat na garantovaný počet zpráv každých pět hodin. Vysvětlení limitů a jejich rozpětí
Dá se předplatné přepočítat na peníze a tokeny?
Přesný garantovaný kurz předplatného vůči API neznáme. Odhadnout se ale dá, kolik by zaznamenané tokeny stály v API. Veřejná měření naznačují, že při intenzivním používání může jít o několikanásobek ceny předplatného. Záleží na modelu, cache, rychlosti a na tom, zda svůj limit vůbec využiji.
Veřejná měření a můj orientační přepočet jednotlivých tarifů
Uživatel na GitHubu Codexu porovnal tokenové záznamy s úbytkem týdenního limitu původního Pro 20×. U Astry mu začátkem září vyšel přepočet zhruba 1 200 USD API využití za celý týdenní limit, u tehdejšího Solu 5.6 asi 1 925 USD. Šlo o extrapolaci části týdne jednoho účtu, nikoli o oficiální nárok.
Další uživatel zveřejnil měření Plus: u Astry uvádí 11 USD API ekvivalentu za pětihodinové okno a odhaduje 66 USD za týden. Po doplnění Solu 6.1 uvádí 7,50 USD za okno a 45 USD týdně. Týdenní čísla jsou jeho přepočet, ne můj ověřený test. Zprávy v diskusi o rychlém vyčerpání limitu jsou užitečný signál, ale bez modelu, nastavení a tokenových záznamů z nich rozpočet nespočítáme.
Z těchto dvou pozorování si skládám následující ilustrativní scénář pro Standard a plné využívání limitu. Sol stojí na jediném uživatelském odhadu; rozpětí Astry vychází z přibližně 60 až 66 USD za jednotku Plus. Ostatní řádky pouze násobím kapacitou tarifu. Nové Pro 10× ani Pro 500 takto nezávisle změřené nemám.
| Tarif a kapacita | Odhad API ekvivalentu Solu 6.1 za týden | Odhad API ekvivalentu Astry za týden |
|---|---|---|
| Plus, 1× | asi 45 USD | asi 60 až 66 USD |
| Pro 100, 5× | asi 225 USD | asi 300 až 330 USD |
| Pro 200, nové 10× | asi 450 USD | asi 600 až 660 USD |
| Pro 200, původní 20× | asi 900 USD | asi 1 200 až 1 320 USD |
| Pro 500, 25× | asi 1 125 USD | asi 1 500 až 1 650 USD |
Toto není skrytý ceník OpenAI ani statistický interval spolehlivosti. Část podkladů předchází DevDay a změnám kapacity, které OpenAI právě oznamuje. Prosté násobení předpokládá stejné účtování mezi tarify a nezměněný základ Plus. Právě tyto předpoklady může změna limitů, modelu nebo zapojení dalších funkcí porušit. Rozpětí 60 až 66 proto neznamená, že skutečnost nemůže ležet daleko mimo ně.
Pokud by scénář platil celý třicetidenní měsíc a využil bych každou týdenní kapacitu, nový Pro 200 by odpovídal asi 1 900 USD v API se Solem 6.1, nebo 2 600 až 2 800 USD s Astrou. Jsou to dvě alternativy, ne součet. Při čtvrtinovém využití by hodnota v tomto přepočtu klesla na čtvrtinu. Z vyšší dolarové hodnoty Astry také neplyne, že udělá více užitečné práce než Sol.
Převod na tokeny vyžaduje konkrétní směs. Za předpokladu tří necacheovaných vstupních tokenů na jeden výstupní stojí milion tokenů dohromady 4 USD u Solu 6.1 a 20 USD u Astry. Odhadovaných 450 USD se Solem tedy znamená asi 112,5 milionu tokenů týdně; 600 USD s Astrou asi 30 milionů. Výstup zahrnuje i účtované reasoning tokeny. Jde o součet mnoha požadavků, každý v běžném cenovém pásmu, bez dalších placených nástrojů. Jiný poměr vstupu a výstupu nebo cache výsledek zásadně změní. Standardní tokenové sazby
Nejpoužitelnější vlastní měření je jednoduché: při stejném modelu a rychlosti zaznamenat tokeny a úbytek například deseti procentních bodů týdenního limitu. Spočítat jejich cenu v API, vydělit 0,10 a zopakovat přes několik dní. Mezitím nesmí proběhnout reset a je potřeba zahrnout všechny souběžné agenty i další čerpání. Získám tím orientaci pro svoji práci, ne univerzální peněžní hodnotu tarifu.
Na co konkrétně vystačí bonus 62 500 kreditů
U bonusu je přepočet konkrétnější. Zkusme jeden početní balíček 100 000 necacheovaných vstupních a 10 000 výstupních tokenů včetně přemýšlení. Není to definice úkolu; reálná oprava může spotřebovat zlomek i několik takových balíčků.
| Model a rychlost | Kreditů za uvedený balíček | Z 62 500 kreditů vyjde přibližně |
|---|---|---|
| GPT-6.1 Sol Standard | 7,5 | 8 333 balíčků |
| GPT-6 Astra Standard | 37,5 | 1 666 balíčků |
| GPT-6 Astra Fast | 75 | 833 balíčků |
| GPT-6 Astra Ultrafast | 225 | 277 balíčků |
Výpočet používá sazby Work/Codex: Sol 50 kreditů za milion vstupních a 250 za milion výstupních tokenů, Astra 250 a 1 250. Fast násobí placené kredity dvěma, Ultrafast šesti. Pravidla osobních kreditů odkazují na tokenovou sazební tabulku. Nezapočítávám cache, další placené funkce ani změny sazeb.
V ocenění oznámeného bonusu vychází jeden kredit na 0,04 USD. Uvedený balíček tedy odpovídá 0,30 USD se Solem Standard, 1,50 USD s Astrou Standard a 9 USD s Astrou Ultrafast. Tohle je přepočet spotřeby bonusu, nikoli automatický kurz běžného zahrnutého limitu. Bonus sám přístup k Ultrafast neodemkne, potřebuji způsobilý tarif. Rozhoduje i expirace: nevyužitý bonus se v hotovost nepromění.
Také se zlevnění API a snížení předplatného nedají jednoduše vynásobit. Jsou to odlišné způsoby účtování. Lepší Sol může část poklesu kapacity vyrovnat menším počtem oprav. Že ho vyrovná právě při mé práci, ale musí ukázat spotřeba a výsledky, ne marketingový slib.
Co bych si vyzkoušel během příštího týdne
Místo dalšího univerzálního pořadí modelů bych si připravil dvacet anonymizovaných úloh ze své práce: pět úprav kódu, pět analýz dokumentů, pět českých textů a pět úloh s nástroji. Pro každou předem napsat, podle čeho poznám přijatelný výsledek.
- Porovnat Sol 6.1 medium, jednu silnější konfiguraci a svého dosavadního favorita. Stejné podklady, stejné možnosti nástrojů, nové konverzace. U agentů i stejný výchozí stav projektu.
- Dvěma nejtěžším úlohám dát více pokusů. Jediný povedený běh může být náhoda. Evidovat i selhání a všechny jeho náklady.
- Zapsat cenu, čas a nutné opravy. U předplatného sledovat úbytek limitu, u API účtované tokeny včetně reasoning a cache. Nemíchat tato čísla do jedné předstíraně přesné ceny.
- Zařadit úlohu, kde má model přiznat nejistotu. Chybějící příloha, nejednoznačné číslo v PDF nebo rozbitý vyhledávač. Vymyšlená odpověď je neúspěch, i když zní výborně.
- Prověřit hranice oprávnění na bezpečné kopii. Například zadat změnu jediného souboru. Hodnotit i to, zda agent nezačal upravovat něco dalšího.
Takový malý test není vědecké srovnání všech modelů. Pro rozhodnutí, který nástroj si zítra otevřu a za co budu platit, mi ale může říct víc než další desetina bodu ve světovém žebříčku.
Za nejpřínosnější novinku teď považuji Sol 6.1 jako levnější základ pro skutečnou práci. Největší dlouhodobý potenciál vidím ve spojení sdíleného kontextu a průběžně pracujících agentů. U Dots si chci ověřit spolehlivost, u Decisions cenu a u Ultrafast skutečně ušetřený čas. Rozhodovat se budu podle hotových výsledků, které mohu zkontrolovat.
Pokud si chcete modely porovnávat i mimo jediného výrobce, můžete vyzkoušet můj Hyperprostor. K tématu výběru a spolupráce modelů navazuje také článek Tři měsíce na LUMI: správnou odpověď AI často má. Jen ji neumí vybrat.