Laboratórium teórií: kedy je skupina múdrejšia ako jej najmúdrejší člen
Štyri inštancie jazykového modelu navrhovali a opravovali prediktívne teórie skrytého simulátora skupinového rozhodovania. V troch prieskumných behoch sme sledovali ich presnosť, prínos revízií a priemerovanie predpovedí. Kombinácia teórií prekonala použité modely strojového učenia; výhoda voči jednotlivým teóriám závisela od toho, ako ich vyberieme. Experiment tiež ukázal, ako výsledky ovplyvňuje šum merania a podoba spätnej väzby.
Prečo sme postavili Laboratórium teórií
Postavili sme malé výskumné laboratórium, v ktorom štyri tímy umelej inteligencie samy vymýšľajú, testujú a opravujú vedecké teórie. Počas jedného dňa prebehli tri vlny experimentu: 36 teórií, 41 volaní modelu Claude Opus a zhruba šesť hodín výpočtu za 63 dolárov. Spoločná odpoveď laboratória predpovedala lepšie ako použité modely strojového učenia a vo všetkých troch vlnách aj lepšie ako najlepšia prijatá jednotlivá teória. Aká veľká je táto výhoda, však závisí od toho, ako jednotlivú teóriu vyberieme.
Inšpiráciou bolo oznámenie startupu Physical Superintelligence (PSI) z novembra 2026. Jeho výskumný systém s neverejným modelom od Anthropicu podľa autorov dokázal matematickú domnienku z roku 2008. Dôkaz skontroloval Lean, program, ktorý overí každý logický krok. V čase oznámenia išlo o čerstvý preprint, nezávislé posúdenie ešte len prebiehalo.
Nás na tom zaujala hlavne metóda. AI v nej nikoho nepresviedčala rečami. Navrhovala a nezávislý, nepodplatiteľný sudca rozhodoval, čo platí. Princíp „generátor hypotéz + nezávislý sudca + opakované zlepšovanie“ je všeobecný.
Položili sme si preto otázku: funguje rovnaká slučka aj mimo matematiky? Teda tam, kde nijaký Lean neexistuje, napríklad v psychológii alebo vo filozofii?
V článku nájdete:
- akú otázku sme skúmali a čo o nej veda už vie,
- ako laboratórium funguje, krok za krokom a na príkladoch,
- tri vlny experimentu vrátane chýb, ktoré sme cestou urobili,
- nezávislú kritiku, ktorú sme dostali, a čo sme s ňou urobili,
- k čomu sme dospeli a čo to znamená pre tímy ľudí aj AI agentov.
Článok je dlhý, čítanie zaberie asi pol hodiny. Kto sa ponáhľa, môže rovno skočiť na kapitolu K čomu sme dospeli.
Interaktívny report: všetkých 36 teórií v plnom znení, grafy, štatistiky a každé rozhodnutie západky nájdete v interaktívnom reporte (v češtine).
V skratke
Čo sme merali: ako presne teórie, ktoré napísala AI, predpovedajú výsledky skrytého simulátora skupinového rozhodovania. Nešlo o pokusy s ľuďmi. Meradlom je chyba pravdepodobnostnej predpovede: v prvých dvoch vlnách Brier skóre, v tretej vlne MSE voči podielu víťazných skupín. Nižšie je lepšie a čísla tretej vlny sa s prvými dvoma priamo neporovnávajú.
| Vlna | Odpoveď laboratória | Najlepšia prijatá teória | Najlepšia baseline |
|---|---|---|---|
| 1 | 0,078 / 0,098 | 0,083 / 0,108 | 0,112 / 0,137 |
| 2 | 0,075 / 0,085 | 0,093 / 0,131 | 0,131 / 0,139 |
| 3 (iná metrika) | 0,032 / 0,037 | 0,041 / 0,070 | 0,086 / 0,175 |
Hodnoty sú skrytý test / veľké skupiny. Vo vlne 1 ešte neexistovala západka, preto je odpoveďou laboratória priemer prvých verzií a najlepšou teóriou najlepšia prvá verzia. Jedna výnimka: v druhej vlne by verzia s najnižšou validačnou chybou zo všetkých, ktorú západka zamietla, porazila priemer na teste (0,070 oproti 0,075), na veľkých skupinách nie (0,106 oproti 0,085).
Otázka: kedy je skupina múdrejšia ako jej najlepší člen
Skúmali sme jedinú otázku: za akých podmienok je skupina inteligentnejšia ako jej najinteligentnejší člen? Nepýtame sa, či je skupina lepšia ako priemerný člen. To býva ľahké. Pýtame sa, či dokáže poraziť toho najlepšieho, kto v nej sedí.
Predstavte si poradu piatich lekárov, z ktorých jeden je špičkový špecialista. Keď skupina len spriemeruje názory, slabšie hlasy špecialistu „rozriedia“. Aby ho skupina porazila, musí pridať niečo, čo on sám nemá: inú informáciu, iný uhol pohľadu alebo opravu jeho chyby.
Kedy skupiny vyhrávajú a kedy prehrávajú, ukazujú štyri bežné situácie:
- Skupina vyhrá: sto ľudí tipuje počet cukríkov v pohári. Priemer tipov býva bližšie k pravde ako takmer každý jednotlivec, pretože nadsadené tipy vyvážia tie podhodnotené.
- Skupina vyhrá: auto nechce naštartovať a porucha má tri príčiny. Elektrikár nájde chybný kábel, mechanik upchatý filter a programátor chybu v riadiacej jednotke. Nikto z nich by auto neopravil sám, spolu áno.
- Skupina prehrá: porota odpovedá na záludnú otázku, na ktorú väčšina ľudí intuitívne odpovie zle. Hlasovanie chybu nezruší, ale potvrdí.
- Skupina prehrá: na porade rozhoduje najhlasnejší a najsebavedomejší človek, nie ten najschopnejší. Skupina je potom múdra len natoľko, nakoľko jej status zodpovedá skutočnej kompetencii.
Otázka má dnes veľmi praktický rozmer, a to pri ľuďoch aj pri umelej inteligencii:
- Firmy a tímy riešia, kedy zvolať poradu, kedy nechať rozhodnúť experta a kedy jednoducho hlasovať.
- Vývojári AI dnes bežne skladajú viacero agentov dokopy: jeden píše, druhý kontroluje, tretí hlasuje. Kedy z toho vznikne niečo múdrejšie ako najlepší agent a kedy len drahý šum?
- Veda sa tu stretáva z troch strán: filozofia sa pýta, čo je kolektívne poznanie, psychológia skúma, ako skupiny rozhodujú, a informatika stavia systémy z mnohých modelov.
V našom experimente má „poraziť najlepšieho člena“ presný význam. Najlepší člen je ten so skutočne najvyššou kompetenciou a rieši rovnaké úlohy ako skupina, len sám. Skupina sama nemusí vedieť, kto to je. Vyhráva, keď má aspoň o jeden percentuálny bod vyššiu úspešnosť, pri odhadoch aspoň o 1 % menšiu chybu.
Čo o kolektívnej inteligencii už vieme
Veda pozná šesť mechanizmov, ktoré rozhodujú, či skupina svojho najlepšieho člena porazí. Všetky sme neskôr vložili do simulovaného sveta a tímy AI ich mali znovu objaviť bez toho, aby svet videli zvnútra.
1. Múdrosť davu a korelované chyby
V roku 1906 tipovalo na trhu s dobytkom v anglickom Plymouthe takmer 800 ľudí váhu vola. Prostredný tip sa od skutočnej váhy líšil o necelé 1 %. Priemer funguje, pretože nezávislé chyby sa navzájom rušia.
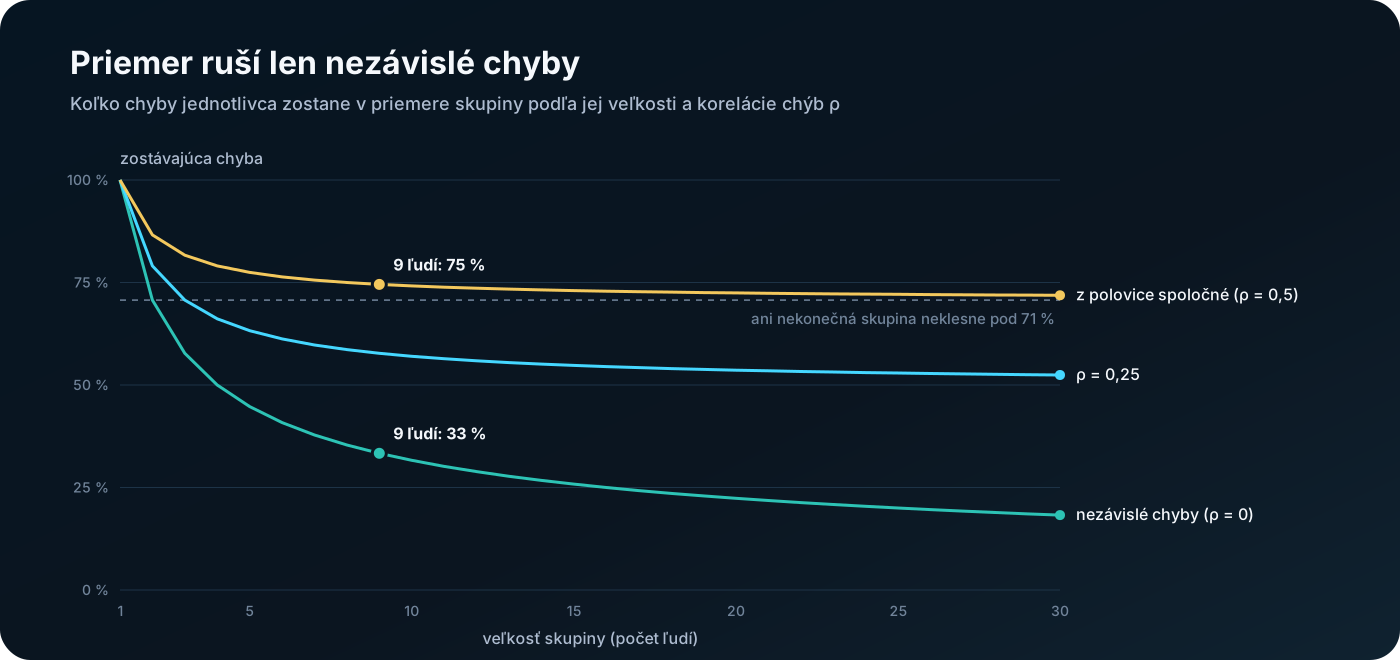
Háčik je v slove nezávislé. Keď všetci čítali rovnaký zavádzajúci článok, mýlia sa rovnakým smerom a priemer chybu nezruší. Matematicky: chyba priemeru sa zmenší na √(ρ + (1 − ρ) / n) pôvodnej chyby, kde n je veľkosť skupiny a ρ korelácia chýb. Platí to za predpokladu, že všetci majú rovnako veľké chyby a každá dvojica členov rovnakú koreláciu. Pri priemernej absolútnej chybe navyše predpokladáme normálne rozdelené chyby.
- Deväť ľudí s nezávislými chybami (ρ = 0) zmenší chybu na tretinu.
- Deväť ľudí, ktorých chyby sú z polovice spoločné (ρ = 0,5), ju zmenší len na zhruba 75 %.
- A keď je jeden člen oveľa presnejší ako ostatní, priemer jeho presnosť naopak „rozriedi“.
2. Condorcetova veta a jej obrátenie
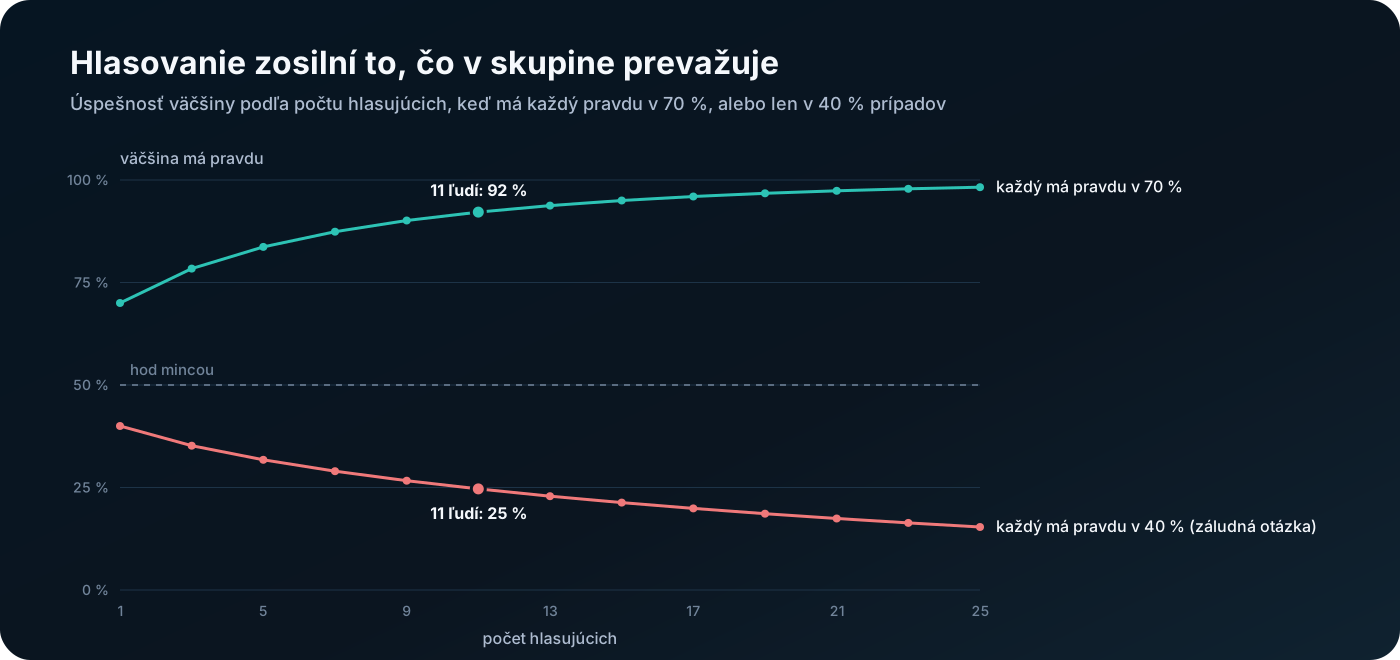
Markíz de Condorcet v roku 1785 ukázal, že väčšina môže byť múdrejšia ako jednotlivci. Ak majú všetci porotcovia rovnakú šancu na správnu odpoveď, väčšiu ako 50 %, a rozhodujú nezávisle, väčšina má pravdu častejšie ako ktorýkoľvek z nich. Jedenásť porotcov, z ktorých každý má pravdu v 70 % prípadov, rozhodne väčšinou správne zhruba v 92 % prípadov. Predpoklad rovnakej úspešnosti je dôležitý. Traja nezávislí hlasujúci s úspešnosťou 99 %, 51 % a 51 % majú väčšinou pravdu len asi v 75 % prípadov, takže svojho najlepšieho člena výrazne zhoršia. Aj to je odpoveď na našu otázku.
Veta však platí aj obrátene. Vezmite si záludnú otázku: Pálka a loptička stoja spolu 1,10 €, pálka je o 1,00 € drahšia ako loptička. Koľko stojí loptička? Väčšina ľudí intuitívne odpovie 10 centov, správne je 5 centov. Keď má každý pravdu len v 40 % prípadov, väčšina jedenástich ľudí rozhodne správne len zhruba v 25 %. Hlasovanie chybu nezruší, ale zosilní.
3. Demonštrovateľnosť: pravda víťazí
Psychológ Patrick Laughlin rozlíšil úlohy podľa toho, či sa dá správna odpoveď predviesť. Pri matematickej úlohe alebo hádanke stačí, aby riešenie našiel jeden človek. Len čo ho vysloví, ostatní hneď spoznajú, že je správne, a „pravda víťazí“.
Pri iných úlohách to nejde. Ktoré logo je lepšie, ktorý uchádzač bude dobrým kolegom, aké víno je najlepšie? Tam správna odpoveď nepresvedčí sama osebe a rozhoduje väčšina alebo status.
4. Skryté profily: vedomosti, ktoré nikto nevysloví
Garold Stasser a William Titus v roku 1985 zistili, že skupiny sa v diskusii venujú hlavne informáciám, ktoré už pozná každý. Unikátna informácia, ktorú má len jeden človek, často vôbec nezaznie.
Príklad: výberová komisia vyberá medzi kandidátmi A a B. Každý člen pozná inú slabinu kandidáta A, takže každému osve vychádza A ako najlepší. Keby dali svoje vedomosti dokopy, jasne by vyhral B. Diskusia sa však točí okolo zdieľaných predností kandidáta A. Komplementárne vedomosti sú tak najsilnejším zdrojom výhody skupiny a zároveň najkrehkejším.
5. Status a viditeľnosť kompetencie
Skupiny počúvajú tých, ktorí pôsobia kompetentne: sú sebavedomí, majú vyššie postavenie, hovoria nahlas. Keď tento dojem zodpovedá skutočnej kompetencii, líder alebo vážená diskusia fungujú skvele. Keď nie, skupina nasleduje sebavedomého, ktorý sa mýli. Príklad: najskúsenejší inžinier v tíme je tichý, rozhoduje nový, sebaistý manažér.
6. Procesné straty a veľkosť skupiny
Ivan Steiner v roku 1972 zhrnul výkon skupiny ako potenciál mínus procesné straty. Straty vznikajú z koordinácie, z obmedzeného času, z konformity alebo z toho, že sa niekto „vezie“. Väčšia skupina má väčší potenciál, ale aj väčšie straty. Na hodinovej porade tridsiatich ľudí rozhodnutie v skutočnosti formuje len niekoľko najaktívnejších.
Žiadny z týchto mechanizmov sám otázku nerieši. Výsledok závisí od ich súhry, a to je presne úloha pre teóriu: spojiť ich tak, aby predpovedala aj situácie, ktoré nikto predtým nevidel.
Hlavná myšlienka: AI navrhuje, nezávislý sudca rozhoduje
Naša hlavná myšlienka je jednoduchá: model nesmie súdiť sám seba. Teórie navrhuje umelá inteligencia, ale o tom, či platia, rozhoduje nezávislý sudca, ktorého nemožno presvedčiť výrečnosťou.
Prečo nestačí, aby sa niekoľko chatbotov dohodlo? Jazykové modely sú presvedčivé a debata niekoľkých z nich smeruje k tomu, čo znie najlepšie, nie k tomu, čo je pravda. Hlasovanie modelov navyše naráža na Condorcetov problém z predchádzajúcej kapitoly. Keď majú všetky modely rovnaké slepé miesto, hlasovanie ho len potvrdí. Otázka, ktorú skúmame, sa tak týka aj našej vlastnej metódy.
V matematike je sudcom Lean. V psychológii nijaký Lean neexistuje a experimenty s ľuďmi sú pomalé a drahé. Postavili sme preto simulovaný svet: program, ktorý simuluje skupiny ľudí pri riešení úloh a v experimente hrá úlohu prírody. Tímy AI jeho kód nikdy nevidia, rovnako ako vedec nevidí zákony prírody. Poznajú len opis pokusu a jeho výsledky.
| PSI (matematika) | Laboratórium teórií (kolektívna inteligencia) | |
|---|---|---|
| Kto navrhuje | neverejný model od Anthropicu | štyri tímy Claude Opus 5.5, každý s inou odbornou optikou |
| Kto súdi | Lean, kontrola dôkazov | simulovaný svet a sandbox, ktorý spúšťa kód teórie |
| Čo sa overuje | každý logický krok dôkazu | predpovede teórie pre situácie, ktoré tím nikdy nevidel |
| Kedy sa zmena prijme | len keď je krok platný | od druhej vlny len keď revízia zlepší skryté hodnotenie |
Je férové povedať, čo tým testujeme a čo nie. Simulátor obsahuje mechanizmy, ktoré sme doň vložili podľa učebníc. Netestujeme teda, či teórie platia o skutočných ľuďoch. Testujeme, či AI dokáže objaviť skryté pravidlá systému, do ktorého nevidí, vyjadriť ich ako teóriu a zovšeobecniť ich na situácie, ktoré nikdy nevidela.
Práve to je jedna z kľúčových schopností vedca. A test je čistý, pretože my poznáme správnu odpoveď a môžeme presne zmerať, čo AI našla a čo prehliadla.
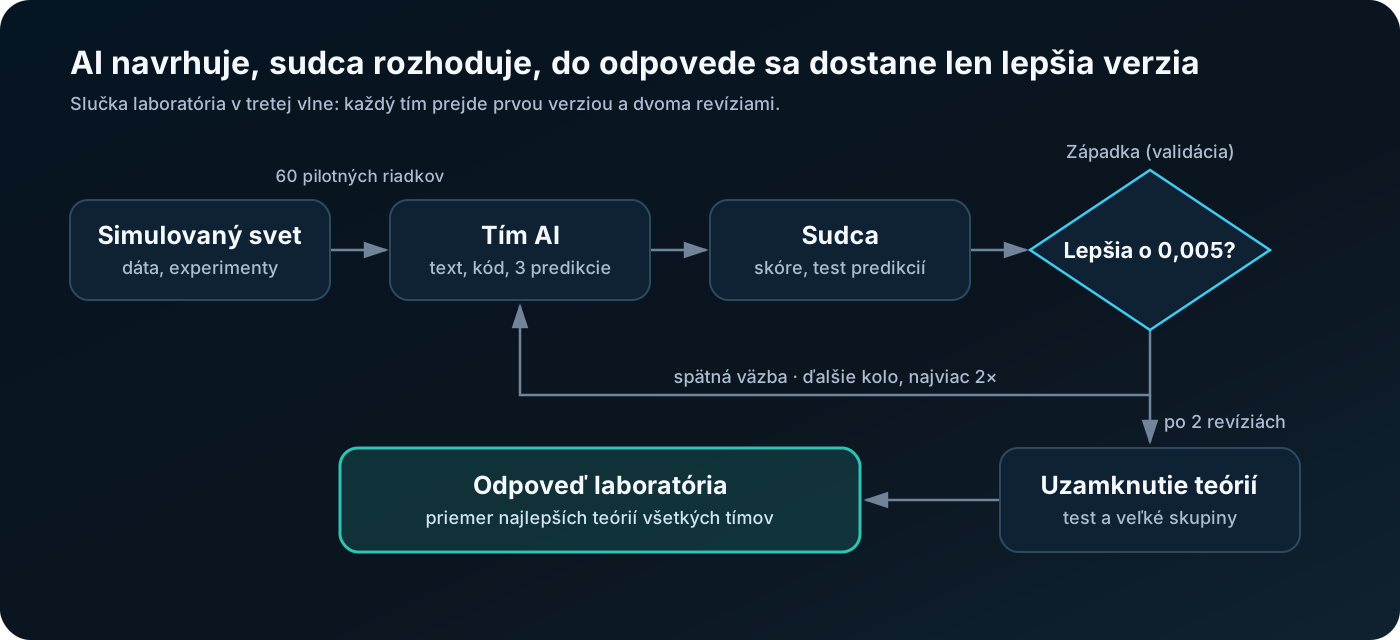
Každý tím prejde slučkou trikrát: prvá verzia a dve revízie. Od druhej vlny o prijatí revízie rozhoduje západka, v tretej vlne sudca navyše testuje predikcie na nových experimentoch.
Simulovaný svet: kde skupiny riešia úlohy
Simulovaný svet je program, v ktorom skupiny virtuálnych ľudí riešia tisíce úloh a my meriame, či skupina porazila svojho najlepšieho člena. Každý pokus, ktorému hovoríme podmienka, je kombinácia typu úlohy, rozhodovacieho procesu a šiestich číselných parametrov.
Tri typy úloh
| Úloha | Čo členovia robia | Príklad zo života | Ako sa hodnotí |
|---|---|---|---|
| Odhad | každý odhaduje neznáme číslo | váha vola, náklady projektu, počet zákazníkov budúci rok | veľkosť chyby |
| Voľba | otázka s dvoma možnosťami, jedna je správna | „Je hlavným mestom Austrálie Sydney, alebo Canberra?“ | úspešnosť |
| Hlavolam | na riešenie treba niekoľko rôznych kúskov vedomostí | porucha auta s tromi príčinami, diagnóza zriedkavého ochorenia | vyriešené, alebo nie |
Hlavolam jednotlivec vyrieši len vtedy, keď pozná všetky potrebné kúsky. Skupina ho môže vyriešiť aj vtedy, keď každý pozná len niečo, ak sa vedomosti v diskusii naozaj stretnú.
Tri spôsoby rozhodovania
- Nezávisle: členovia spolu nehovoria a odpovede sa spoja mechanicky. Pri odhade priemerom, pri voľbe hlasovaním, pri hlavolame skupina odovzdá riešenie najrešpektovanejšieho z tých, ktorí si myslia, že ho vyriešili. Ako online anketa.
- Diskusia: voľná debata s obmedzeným časom, ktorá sa končí konsenzom. Ako porada.
- Líder: najrešpektovanejší člen sa poradí s niekoľkými ďalšími a rozhodne sám. Ako šéf, ktorý si vypočuje tím.
Šesť číselných parametrov
| Parameter | Rozsah | Čo znamená | Príklad |
|---|---|---|---|
| Veľkosť skupiny | 3–12, v záverečnom teste 16–60 | počet členov | tím, oddelenie, celá firma |
| Priemerná kompetencia | 0–1 | akí schopní sú členovia v priemere | študenti, alebo profesionáli |
| Nerovnosť kompetencie | 0–1 | ako veľmi najlepší člen vyčnieva | zohraný tím, alebo jedna hviezda a pomocníci |
| Korelácia chýb | 0–1 | ako podobne sa členovia mýlia | všetci študovali na tej istej škole a čítajú rovnaké správy |
| Viditeľnosť kompetencie | 0–1 | ako dobre skupina spozná, kto je schopný | tím, kde sa vie, kto je expert, alebo kde rozhoduje sebavedomie |
| Demonštrovateľnosť | 0–1 | ako ľahko ostatní spoznajú správnu odpoveď | matematický dôkaz, alebo hodnotenie vína |
Čo sa meria
V každej podmienke skupina vyrieši 2000 úloh. Jej najlepší člen rieši rovnaké úlohy sám. Spočítame, o koľko bola skupina lepšia alebo horšia a či zvíťazila aspoň o jeden percentuálny bod.
V tretej vlne rieši každú podmienku desať rôznych skupín s rovnakými parametrami. Meriame potom podiel skupín, ktoré svojho najlepšieho člena porazili. Prečo to bolo nutné, vysvetlíme pri druhej vlne.
Čo je vnútri a tímy to nevidia
V simulátore sú zabudované konkrétne pravidlá, ktoré mali tímy AI objaviť. Napríklad:
- Úspešnosť pri voľbe je 0,3 + 0,65 × kompetencia. Najslabší členovia sa teda mýlia častejšie, ako keby hádzali mincou, a naletia na „návnadu“.
- Hlavolam vyžaduje 5 kúskov vedomostí. Vyslovený kúsok vedomostí skupina prijme s pravdepodobnosťou 0,5 + 0,5 × demonštrovateľnosť.
- V diskusii reálne hovorí len 6 najrešpektovanejších členov a líder sa radí najviac s piatimi ľuďmi. Pri odhade dáva líder vlastnému názoru váhu 70 %.
- Kto hlavolam nevyriešil, mylne verí opaku s pravdepodobnosťou 0,5 × (1 − demonštrovateľnosť). Takí „falošní riešitelia“ môžu prebiť skutočného.
Simulátor sme najprv overili desiatimi kontrolnými testami, napríklad či reprodukuje Condorcetovu vetu, múdrosť davu alebo škodlivosť korelovaných chýb. Až potom sme ho pustili k tímom.
Tímy AI vedcov, teórie ako kód a sudca
Štyri inštancie modelu Claude Opus 5.5 pracovali ako samostatné výskumné tímy, každá s inou odbornou optikou. Rôzne optiky sme zvolili z rovnakého dôvodu, pre ktorý fungujú rozmanité skupiny ľudí: rôzne pohľady robia rôzne chyby.
| Tím | Optika | Otázka, ktorú si kladie |
|---|---|---|
| Štatistik | múdrosť davu, Condorcet, korelované chyby | Koľko chýb sa priemerovaním vyruší? |
| Diverzita | komplementárne vedomosti, skryté profily | Čo vedia ostatní, čo najlepší nevie? |
| Sociálny psychológ | Steiner, Laughlin, status, konformita | Čo sa cestou stratí v procese? |
| Minimalista | Occamova britva | Aký najmenší počet princípov stačí? |
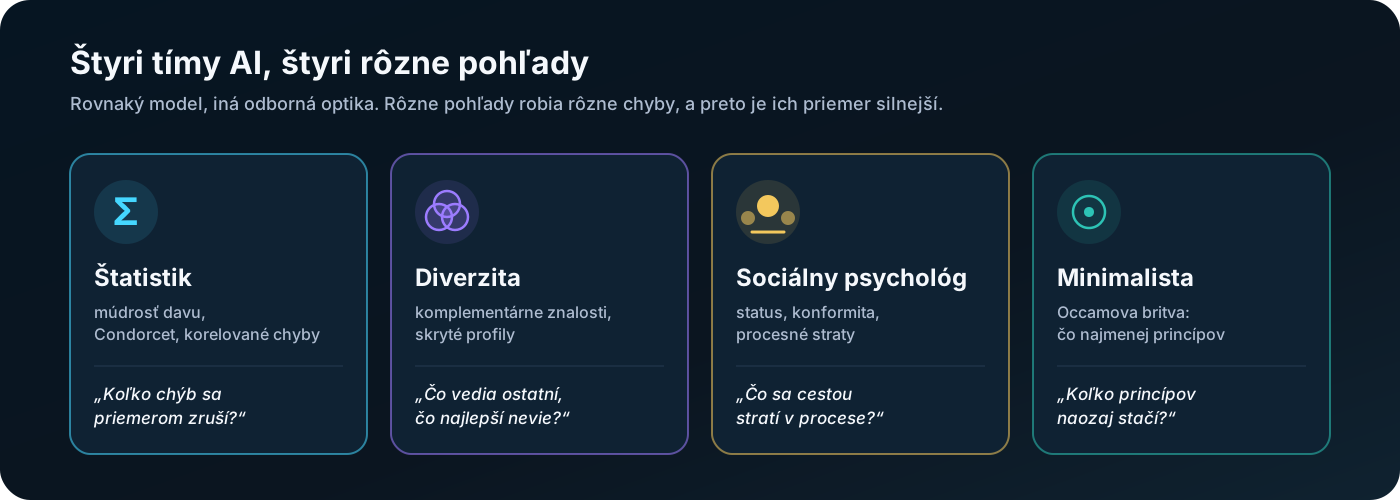
Tímy bežia bez nástrojov a bez prístupu k súborom, takže do simulátora fyzicky nemôžu nahliadnuť. Na začiatku dostanú len opis pokusu, svoju optiku a 60 pilotných riadkov dát. Každý riadok je jedna podmienka s parametrami a výsledkom.
Ako vyzerá teória
Každá teória má štyri časti:
- Názov, napríklad „Skladanie dielikov proti zdieľanej slepote“.
- Tvrdenie: 4 až 8 viet o tom, aké mechanizmy rozhodujú.
- Tri falzifikovateľné predikcie: odvážne tvrdenia, ktoré môže experiment vyvrátiť.
- Funkcia
predict(c): krátky program v Pythone, ktorý pre ľubovoľnú podmienku vráti pravdepodobnosť, že skupina porazí svojho najlepšieho člena.
Prečo kód? Slová bývajú vágne: „skupiny zvyčajne vyhrávajú, keď sú rozmanité“ sa nedá zmerať. Kód prevádza teóriu na jednoznačné predpovede pre každú situáciu. Simulátor potom meria, nakoľko tieto predpovede zodpovedajú jeho výsledkom. Na rozdiel od formálneho dôkazu však úspech kódu nedokazuje, že platí aj slovné vysvetlenie.
Ukážka skutočného riadku z teórie sociálneho psychológa z prvej vlny:
k_del = min(n - 1.0, 6.0) # limited airtime: only ~6 other voices really heard
Komentár hovorí: „obmedzený čas, v skutočnosti je počuť len asi 6 ďalších hlasov“. Opis pokusu spomínal len „obmedzený čas“. Či tím číslo 6 odvodil z dát, alebo ho odhadol na základe vedomostí o skupinách, sa z jeho výstupu nedá zistiť. Simulátor má nastavených práve 6 hovoriacich.
Sudca a Brier skóre
Sudca spustí kód teórie v izolovanom procese, kde je k dispozícii len matematická knižnica, žiadne súbory ani sieť. Pre každú podmienku porovná predpoveď so skutočnosťou a vypočíta Brier skóre.
Brier skóre poznáte z predpovede počasia. Meteorológ povie „pravdepodobnosť dažďa je 80 %“:
- keď prší, jeho chyba je (1 − 0,8)² = 0,04,
- keď neprší, jeho chyba je (0 − 0,8)² = 0,64,
- Brier skóre je priemer týchto chýb za všetky dni.
Nula znamená dokonalú predpoveď. Kto povie zakaždým „50 %“, dostane 0,25, teda úroveň hádzania mincou. Čím nižšie skóre, tým lepšie. V tretej vlne sme predpoveď porovnávali s podielom víťazných skupín. Metrikou je tam priemerná kvadratická chyba (MSE) voči tomuto podielu a konštantná predpoveď 50 % na nej dostane asi 0,22.
Tím potom dostane spätnú väzbu z tréningových dát: celkové skóre, rozpis podľa deviatich kombinácií úlohy a procesu a 30 najväčších omylov. Potom teóriu prepracuje. Každý tím mal dve kolá revízií, takže z každého tímu vznikli tri verzie teórie: r0, r1 a r2.
Učebnice, písomka a skúšky
Dáta sme rozdelili na štyri časti po 300 podmienok, podobne ako v škole:
| Sada | Školská obdoba | Čo z nej tím vidí |
|---|---|---|
| Tréning | zbierka úloh s výsledkami | všetko: výsledky aj spätnú väzbu |
| Validácia | písomka, ktorú opraví učiteľ | od druhej vlny len „prijaté“, alebo „zamietnuté“ |
| Test | záverečná skúška z rovnakej látky | nič |
| Veľké skupiny | skúška z vyššieho ročníka: skupiny so 16–60 členmi, v tréningu len 3–12 | nič |
Práve sada veľkých skupín je najtvrdšou skúškou. Teória, ktorá len napasovala čísla na tréning, tam zlyháva. Teória, ktorá zachytila skutočný mechanizmus, ho dokáže preniesť aj do neznámeho rozsahu.
Porovnanie so strojovým učením
Aby sme vedeli, či sú teórie vôbec dobré, porovnali sme ich s modelmi strojového učenia bez akejkoľvek teórie. Hovoríme im baseliny: gradient boosting (súbor rozhodovacích stromov), logistická regresia a priemer z tréningu. Baseliny sa učia zo všetkých 300 tréningových riadkov, tímy začínajú so 60. Keby teória neporazila obyčajné napasovanie krivky na dáta, nebola by to dobrá teória.
Prvá vlna: teórie porazili strojové učenie, revízie však škodili
V prvej vlne teórie, ktoré videli len 60 riadkov dát, predpovedali lepšie ako strojové učenie na 300 riadkoch. Každá ďalšia revízia ich však skôr zhoršila. Beh trval 148 minút, s neskorším doplnením 181 minút, a stál 18,21 dolára.
Nastavenie bolo najjednoduchšie možné. Každý tím napísal prvú verziu a dve revízie a každá revízia sa automaticky stala základom ďalšej. Každú podmienku riešila jedna skupina a naraz bežali štyri volania modelu.
Výsledky prvých verzií
Brier skóre, nižšie je lepšie:
| Model | Test (3–12 členov) | Veľké skupiny (16–60) |
|---|---|---|
| Priemer štyroch prvých teórií | 0,078 | 0,098 |
| Diverzita r0 | 0,083 | 0,108 |
| Minimalista r0 | 0,085 | 0,129 |
| Štatistik r0 | 0,091 | 0,114 |
| Gradient boosting, 300 riadkov | 0,112 | 0,137 |
| Sociálny psychológ r0 | 0,119 | 0,131 |
| Logistická regresia | 0,122 | 0,285 |
Tri tímy zo štyroch porazili gradient boosting na teste, diverzita a minimalista štatisticky významne. Logistická regresia sa mimo rozsahu tréningu zrútila: na veľkých skupinách dopadla horšie ako obyčajný priemer z tréningu (0,247). Priamka napasovaná na skupiny s 3 až 12 členmi nedáva pre skupinu s 50 členmi zmysel.
Čo tímy objavili
Najviac nás prekvapilo, ako blízko sa tímy dostali k skrytým pravidlám simulátora. Štatistik zo 60 riadkov odhadol takmer rovnaký tvar rozdelenia kompetencií v skupine:
s = [min(0.99, max(0.0, m + 0.3 * sp * _ppf((i + 0.625) / (n + 0.25)))) for i in range(n)]
tau = 0.5 + 0.5 * dem  # chance a voiced piece is accepted
Simulátor používa priemer + 0,3 × nerovnosť × kvantil normálneho rozdelenia. Konštanta 0,3 sedí presne, kvantily však tím počítal trochu inak a inak orezával hornú hranicu. Prijatie vysloveného kúska vedomostí 0,5 + 0,5 × demonštrovateľnosť zodpovedá simulátoru presne.
Prehľad vybraných pravidiel a toho, ako blízko sa k nim tímy dostali:
| Pravidlo simulátora | Odhad tímu | Zhoda |
|---|---|---|
| kompetencia: priemer + 0,3 × nerovnosť × kvantil | štatistik: 0,3 × nerovnosť × kvantil, iný výpočet kvantilov a orezanie | približná |
| prijatie vysloveného kúska vedomostí: 0,5 + 0,5 × demonštrovateľnosť | štatistik aj minimalista: rovnaký vzťah | presná |
| strop úspešnosti 0,95 | štatistik aj sociálny psychológ: 0,95 | presná |
| v diskusii hovorí 6 najrešpektovanejších | sociálny psychológ: „asi 6 hlasov“ | presná |
| úspešnosť pri voľbe: 0,3 + 0,65 × kompetencia | minimalista: základ 0,3 + 0,7 × kompetencia | približná |
| líder dáva vlastnému odhadu 70 % váhy | tri tímy: 65–67 % | približná |
| diskusia pri odhade váži odhady podľa statusu a presnosti na danom probléme | diverzita: skupina vyberá „najlepší odhad pre problém, nie najlepšieho človeka“ | podobná myšlienka, iný mechanizmus |
| hlavolam vyžaduje 5 kúskov vedomostí | odhady 2 až 4 | odlišná |
| líder sa radí najviac s 5 ľuďmi | od 3 ľudí po 80 % skupiny | odlišná |
Kapacitné limity, ako počet kúskov vedomostí alebo poradcov, sa z dát o malých skupinách spoznávajú najťažšie.
Slučka vie vyvracať
Minimalista v prvej revízii zaviedol „strop schopností“: keď sú všetci veľmi schopní, najlepší sa nemá kam odtrhnúť. V druhej revízii napísal: „Strop dáta vyvrátili: pri priemernej kompetencii 0,81 priemerovanie prehralo o 17 %.“ A nahradil ho správnym vzťahom: chyba klesá s kompetenciou lineárne, takže medzi skúsenými je najlepší relatívne ešte presnejší.
Revízie však vedeli aj strácať. Štatistik aj sociálny psychológ mali v prvej revízii správne, že „falošných riešiteľov“ ubúda s demonštrovateľnosťou. V druhej revízii túto správnu závislosť obaja zrušili.
Revízie škodili
Prvá revízia zhoršila výsledok na teste pri všetkých štyroch tímoch, pri troch z nich významne:
| Tím | Test r0 → r1 |
|---|---|
| Minimalista | 0,085 → 0,128 |
| Diverzita | 0,083 → 0,116 |
| Sociálny psychológ | 0,119 → 0,149 |
| Štatistik | 0,091 → 0,102 |
Teórie pritom rástli: minimalistova z 873 na 1 406 uzlov syntaktického stromu, teda o 60 %. Spätná väzba „tu je 30 najväčších omylov“ zvádzala k záplatám na jednotlivé prípady namiesto lepších mechanizmov. Laboratórium navyše prijalo každú revíziu, aj horšiu, pretože nič ako Lean ho nezastavilo.
Kde teórie zlyhali
Na veľkých skupinách teórie nadhodnotili hlavolamy riešené diskusiou. Predpovedali 89–93 % výhier, skutočnosť bola 79 %. Uvažovali logicky, že viac členov prinesie viac vedomostí. V simulátore však hovorí len 6 najrešpektovanejších, takže väčšina vedomostí veľkej skupiny nikdy nezaznie.
Skupina teórií je múdrejšia ako najlepšia teória
Keď sme spriemerovali predpovede štyroch prvých teórií, dostali sme výsledok lepší ako najlepšia jednotlivá teória: 0,078 oproti 0,083 na teste a 0,098 oproti 0,108 na veľkých skupinách. Priemer všetkých 12 verzií dosiahol na veľkých skupinách dokonca 0,092. Laboratórium tak na vlastných teóriách predviedlo presne ten jav, ktorý skúma: rôzne optiky robia rôzne chyby a priemer ich ruší.
Technické problémy
- Zaseknuté volania: 4 z 13 volaní sa nevrátili. Časový limit na Windows ukončil len spúšťací skript, skutočný proces bežal ďalej a laboratórium naň čakalo.
- Chyba sandboxu: štatistikovu revíziu sudca odmietol, pretože kód použil štandardnú funkciu
reversed, ktorú sme zabudli povoliť. Bola to naša chyba. Po oprave tá istá odpoveď prešla a nemuseli sme za ňu platiť znova. - Doplnenie: dva tímy pre zaseknutie nedokončili revízie. Doplnili sme ich o dve hodiny neskôr: 3 volania, 33 minút, 5,83 dolára, tentoraz bez jediného zaseknutia.
Z prvej vlny sme si odniesli tri ponaučenia. Revízie potrebujú sudcu, ktorý horšiu verziu nepustí. Odpoveďou laboratória má byť skupina teórií, nie jedna teória. A štyri súbežné volania modelu sú priveľa.
Druhá vlna: západka a priemer teórií
V druhej vlne bol priemer teórií prvýkrát štatisticky významne lepší ako najlepšia prijatá teória. Nová „západka“, ktorá mala horšie revízie zastaviť, však rozhodovala skôr náhodne. Beh na nových dátach trval 96 minút a stál 24,67 dolára. Z 13 volaní sa nezaseklo ani jedno.
Čo sme zmenili
- Západka: pribudla validácia, 300 podmienok, ktoré tímy nevidia. Revízia prejde, len keď na nich zlepší Brier skóre aspoň o 0,005. Inak tím pokračuje zo svojej najlepšej verzie a dozvie sa len to, že revízia neprešla. Je to naša obdoba Leanu, ktorý prijme len platný krok.
- Odpoveď laboratória: už to nie je jedna teória, ale priemer predpovedí najlepších prijatých verzií všetkých tímov.
- Prevádzka: najviac dve volania naraz, každý tím absolvuje svoje kolá samostatne a časový limit ukončí celý strom procesov.
Výsledky
| Model | Test | Veľké skupiny |
|---|---|---|
| Odpoveď laboratória (priemer najlepších teórií) | 0,075 | 0,085 |
| Priemer prvých verzií | 0,080 | 0,094 |
| Najlepšia jednotlivá teória podľa validácie (štatistik r1) | 0,093 | 0,131 |
| Gradient boosting | 0,131 | 0,139 |
Odpoveď laboratória porazila gradient boosting o 0,056 na teste a o 0,054 na veľkých skupinách. Najlepšiu prijatú teóriu porazila o 0,018 a o 0,047. Oba rozdiely sú štatisticky významné na oboch sadách: 95-percentné intervaly spoľahlivosti z bootstrapu nezahŕňajú nulu.
Jedna výhrada: verzia s najnižšou validačnou chybou zo všetkých, štatistikova r2, ktorú západka zamietla, bola na teste lepšia ako priemer (0,070 oproti 0,075). Na veľkých skupinách však prehrala (0,106 oproti 0,085). Priemer teda preukázateľne porazil najlepšiu prijatú teóriu, nie však každú jednotlivú verziu. Pravdepodobný dôvod je rovnaký ako pri ľuďoch: každý tím sa mýli inde a priemer chyby ruší.
Západka nedokázala rozlíšiť jemné rozdiely
Západka spoľahlivo zastavila katastrofy. Všetky tri jasne horšie revízie zamietla (diverzita r1 a r2, minimalista r1). Pri jemnejších rozdieloch sa však mýlila:
- Prijala štatistika r1, pretože sa na validácii zlepšil o 0,016. Na teste aj na veľkých skupinách bol však horší ako predchádzajúca verzia (0,082 → 0,093 a 0,114 → 0,131).
- Zamietla štatistika r2, pretože sa na validácii zlepšil len o 0,001. Pritom to bola na teste najlepšia teória celého behu (0,070) a lepšia bola aj na veľkých skupinách.
Z ôsmich rozhodnutí boli tri správne, dve chybné a tri zmiešané. To nie je o veľa lepšie ako hádzanie mincou.
Pravdepodobná príčina: šum v štítkoch
Za pravdepodobnú príčinu považujeme samotné meranie. Vzali sme 60 podmienok a každú nasimulovali s 20 rôznymi skupinami. Parametre boli rovnaké, líšilo sa len náhodné poradie statusu, teda kto je líder a kto hovorí.
Pri 15 zo 60 podmienok niektoré skupiny vyhrali a iné prehrali. Podiel výhier sa pohyboval od 5 do 95 %. Na väčšej vzorke 300 podmienok to bolo 18 až 20 %. Zhruba pri pätine podmienok je teda výsledok jednej skupiny takmer hod mincou.
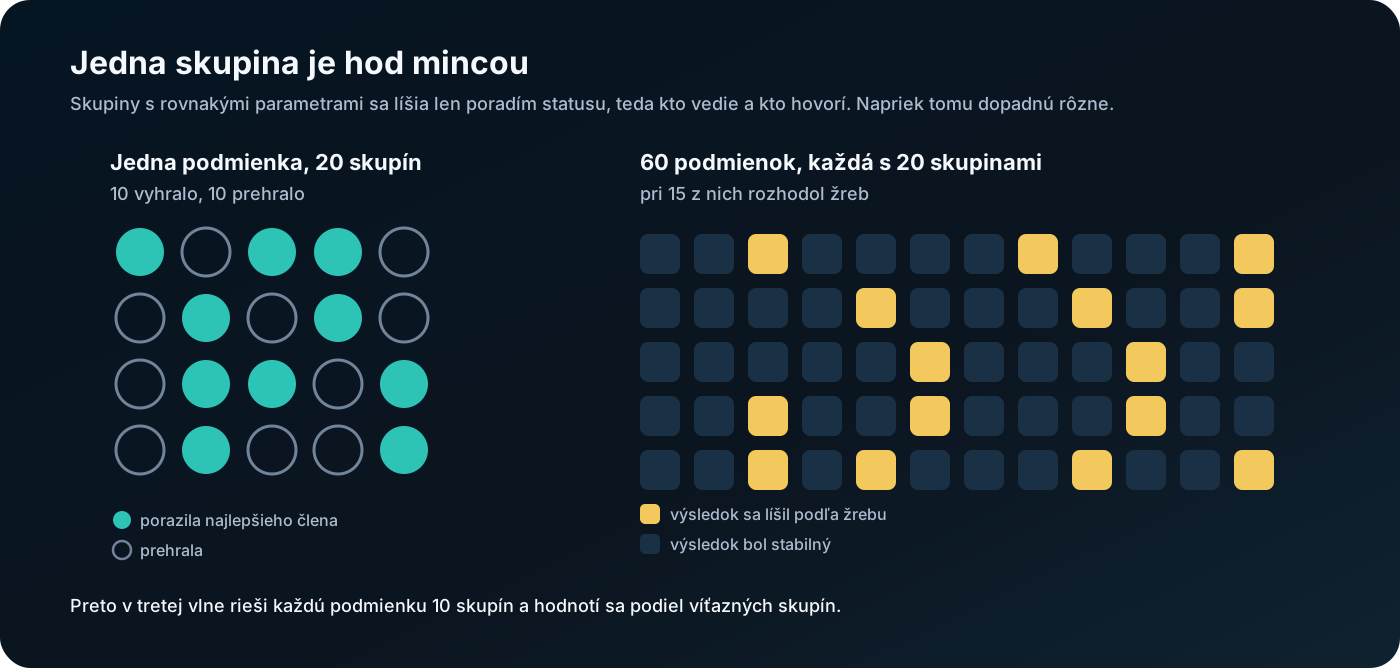
Predstavte si učiteľa, ktorý hodnotí každého žiaka podľa jedinej otázky v písomke. Aj výborný žiak občas dostane päťku a slabý jednotku. Taký šum tvoril neodstrániteľnú chybu Brier skóre 0,025 až 0,032. Samo osebe to nedokazuje, že západka rozhodovala náhodne: rozhoduje rozdiel dvoch teórií na rovnakých podmienkach a ten je menej hlučný. Šum však rozlíšenie jemných rozdielov výrazne sťažuje.
Ponaučenie: sudca musí byť nielen nezávislý, ale aj dostatočne presný. Lean sa pri matematickom dôkaze nemýli, náš sudca pracoval s hlučnými dátami.
Jedna technická drobnosť: jedna odpoveď prišla orezaná, pretože rozhranie modelu vrátilo len posledný blok textu. Sudca ju odmietol pre formát a druhý pokus prešiel.
Nezávislá kritika: šesť návrhov a čo sme s nimi urobili
Po druhej vlne sme dali experiment posúdiť a kritiku sme prijali celú. Posudok pripravil iný AI asistent: preveril simulátor, riadenie tímov aj uložené výsledky, znova spustil testy a prepočítal teórie. Každé tvrdenie, ktoré sa dalo overiť, sme overili sami. Všetky platili.
1. Skryté testy mohli presakovať
Sudca spúšťal kód teórie aj na skrytých dátach. Keď kód spadol, text chyby išiel späť tímu. Teória, ktorá by pri chybe vypísala celú podmienku, by tak prezradila parametre skrytých skúšok, napríklad že sú v nich skupiny so 40 členmi.
V prvých dvoch vlnách sa to nestalo, cesta však existovala. Oprava: skryté sady sa hodnotia až po uzamknutí všetkých teórií. Z validácie sa tím dozvie len „prijaté“ alebo „zamietnuté“ a chyby na skrytých dátach sa nikam nehlásia.
2. Jedna skupina je hlučný štítok
2000 úloh neznamená 2000 nezávislých skupín. Rešpekt, líder aj hovoriaci sa losujú raz pre celú podmienku. Posudok našiel 14 zo 60 podmienok, ktoré pri inom losovaní dali opačný výsledok. My sme namerali 15 zo 60.
Práve tento bod vysvetlil, prečo sa západka v druhej vlne mýlila. Oprava: každú podmienku rieši desať skupín a hodnotí sa podiel tých, ktoré vyhrali. Ukladá sa aj priemerný zisk a jeho rozptyl.
3. Slovné tvrdenia nikto nekontroloval
Sudca hodnotil len funkciu predict(c). Slovné predikcie mohli byť nepravdivé a nikto by to nespoznal. Príklad: diverzita v druhej vlne tvrdila, že „hlavolam s diskusiou nikdy nemá zisk nižší ako −0,01“. Tréningové dáta pritom obsahovali štyri protipríklady, najhorší so ziskom −0,199.
Oprava: každá predikcia je teraz strojovo čitateľná. Hovorí, pre akú oblasť parametrov platí, akú veličinu meria a aký prah musí splniť. Sudca v tej oblasti nasimuluje 40 nových podmienok a tvrdenie potvrdí, alebo vyvráti. Až tak dostáva slovo „falzifikovateľná“ praktický význam.
4. Staré výsledky sa miešali s novými pravidlami
Doplnený report prvej vlny označoval všetky verzie ako „prijaté“, hoci prvá vlna nijakú západku nemala. Napríklad štatistik sa na dodatočne dopočítanej validácii zhoršil z 0,073 na 0,085, a predsa stál v tabuľke ako prijatý. Posudok tiež upozornil, že opakované rozhodovanie podľa rovnakej validácie ju postupne „opotrebúva“. Preto je potrebný záverečný test, ktorý na rozhodovanie nikdy neslúži.
Oprava: starý report sme opravili. Každý beh teraz ukladá konfiguráciu, presné označenie modelu, všetky prompty, kópiu kódu a skutočné rozhodnutia západky. Test a veľké skupiny na rozhodovanie neslúžia nikdy.
5. Čo z laboratória skutočne pomáha?
Posudok navrhol porovnať s rovnakým rozpočtom štyri rôzne optiky, štyroch neutrálnych agentov a jedného agenta. Tiež upozornil, že porovnanie so strojovým učením nie je férové. Agent dostáva opis mechanizmov aj číselný zisk, kým klasifikátory sa učia len výsledok áno/nie.
Oprava: pridali sme silnejšie baseliny, logistickú regresiu s interakciami úloha × proces a gradient boosting učený na zisku. Porovnanie perspektív s neutrálnymi agentmi nás ešte len čaká.
6. Nech tímy navrhujú rozlišujúce experimenty
Najzaujímavejší návrh: po prvých teóriách vybrať podmienky, v ktorých sa ich predpovede najviac rozchádzajú, nasimulovať ich a výsledky vrátiť tímom. Tak pracuje skutočná veda: hľadá experiment, ktorý rozhodne medzi súperiacimi teóriami.
Zárodok toho má už tretia vlna: predikcie sú vlastne experimenty, ktoré si tím sám navrhne. Vlastný výber rozlišujúcich podmienok nás ešte len čaká.
K tomu posudok odporučil ukladať stav po každom kole, aby prerušený beh neprišiel nazmar. Aj to sme zapracovali.
Tretia vlna: presnejší sudca a testované predikcie
V tretej vlne revízie prvýkrát skutočne zlepšovali a odpoveď laboratória bola výrazne presnejšia ako jednotlivé teórie aj baseliny. Beh na nových dátach trval 81 minút a stál 20,55 dolára. Všetkých 12 volaní prešlo napoprvé.
Čo sme zmenili
- Desať skupín na podmienku: šum v hodnotenom cieli klesol zhruba desaťkrát, z 0,025–0,032 na asi 0,003.
- Uzamknutie teórií: test a veľké skupiny sa vyhodnocujú, až keď všetky tímy skončia.
- Testované predikcie: každá teória má tri predikcie vo formáte JSON a sudca ich overí na nových experimentoch.
- Záznam behu: konfigurácia, prompty, kópia kódu a pokračovanie po prerušení.
- Silnejšie baseliny a skladanie celej odpovede zo všetkých blokov textu.
Ako vyzerá testovaná predikcia
Skutočná predikcia štatistika z jeho prvej revízie:
{"claim": "Obyčajný priemer odhadov porazí najlepšieho člena aj pri vysokej kompetencii a veľkej nerovnosti, ak je korelácia chýb veľmi nízka a skupina veľká.",
 "where": {"task": ["estimate"], "process": ["independent"], "skill_mean": [0.75, 1.0],
           "skill_spread": [0.4, 0.9], "correlation": [0.0, 0.1], "n": [9, 12]},
 "stat": "p_beats", "op": ">=", "value": 0.6}
Po ľudsky: pri odhadoch s priemerovaním, veľmi schopnými a nerovnými členmi, takmer nezávislými chybami a 9 až 12 členmi porazí najlepšieho člena aspoň 60 % skupín. Je to odvážne, pretože intuícia hovorí, že medzi expertmi priemer najlepšieho len „rozriedi“. Sudca nasimuloval 40 nových podmienok v tej oblasti a najlepšieho porazilo 100 % skupín. Predikcia svoj prah v testovaných podmienkach splnila.
Aby tímy nemohli pomocou predikcií nahliadnuť do záverečnej skúšky, smeli testovať len skupiny s 3 až 12 členmi.
Výsledky
Metrikou je priemerná kvadratická chyba (MSE) voči podielu víťazných skupín, nižšia je lepšia. Čísla nie sú priamo porovnateľné s Brier skóre prvých dvoch vĺn. Keby sme rovnaké predpovede hodnotili klasickým Brier skóre voči výsledku každej jednotlivej skupiny, mala by odpoveď laboratória 0,062 na teste a 0,070 na veľkých skupinách. Poradie modelov by sa nezmenilo.
| Model | Test | Veľké skupiny |
|---|---|---|
| Odpoveď laboratória | 0,032 | 0,037 |
| Najlepšia jednotlivá teória podľa validácie (minimalista r1) | 0,041 | 0,070 |
| Priemer prvých verzií | 0,064 | 0,057 |
| Logistická regresia s interakciami | 0,086 | 0,175 |
| Gradient boosting | 0,106 | 0,090 |
Odpoveď laboratória porazila najlepšiu baseline podľa validácie, logistickú regresiu, o 0,054 na teste a o 0,138 na veľkých skupinách. Gradient boosting dopadol na veľkých skupinách lepšie (0,090), aj voči nemu je však náskok laboratória 0,053. Najlepšiu prijatú teóriu, ktorá mala zároveň najnižšiu validačnú chybu zo všetkých verzií, porazila o 0,010 na teste, ale len v bodovom odhade, nie štatisticky významne, a o 0,033 na veľkých skupinách, tam významne. Logistická regresia, najlepšia baseline na validácii, sa mimo rozsahu tréningu znova zrútila.
V tejto konfigurácii revízie pomohli
Brier skóre na teste po jednotlivých verziách:
| Tím | r0 | r1 | r2 | Finálna |
|---|---|---|---|---|
| Diverzita | 0,144 | 0,041 | 0,041 | r2 |
| Minimalista | 0,072 | 0,041 | 0,079, zamietnuté | r1 |
| Štatistik | 0,086 | 0,052 | 0,131, zamietnuté | r1 |
| Sociálny psychológ | 0,075 | 0,076, zamietnuté | 0,109, zamietnuté | r0 |
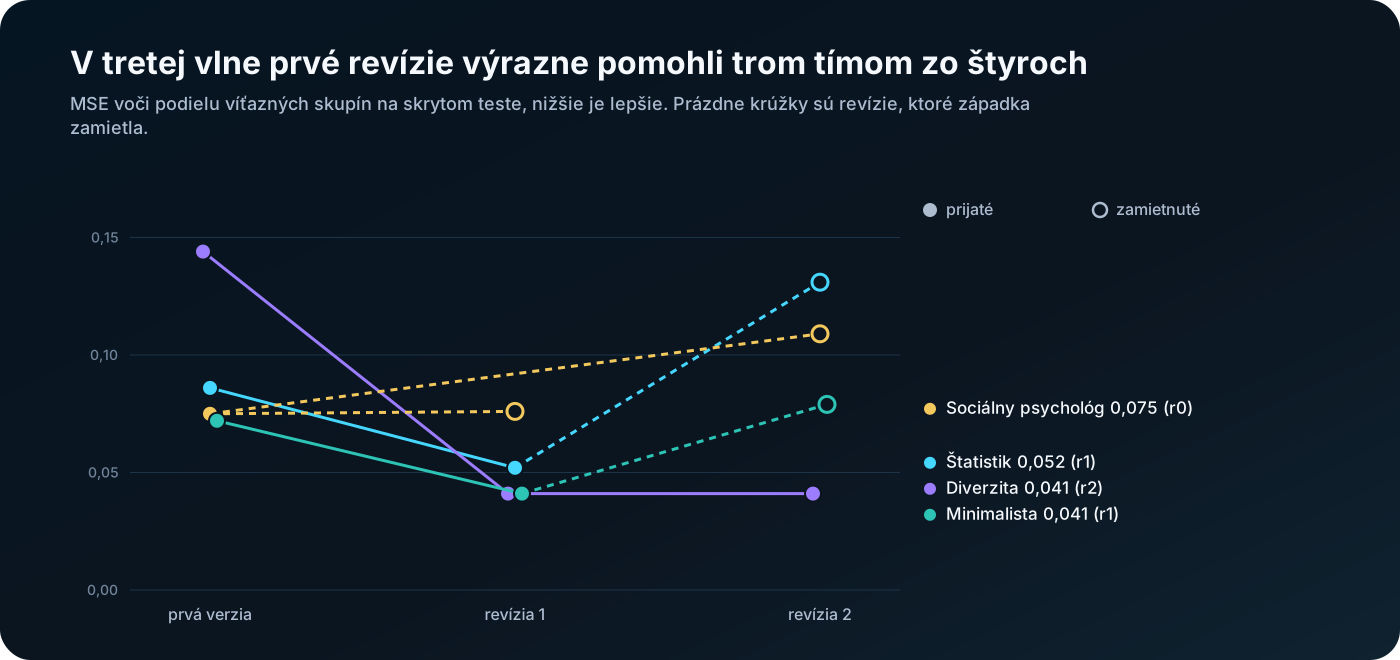
Tri tímy zo štyroch sa v prvej revízii výrazne zlepšili. Štatistik sa na veľkých skupinách zlepšil z 0,106 na 0,046, teda o viac ako polovicu. Diverzita začínala horšie ako baseliny a po revízii patrila medzi najlepšie.
Druhá revízia väčšinou nepomohla: západka zamietla tri zo štyroch. Štatistikova r2 by na teste zhoršila skóre z 0,052 na 0,131. Bez západky by sa do odpovede laboratória dostala.
Západka rozhodla správne v 7 z 8 prípadov, v druhej vlne len v 3 z 8. Jediným zmiešaným rozhodnutím bolo zamietnutie minimalistovej r2, ktorá bola na teste horšia, ale na veľkých skupinách o kúsok lepšia. Odpoveď laboratória je vďaka revíziám významne lepšia ako priemer prvých verzií: o 0,033 na teste a o 0,020 na veľkých skupinách.
Predikcie, ktoré prešli, a tie, ktoré nie
Z 36 predikcií splnilo svoj prah v novo nasimulovaných podmienkach 33. Štyridsať náhodných podmienok môže tvrdenie podporiť alebo nájsť protipríklad, vo všeobecnosti ho však nedokazuje, a pri tesných výsledkoch chýba interval neistoty. Ukážky:
- Splnila prah: „Diskusia pri hlavolame združuje kúsky vedomostí aj pri takmer nulovej demonštrovateľnosti. Skupiny s nízkou koreláciou a slabými až strednými členmi prevýšia najlepšieho člena najmenej o 0,2.“ (minimalista r1). Pozorovaný zisk: 0,33.
- Splnila prah a predpovedá prehru: „Líder pri voľbe sa riadi väčšinou poradcov. Pri silnej korelácii, nerovných zručnostiach a nízkej demonštrovateľnosti skupina prehráva s najlepším aspoň o 2 percentuálne body.“ (minimalista r1). Pozorované: −8 bodov.
- Nesplnila prah, tesne: „Mechanické hlasovanie kopíruje typického člena, pri citeľnej nerovnosti najlepšieho neporazí takmer žiadna skupina (najviac 10 %).“ (diverzita r0). Pozorované: 16 %.
- Nesplnila prah, výrazne: štatistikova r2 tvrdila, že pri hlavolamoch s veľmi schopnými a nerovnými členmi vyhrá najviac 20 % skupín. Pozorované: 97 %.
Predikcie, ktoré prah nesplnili, patrili verziám, ktoré boli slabšie aj podľa čísel. Dve patrili revíziám, ktoré západka zamietla. Tretia patrila prvej verzii diverzity, ktorú tím v ďalšej revízii opravil. Zlyhanie predikcie tak zrejme vypovedá aj o kvalite celej teórie.
Jedna výhrada: úspešnosť 92 % môže znamenať aj to, že tímy formulovali opatrné predikcie. Ich odvahu laboratórium zatiaľ nevie zmerať.
K čomu sme dospeli
Najdôležitejší výsledok: priemer teórií bol vo všetkých troch vlnách lepší ako najlepšia prijatá jednotlivá teória. Laboratórium tak na vlastnej práci predviedlo jav, ktorý skúma. Aký silný je tento výsledok, však závisí od toho, s akou jednotlivou teóriou ho porovnáme. Celkovo sme dospeli k siedmim záverom, ktoré platia pre tento experiment a tieto baseliny.
1. Priemer teórií porazil najlepšiu prijatú teóriu
Priemer predpovedí všetkých tímov bol vo všetkých troch vlnách lepší ako najlepšia prijatá teória, štatisticky významne v druhej vlne na oboch skrytých sadách a v tretej vlne na veľkých skupinách. Keby sme však vyberali jednoducho verziu s najnižšou validačnou chybou zo všetkých, vrátane zamietnutých, v druhej vlne by to bola štatistikova r2 a tá bola na teste lepšia ako priemer (0,070 oproti 0,075). Výhoda priemeru teda závisí od spôsobu výberu: oproti najlepšej prijatej teórii je jasná, oproti minimu validácie len čiastočná.
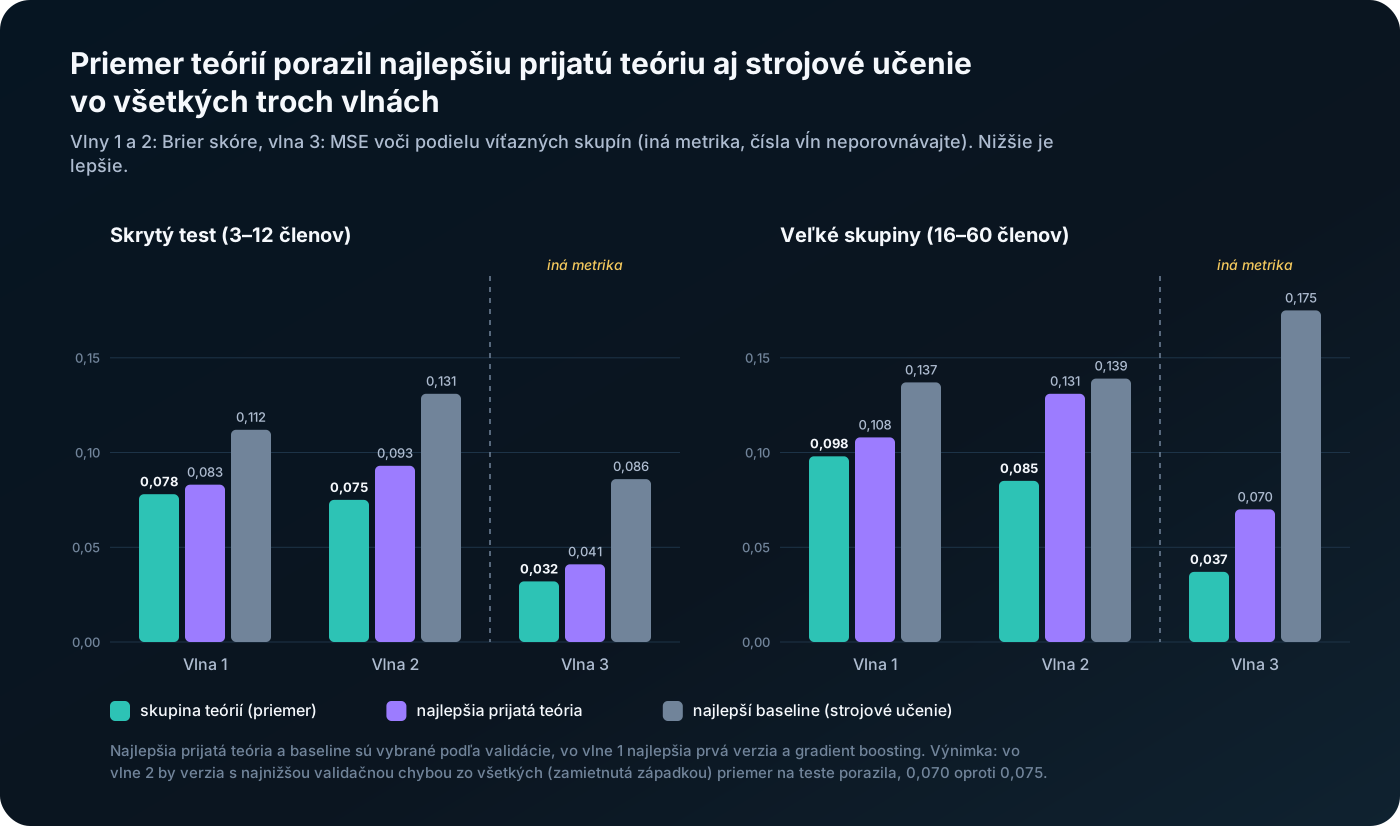
Pravdepodobný dôvod poznáme z kapitoly o múdrosti davu. Štatistik, diverzita, sociálny psychológ a minimalista sa mýlili na rôznych miestach a priemer ich chyby rušil. Keby všetky tímy dostali rovnaké zadanie, ich chyby by boli viac korelované a výhoda by sa zmenšila. Túto hypotézu chceme otestovať nabudúce.
2. Teórie extrapolovali lepšie ako použité baseliny
Odpoveď laboratória porazila najlepšiu baseline vo všetkých troch vlnách. Najväčší náskok mala na veľkých skupinách, ktoré nikto nevidel: v tretej vlne 0,037 oproti 0,175 pri najlepšej baseline podľa validácie a oproti 0,090 pri gradient boostingu.
Mechanizmus ako „chyba priemeru sa zmenší na √(ρ + (1 − ρ) / n)“ platí pre skupinu 50 ľudí rovnako ako pre skupinu 5 ľudí. Priamka napasovaná na skupiny s 3 až 12 členmi mimo svojho rozsahu nedáva zmysel. To je dobrý dôvod hľadať mechanizmy, nie len napasovať krivku na dáta. Platí to však pre naše konkrétne baseliny a v tretej vlne mali tímy navyše cielenú spätnú väzbu z ďalších simulácií, ktorú baseliny nedostali.
3. Revízie pomohli až v tretej konfigurácii
V prvých dvoch vlnách revízie škodili. V tretej vlne zlepšovali a západka rozhodovala správne v 7 z 8 prípadov. Zatiaľ však nevieme prečo: zmenilo sa opakovanie skupín, spätná väzba z nových experimentov aj dáta a úlohu mohla zohrať aj náhoda.
Naša pracovná hypotéza znie: úzkym hrdlom slučky „navrhni, over, oprav“ nie je model, ale kvalita spätnej väzby. Overia ju až kontrolované porovnania, ktoré opisujeme v kapitole Čo ďalej.
4. Západka je nutná aj s dobrým sudcom
Aj v tretej vlne bola druhá revízia väčšinou horšia ako prvá. Model po spätnej väzbe radšej prestavia celú teóriu, než by ju opatrne spresnil. Bez západky by sa dobré revízie stratili pod zlými.
5. AI vie objaviť skryté mechanizmy, kapacitné limity sú najťažšie
Tímy sa priblížili k väčšine pravidiel simulátora, pri niektorých vrátane konštánt: 0,3 × nerovnosť, 0,5 + 0,5 × demonštrovateľnosť, 6 hovoriacich, strop úspešnosti 0,95. Iné odhady boli len približné alebo opisovali odlišný mechanizmus, ako ukazuje tabuľka v kapitole o prvej vlne. Najhoršie odhadovali limity, ktoré sa prejavia až pri veľkých skupinách: počet kúskov vedomostí a počet poradcov lídra. Z dát o malých skupinách sa takmer nedajú spoznať.
6. Falzifikovateľné predikcie majú cenu
Tri predikcie, ktoré nesplnili svoj prah, patrili slabším verziám teórií. Predikcie dávajú sudcovi druhý, nezávislý kanál: nehodnotí len čísla, ale aj to, či teória hovorí pravdu o konkrétnych situáciách. A nútia ju povedať niečo, čo nemusí platiť.
7. Infraštruktúra je polovica výskumu
Zaseknuté volania, orezané odpovede, chyba sandboxu a možný únik dát zo skrytých testov: každá z týchto drobností mohla skresliť výsledok. Bez záznamu konfigurácie a možnosti pokračovať po prerušení by sa výsledky nedali zopakovať ani overiť.
Odpoveď simulovaného sveta na našu otázku
Na 4 500 podmienkach sme zmerali, ako jednotlivé faktory ovplyvňujú šancu skupiny poraziť najlepšieho člena:
| Faktor | Nízka hodnota (0–0,25) | Vysoká hodnota (0,75–1) |
|---|---|---|
| Korelácia chýb | 81 % | 36 % |
| Nerovnosť kompetencie | 80 % | 47 % |
| Demonštrovateľnosť | 47 % | 73 % |
| Viditeľnosť kompetencie | 53 % | 68 % |
Skupina teda porazí svojho najlepšieho člena, keď:
- chyby a medzery vo vedomostiach členov nie sú korelované,
- kompetencie nie sú príliš nerovné,
- dá sa rozpoznať správna odpoveď alebo je vidieť, kto je kompetentný,
- úloha vyžaduje skladať rôzne vedomosti.
Pri hlavolamoch skupina vyhráva v 68–94 % podmienok. Pri obyčajnom hlasovaní o otázke s dvoma možnosťami len v 10–21 %. Priemerná kompetencia a veľkosť skupiny majú celkovo len malý vplyv, v jednotlivých situáciách však veľký: väčšia skupina pomáha hlasovaniu, diskusii naopak škodí.
Pozor: tieto pravidlá sme do simulátora vložili my, podľa učebníc. Je to odpoveď nášho modelu sveta, nie nový objav o ľuďoch.
Čo to znamená pre AI agentov a pre ľudské tímy
Rovnaké pravidlá, ktoré rozhodujú, kedy skupina ľudí porazí svojho najlepšieho člena, rozhodujú aj o tom, kedy skupina AI agentov porazí najlepšieho agenta. Nasledujúce odporúčania sú naša interpretácia. Opierajú sa o experiment a hlavne o odbornú literatúru, nie všetky sme v laboratóriu priamo testovali.
Pre systémy s viacerými AI agentmi
- Rozmanitosť namiesto klonov. Dajte agentom rôzne optiky, roly alebo aj rôzne modely. Klony sa mýlia rovnako a hlasovanie ani priemer im potom nepomôže. Priemer našich štyroch optík porazil najlepšiu prijatú teóriu.
- Nezávislé návrhy, potom priemer. Pri číselných a pravdepodobnostných výstupoch nechajte agentov pracovať nezávisle a ich odpovede spriemerujte. Spoločná debata môže viesť k stádovému správaniu, keď sa agenti priklonia k tomu najpresvedčivejšiemu. Debatu agentov sme v laboratóriu netestovali, vychádzame z výskumu ľudských skupín.
- Externý sudca. Testy, simulácie, formálna kontrola alebo merateľná metrika. Nenechávajte modely, aby hodnotili samy seba.
- Najprv presné hodnotenie, potom viac iterácií. Hlučný hodnotiteľ robí z iterácií lotériu. Do kvality overovania sa oplatí investovať skôr ako do ďalších kôl.
- Západka. Zmenu prijmite, len keď zlepší výsledok na dátach, ktoré agent nevidel, a to o rozumný kus. Vždy si držte najlepšiu verziu.
- Overiteľné tvrdenia. Žiadajte od agentov konkrétne tvrdenia, ktoré sa dajú automaticky skontrolovať, a kontrolujte ich.
- Prevádzka. Obmedzte počet súbežných volaní, zaznamenávajte konfiguráciu a prompty a píšte behy tak, aby sa dali po prerušení dokončiť.
Pre ľudské tímy
- Keď sa dá správna odpoveď predviesť, napríklad pri výpočte, kóde alebo testovateľnej diagnóze, diskutujte. Stačí jeden človek so správnym riešením, ak ho ostatní dokážu overiť.
- Pri odhadoch a úsudkoch, kde sa odpoveď predviesť nedá, zbierajte názory nezávisle pred diskusiou. Inak sa všetci ukotvia pri prvom čísle alebo pri najhlasnejšom človeku. Na tomto princípe stojí napríklad plánovací poker v agilných tímoch alebo metóda Delphi.
- Keď viete, kto je expert, nechajte rozhodnúť jeho po konzultácii s ostatnými. Keď to neviete, je priemer nezávislých názorov bezpečnejší ako líder vybraný podľa sebavedomia.
- Rôzne skúsenosti znižujú korelované chyby. Tím ľudí z tej istej školy, ktorí čítajú rovnaké správy, zdieľa aj rovnaké slepé miesta.
- Na veľkej porade väčšina vedomostí nezaznie. Zbierajte unikátne informácie písomne vopred a pýtajte sa každého, čo vie len on.
- Hlasovanie o záludných otázkach chybu zosilní. Kde môže väčšina naletieť na zavádzajúcu intuíciu, nerozhodujte jednoduchou väčšinou.
Obmedzenia: čo experiment nedokazuje
Experiment ukazuje, že AI dokáže objavovať a spresňovať teórie skrytého systému. Neukazuje nič nové o skutočných ľuďoch a má niekoľko slabín, o ktorých je férové vedieť.
- Svet je náš model. Pravidlá simulátora sme vzali z učebníc. Tímy mohli objaviť len to, čo sme doň vložili.
- Každá vlna je jeden beh na iných dátach. Rozdiely medzi vlnami môžu sčasti vyplývať z dát a zo šťastia tímov. Potrebujeme viac opakovaní.
- Tretia vlna zmenila niekoľko vecí naraz. Presnejší cieľ, testované predikcie v spätnej väzbe a ochrana skrytých dát prišli súčasne. Zatiaľ nevieme, ktorá zmena zlepšenie revízií spôsobila.
- Tímy majú náskok vo vedomostiach. Model pozná Condorceta aj Laughlina, baseliny nie. Porovnanie ukazuje hodnotu predchádzajúcich vedomostí a mechanizmov, nie všeobecnú prevahu jazykových modelov nad strojovým učením.
- Predikcie môžu byť opatrné. Úspešnosť 92 % je dobrá správa len vtedy, keď predikcie niečo riskujú. To zatiaľ nemeriame.
- Malé vzorky. Každá sada má 300 podmienok, takže rozdiely okolo 0,01 Brier skóre sú často v šume. Preto pri kľúčových porovnaniach uvádzame 95-percentné intervaly spoľahlivosti z bootstrapu.
- Výber porovnania. Výhoda priemeru teórií závisí od toho, s akou jednotlivou teóriou ho porovnáme. Oproti najlepšej prijatej teórii vyhral vo všetkých vlnách, oproti verzii s najnižšou validačnou chybou v druhej vlne na teste prehral.
- Metrika tretej vlny je MSE voči podielu víťazných skupín, nie klasické Brier skóre. Čísla rôznych vĺn preto priamo neporovnávame.
- Jeden model. Všetky tímy bežali na Claude Opus 5.5. Iné modely alebo ich zmes sa môžu správať inak.
Čo ďalej
Najbližším krokom je zistiť, čo presne v tretej vlne zlepšenie spôsobilo. Potom chceme laboratórium pustiť na svet, ktorý sme sami nenaprogramovali.
- Ablácia tretej vlny. Rovnaké laboratórium pustíme dvakrát: raz bez testovaných predikcií v spätnej väzbe a raz s jedinou skupinou na podmienku. Ukáže sa, či revízie zlepšil presnejší sudca, alebo predikcie. Odhadom 2 × 20 dolárov.
- Perspektívy oproti neutrálnym agentom. Štyri rôzne optiky, štyria neutrálni agenti a jeden agent s rovnakým rozpočtom. Ak máme pravdu, že sila priemeru teórií pramení z rôznych chýb, neutrálni agenti budú mať chyby viac korelované a ich priemer bude slabší.
- Rozlišujúce experimenty. Po prvých teóriách laboratórium nájde podmienky, kde sa ich predpovede najviac rozchádzajú, nasimuluje ich a výsledky vráti tímom. Časť rozpočtu pripadne na náhodný výber ako kontrolu.
- Odvaha predikcií. Zmeriame, akú veľkú časť priestoru predikcia zakazuje, a odvážne predikcie, ktoré platia, budeme odmeňovať viac ako opatrné.
- Viac opakovaní. Niekoľko behov každej verzie na rôznych dátach, aby sa dalo oddeliť šťastie od schopnosti.
- Skutočné skupiny. Simulovaných členov nahradíme skupinami AI agentov, ktoré riešia skutočné úlohy: odhady, logické hádanky, faktické otázky. Svet potom nebude náš model a teórie môžu objaviť niečo, čo doň nikto nevložil. Neskôr by sa dali zapojiť aj skupiny ľudí, s informovaným súhlasom a etickým dohľadom.
- Filozofia. Rovnakú slučku možno použiť aj na filozofické argumenty. Formálna logika overí, či záver z premís naozaj vyplýva. Pravdivosť premís však žiadny sudca neoverí, a práve o ňu sa vo filozofii zvyčajne vedie spor. AI by tu mohla aspoň systematicky odhaľovať skryté predpoklady, z ktorých jednotlivé závery vyplývajú.
Experiment v číslach
| Položka | Hodnota |
|---|---|
| Vlny experimentu | 3, k tomu doplnenie prvej vlny |
| Tímy AI | 4, model Claude Opus 5.5 (claude-opus-5-5) |
| Verzie teórií | 36: 4 tímy × 3 verzie × 3 vlny |
| Volania modelu | 41, z toho 4 zaseknuté, všetky v prvej vlne |
| Celkový čas behu | 358 minút, teda zhruba 6 hodín |
| Cena podľa cenníka | 63,43 USD: 18,21 + 24,67 + 20,55 |
| Podmienok v jednej vlne | 900 až 1 200 |
| Úloh pre každú skupinu | 2 000 |
| Skupín na podmienku v tretej vlne | 10 |
| Testovaných predikcií | 36, z toho 33 splnilo svoj prah |
| Najlepší výsledok | MSE 0,032 na teste a 0,037 na veľkých skupinách (tretia vlna, odpoveď laboratória) |
Všetky dáta, teórie a grafy nájdete v interaktívnom reporte (v češtine).
Slovníček pojmov
- Baseline: porovnávací model strojového učenia bez teórie, napríklad gradient boosting.
- Brier skóre: priemerná kvadratická chyba predpovedanej pravdepodobnosti. 0 je dokonalá predpoveď, 0,25 hádzanie mincou.
- Bootstrap a 95-percentný interval spoľahlivosti: opakované prevzorkovanie dát. Keď interval rozdielu nezahŕňa nulu, rozdiel je štatisticky významný.
- Demonštrovateľnosť: ako ľahko ostatní spoznajú, že vyslovená odpoveď je správna.
- Extrapolácia: predpoveď mimo rozsahu dát, z ktorých sa model učil.
- Falzifikovateľná predikcia: tvrdenie, ktoré môže experiment vyvrátiť.
- Korelácia chýb: ako veľmi sa členovia skupiny mýlia rovnako.
- Lean: program na formálne overovanie matematických dôkazov.
- MSE voči podielu víťazných skupín: metrika tretej vlny, priemerná kvadratická chyba predpovede voči podielu skupín, ktoré porazili najlepšieho člena.
- p_beats: podiel skupín, ktoré porazili svojho najlepšieho člena.
- Sandbox: izolované prostredie, kde kód teórie beží bez prístupu k súborom a sieti.
- Validácia: dáta, podľa ktorých sa rozhoduje o prijatí revízie. Tím ich nikdy nevidí.
- Západka: pravidlo, ktoré prijme zmenu len vtedy, keď preukázateľne zlepší výsledok.
Zdroje
- Physical Superintelligence: výskumná stránka k dôkazu domnienky Aaronsona a Ambainisa a formalizácia v Leane na GitHube.
- Francis Galton: Vox Populi, Nature 75, 1907.
- Marquis de Condorcet: Essai sur l'application de l'analyse à la probabilité des décisions rendues à la pluralité des voix, 1785.
- Patrick R. Laughlin, Alan L. Ellis: Demonstrability and social combination processes on mathematical intellective tasks, Journal of Experimental Social Psychology 22, 1986.
- Garold Stasser, William Titus: Pooling of unshared information in group decision making, Journal of Personality and Social Psychology 48, 1985.
- Ivan D. Steiner: Group Process and Productivity, Academic Press, 1972.
- Shane Frederick: Cognitive Reflection and Decision Making, Journal of Economic Perspectives 19, 2005 (úloha s pálkou a loptičkou).