Laboratorium teorii: kiedy grupa jest mądrzejsza od swojego najmądrzejszego członka
Cztery instancje modelu językowego proponowały i poprawiały teorie predykcyjne ukrytego symulatora grupowego podejmowania decyzji. W trzech przebiegach eksploracyjnych śledziliśmy ich dokładność, korzyści z rewizji i z uśredniania przewidywań. Połączenie teorii przewyższyło użyte modele uczenia maszynowego; przewaga nad pojedynczymi teoriami zależała od tego, jak je wybierzemy. Eksperyment pokazał też, jak na wyniki wpływają szum pomiarowy i forma informacji zwrotnej.
Dlaczego zbudowaliśmy Laboratorium teorii
Zbudowaliśmy małe laboratorium badawcze, w którym cztery zespoły sztucznej inteligencji same wymyślają, testują i poprawiają teorie naukowe. W ciągu jednego dnia odbyły się trzy fale eksperymentu: 36 teorii, 41 wywołań modelu Claude Opus i mniej więcej sześć godzin obliczeń za 63 dolary. Wspólna odpowiedź laboratorium przewidywała lepiej niż użyte modele uczenia maszynowego, a we wszystkich trzech falach także lepiej niż najlepsza przyjęta pojedyncza teoria. To, jak duża jest ta przewaga, zależy jednak od tego, jak wybierzemy pojedynczą teorię.
Inspiracją było ogłoszenie startupu Physical Superintelligence (PSI) z listopada 2026 roku. Według autorów jego system badawczy z niepublicznym modelem firmy Anthropic udowodnił hipotezę matematyczną z 2008 roku. Dowód sprawdził Lean, program, który weryfikuje każdy krok logiczny. W chwili ogłoszenia był to świeży preprint, a niezależna ocena dopiero trwała.
Nas zainteresowała przede wszystkim metoda. AI nikogo w niej nie przekonywała retoryką. Proponowała, a niezależny, nieprzekupny sędzia decydował, co jest prawdą. Zasada „generator hipotez + niezależny sędzia + wielokrotne ulepszanie” jest ogólna.
Postawiliśmy więc pytanie: czy ta sama pętla działa także poza matematyką? Czyli tam, gdzie nie ma żadnego Leana, na przykład w psychologii albo w filozofii?
W artykule znajdziesz:
- jakie pytanie badaliśmy i co nauka już o nim wie,
- jak działa laboratorium, krok po kroku i na przykładach,
- trzy fale eksperymentu, łącznie z błędami, które popełniliśmy po drodze,
- niezależną krytykę, którą otrzymaliśmy, i co z nią zrobiliśmy,
- do czego doszliśmy i co to oznacza dla zespołów ludzi i agentów AI.
Artykuł jest długi, lektura zajmie około pół godziny. Kto się spieszy, może od razu przejść do rozdziału Do czego doszliśmy.
Interaktywny raport: wszystkie 36 teorii w pełnym brzmieniu, wykresy, statystyki i każdą decyzję zapadki znajdziesz w interaktywnym raporcie (po czesku).
W skrócie
Co mierzyliśmy: jak dokładnie teorie napisane przez AI przewidują wyniki ukrytego symulatora grupowego podejmowania decyzji. Nie były to eksperymenty z ludźmi. Miarą jest błąd przewidywania probabilistycznego: w pierwszych dwóch falach wynik Briera, w trzeciej fali MSE względem odsetka zwycięskich grup. Niższy jest lepszy, a liczb z trzeciej fali nie porównuje się bezpośrednio z dwiema pierwszymi.
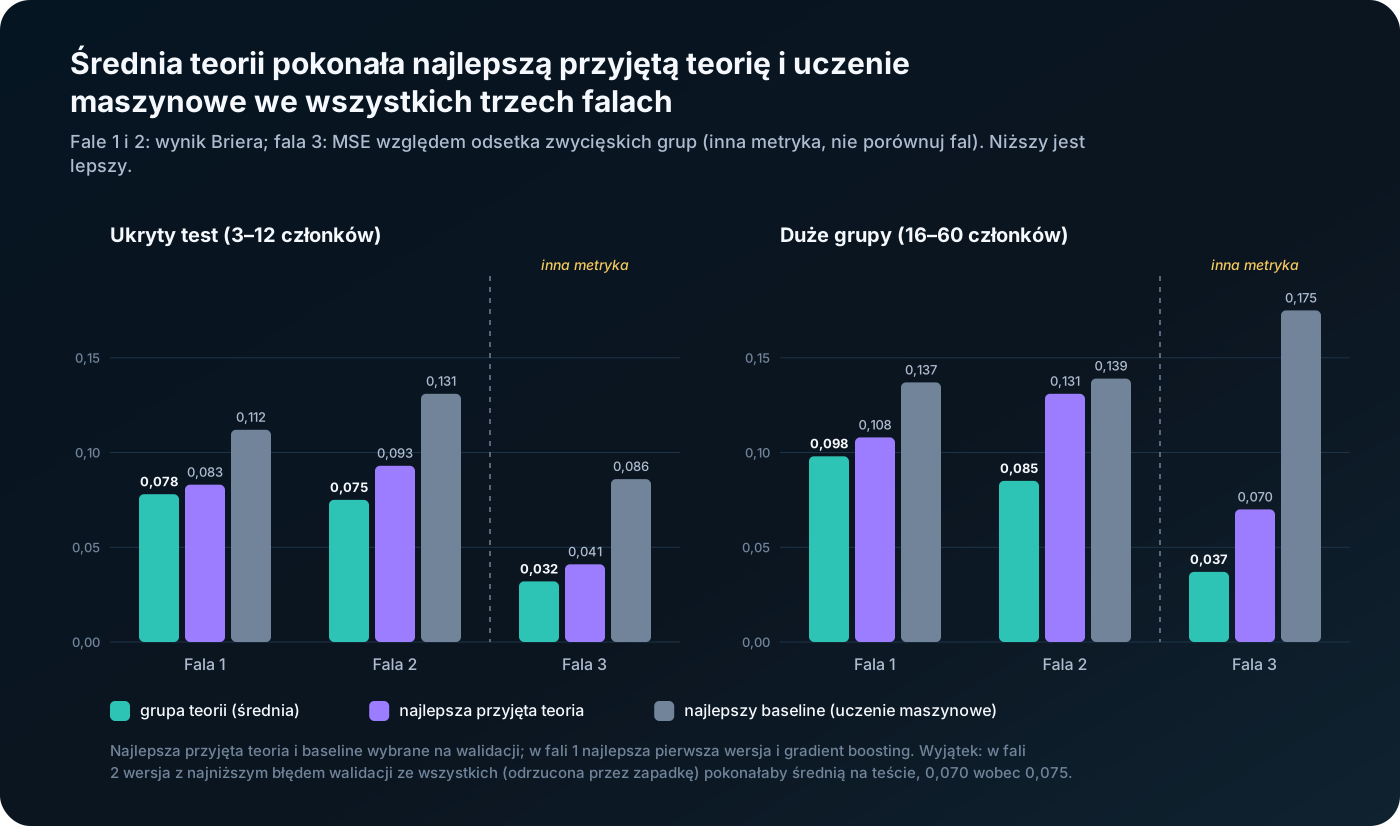
| Fala | Odpowiedź laboratorium | Najlepsza przyjęta teoria | Najlepszy baseline |
|---|---|---|---|
| 1 | 0,078 / 0,098 | 0,083 / 0,108 | 0,112 / 0,137 |
| 2 | 0,075 / 0,085 | 0,093 / 0,131 | 0,131 / 0,139 |
| 3 (inna metryka) | 0,032 / 0,037 | 0,041 / 0,070 | 0,086 / 0,175 |
Wartości w tabeli: ukryty test / duże grupy. W fali 1 nie było jeszcze zapadki, dlatego odpowiedzią laboratorium jest średnia pierwszych wersji, a najlepszą teorią najlepsza pierwsza wersja. Jeden wyjątek: w drugiej fali wersja z najniższym błędem walidacji spośród wszystkich, którą zapadka odrzuciła, pokonałaby średnią na teście (0,070 wobec 0,075), ale na dużych grupach już nie (0,106 wobec 0,085).
Pytanie: kiedy grupa jest mądrzejsza od swojego najlepszego członka
Badaliśmy jedno pytanie: w jakich warunkach grupa jest inteligentniejsza od swojego najinteligentniejszego członka? Nie pytamy, czy grupa jest lepsza od przeciętnego członka. To zwykle jest łatwe. Pytamy, czy potrafi pokonać najlepszą osobę, która w niej zasiada.
Wyobraź sobie naradę pięciu lekarzy, z których jeden jest wybitnym specjalistą. Jeśli grupa tylko uśredni opinie, słabsze głosy „rozwodnią” zdanie specjalisty. Aby grupa go pokonała, musi dodać coś, czego on sam nie ma: inną informację, inny punkt widzenia albo poprawkę jego błędu.
Kiedy grupy wygrywają, a kiedy przegrywają, pokazują cztery typowe sytuacje:
- Grupa wygrywa: sto osób zgaduje liczbę cukierków w słoiku. Średnia z typów jest zwykle bliżej prawdy niż niemal każda pojedyncza osoba, bo przeszacowanie w jedną stronę znosi niedoszacowanie w drugą.
- Grupa wygrywa: samochód nie chce zapalić, a awaria ma trzy przyczyny. Elektryk znajdzie uszkodzony kabel, mechanik zatkany filtr, a programista błąd w jednostce sterującej. Nikt z nich nie naprawiłby samochodu sam, razem tak.
- Grupa przegrywa: ława przysięgłych odpowiada na podchwytliwe pytanie, na które większość ludzi intuicyjnie odpowiada źle. Głosowanie nie zniesie błędu, tylko go potwierdzi.
- Grupa przegrywa: na naradzie decyduje najgłośniejsza i najbardziej pewna siebie osoba, a nie najbardziej kompetentna. Grupa jest wtedy tylko tak mądra, jak dobrze status jej członków odpowiada ich rzeczywistym kompetencjom.
Pytanie ma dziś bardzo praktyczny wymiar, zarówno w przypadku ludzi, jak i sztucznej inteligencji:
- Firmy i zespoły zastanawiają się, kiedy zwołać naradę, kiedy pozwolić zdecydować ekspertowi, a kiedy po prostu głosować.
- Twórcy AI rutynowo łączą dziś wielu agentów: jeden pisze, drugi sprawdza, trzeci głosuje. Kiedy powstaje z tego coś mądrzejszego od najlepszego agenta, a kiedy tylko drogi szum?
- Nauka spotyka się tu z trzech stron: filozofia pyta, czym jest poznanie zbiorowe, psychologia bada, jak grupy podejmują decyzje, a informatyka buduje systemy z wielu modeli.
W naszym eksperymencie „pokonać najlepszego członka” ma precyzyjne znaczenie. Najlepszy członek to ten, który naprawdę ma najwyższe kompetencje i rozwiązuje te same zadania co grupa, tylko sam. Sama grupa nie musi wiedzieć, kto to jest. Wygrywa, gdy jej skuteczność jest wyższa co najmniej o jeden punkt procentowy, a w przypadku szacowania, gdy jej błąd jest mniejszy co najmniej o 1%.
Co już wiemy o inteligencji zbiorowej
Nauka zna sześć mechanizmów, które decydują o tym, czy grupa pokona swojego najlepszego członka. Wszystkie później umieściliśmy w symulowanym świecie, a zespoły AI miały je odkryć na nowo, nie widząc tego świata od środka.
1. Mądrość tłumu i skorelowane błędy
W 1906 roku na targu bydła w angielskim Plymouth prawie 800 osób zgadywało wagę wołu. Środkowy z podanych typów różnił się od rzeczywistej wagi o niecały 1%. Średnia działa, ponieważ niezależne błędy wzajemnie się znoszą.
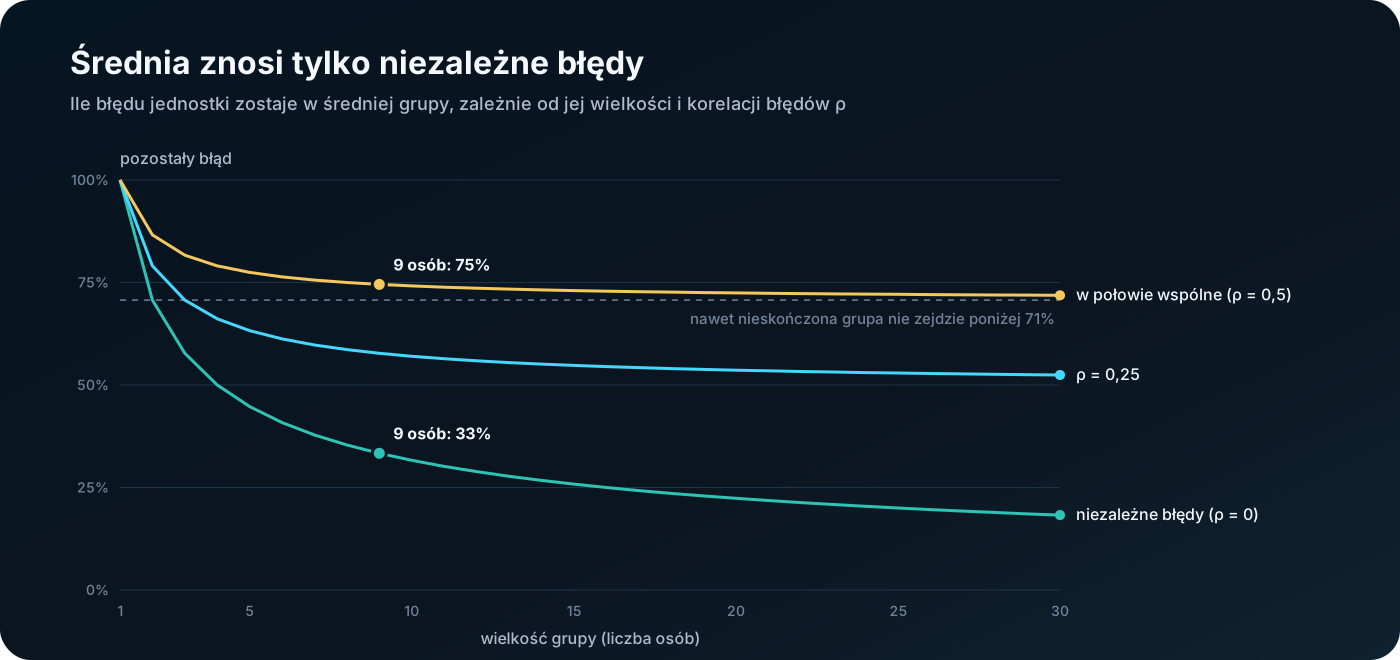
Haczyk tkwi w słowie niezależne. Jeśli wszyscy przeczytali ten sam mylący artykuł, mylą się w tym samym kierunku i średnia błędu nie zniesie. Matematycznie: błąd średniej zmniejsza się do √(ρ + (1 − ρ) / n) błędu pierwotnego, gdzie n to wielkość grupy, a ρ korelacja błędów. Obowiązuje to przy założeniu, że wszyscy mają równie duże błędy, a każda para członków taką samą korelację. W przypadku średniego błędu bezwzględnego zakładamy ponadto, że błędy mają rozkład normalny.
- Dziewięć osób z niezależnymi błędami (ρ = 0) zmniejsza błąd do jednej trzeciej.
- Dziewięć osób, których błędy są w połowie wspólne (ρ = 0,5), zmniejsza go tylko do około 75%.
- A gdy jeden członek jest znacznie dokładniejszy od pozostałych, średnia wręcz „rozwodni” jego precyzję.
2. Twierdzenie Condorceta i jego odwrócenie
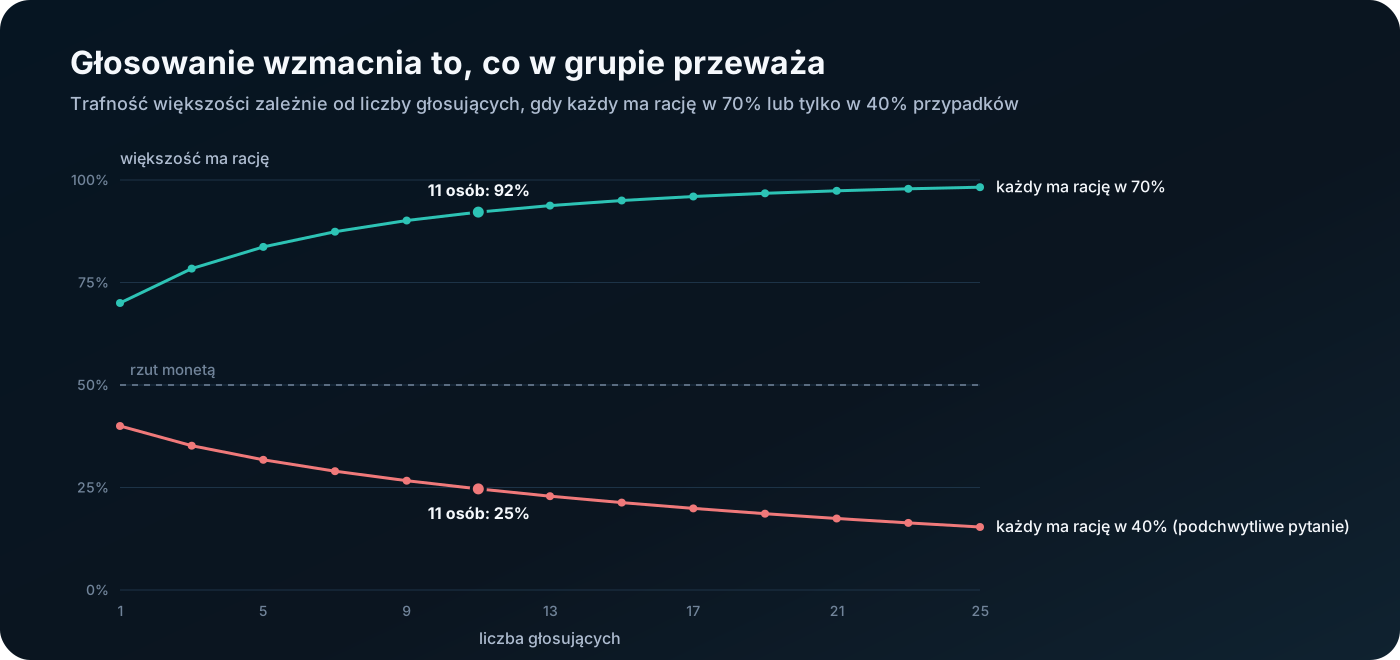
Markiz de Condorcet w 1785 roku pokazał, że większość może być mądrzejsza od jednostek. Jeśli wszyscy przysięgli mają taką samą szansę na poprawną odpowiedź, większą niż 50%, i decydują niezależnie, większość ma rację częściej niż którykolwiek z nich. Jedenastu przysięgłych, z których każdy ma rację w 70% przypadków, zdecyduje większością głosów poprawnie w około 92% przypadków. Założenie jednakowej skuteczności jest ważne. Trzech niezależnie głosujących ze skutecznością 99%, 51% i 51% ma większością głosów rację tylko w około 75% przypadków, więc wyraźnie pogarsza wynik swojego najlepszego członka. To także jest odpowiedź na nasze pytanie.
Twierdzenie działa jednak także w odwrotną stronę. Weźmy podchwytliwe pytanie: Kij i piłka kosztują razem 1,10 zł, kij jest o 1,00 zł droższy niż piłka. Ile kosztuje piłka? Większość ludzi intuicyjnie odpowiada 10 groszy, a poprawnie jest 5 groszy. Jeśli każdy ma rację tylko w 40% przypadków, większość jedenastu osób zdecyduje poprawnie tylko w około 25%. Głosowanie nie zniesie błędu, tylko go wzmocni.
3. Demonstrowalność: prawda zwycięża
Psycholog Patrick Laughlin rozróżnił zadania według tego, czy poprawną odpowiedź da się zademonstrować. W przypadku zadania matematycznego albo zagadki wystarczy, że rozwiązanie znajdzie jedna osoba. Gdy tylko je wypowie, pozostali od razu rozpoznają, że jest poprawne, i „prawda zwycięża”.
W innych zadaniach to niemożliwe. Które logo jest lepsze, który kandydat będzie dobrym kolegą, jakie wino jest najlepsze? Tam poprawna odpowiedź nie przekonuje sama przez się i decyduje większość albo status.
4. Ukryte profile: wiedza, której nikt nie wypowiada
Garold Stasser i William Titus w 1985 roku odkryli, że grupy w dyskusji poświęcają uwagę głównie informacjom, które już wszyscy znają. Unikalna informacja, którą ma tylko jedna osoba, często w ogóle nie pada.
Przykład: komisja rekrutacyjna wybiera między kandydatami A i B. Każdy członek zna inną słabość kandydata A, więc każdemu z osobna A wychodzi na najlepszego. Gdyby połączyli swoją wiedzę, wyraźnie wygrałby B. Dyskusja kręci się jednak wokół wspólnie znanych zalet kandydata A. Wiedza komplementarna jest więc najsilniejszym źródłem przewagi grupy, a zarazem najbardziej kruchym.
5. Status i widoczność kompetencji
Grupy słuchają tych, którzy sprawiają wrażenie kompetentnych: pewnych siebie, starszych stażem, głośnych. Gdy to wrażenie odpowiada rzeczywistym kompetencjom, lider albo ważona dyskusja działają świetnie. Gdy nie, grupa podąża za pewnym siebie, który się myli. Przykład: najbardziej doświadczony inżynier w zespole jest cichy, a decyduje nowy, pewny siebie menedżer.
6. Straty procesowe i wielkość grupy
Ivan Steiner w 1972 roku ujął wydajność grupy jako potencjał minus straty procesowe. Straty biorą się z koordynacji, z ograniczonego czasu, z konformizmu albo z tego, że ktoś „jedzie na gapę”. Większa grupa ma większy potencjał, ale też większe straty. Na godzinnej naradzie trzydziestu osób decyzję w rzeczywistości kształtuje tylko kilka najaktywniejszych.
Żaden z tych mechanizmów sam nie rozstrzyga pytania. Wynik zależy od ich współdziałania, a to jest dokładnie zadanie dla teorii: połączyć je tak, by przewidziała także sytuacje, których nikt wcześniej nie widział.
Główna idea: AI proponuje, niezależny sędzia decyduje
Nasza główna idea jest prosta: model nie może oceniać sam siebie. Teorie proponuje sztuczna inteligencja, ale o tym, czy są słuszne, decyduje niezależny sędzia, którego nie da się przekonać elokwencją.
Dlaczego nie wystarczy, żeby kilka chatbotów się porozumiało? Modele językowe są przekonujące, a debata kilku z nich zmierza ku temu, co brzmi najlepiej, a nie ku temu, co jest prawdą. Głosowanie modeli napotyka ponadto problem Condorceta z poprzedniego rozdziału. Gdy wszystkie modele mają ten sam ślepy punkt, głosowanie go tylko potwierdzi. Pytanie, które badamy, dotyczy więc także naszej własnej metody.
W matematyce sędzią jest Lean. W psychologii nie ma żadnego Leana, a eksperymenty z ludźmi są powolne i drogie. Zbudowaliśmy więc symulowany świat: program, który symuluje grupy ludzi rozwiązujące zadania i w eksperymencie odgrywa rolę natury. Zespoły AI nigdy nie widzą jego kodu, tak jak naukowiec nie widzi praw natury. Znają tylko opis eksperymentu i jego wyniki.
| PSI (matematyka) | Laboratorium teorii (inteligencja zbiorowa) | |
|---|---|---|
| Kto proponuje | niepubliczny model firmy Anthropic | cztery zespoły Claude Opus 5.5, każdy z inną perspektywą badawczą |
| Kto ocenia | Lean, weryfikacja dowodów | symulowany świat i sandbox, który uruchamia kod teorii |
| Co jest weryfikowane | każdy krok logiczny dowodu | przewidywania teorii dla sytuacji, których zespół nigdy nie widział |
| Kiedy zmiana zostaje przyjęta | tylko gdy krok jest poprawny | od drugiej fali tylko wtedy, gdy rewizja poprawia ukrytą ocenę |
Wypada uczciwie powiedzieć, co w ten sposób testujemy, a czego nie. Symulator zawiera mechanizmy, które umieściliśmy w nim na podstawie podręczników. Nie testujemy więc, czy teorie są prawdziwe w odniesieniu do rzeczywistych ludzi. Testujemy, czy AI potrafi odkryć ukryte reguły systemu, do którego wnętrza nie ma wglądu, wyrazić je jako teorię i uogólnić na sytuacje, których nigdy nie widziała.
Właśnie to jest jedna z kluczowych umiejętności naukowca. A test jest czysty, bo my znamy poprawną odpowiedź i możemy dokładnie zmierzyć, co AI znalazła, a co przeoczyła.
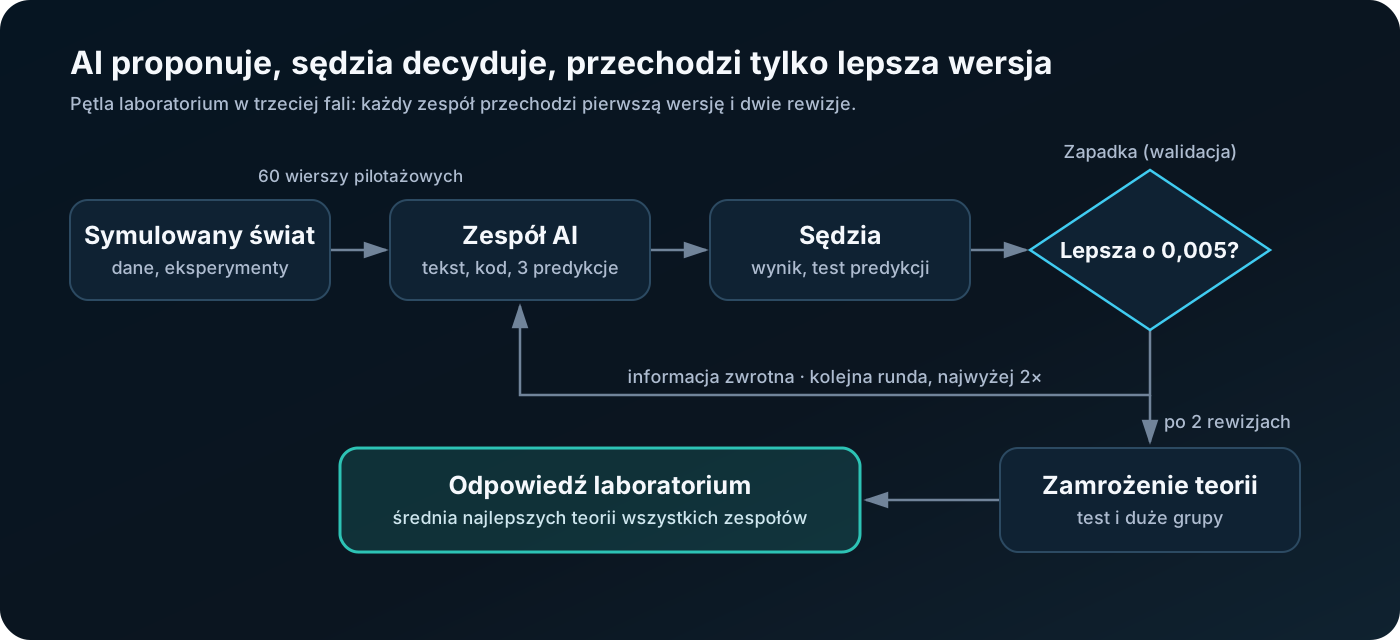
Każdy zespół przechodzi przez pętlę trzy razy: pierwsza wersja i dwie rewizje. Od drugiej fali o przyjęciu rewizji decyduje zapadka, a w trzeciej fali sędzia dodatkowo testuje predykcje na nowych eksperymentach.
Symulowany świat: gdzie grupy rozwiązują zadania
Symulowany świat to program, w którym grupy wirtualnych ludzi rozwiązują tysiące zadań, a my mierzymy, czy grupa pokonała swojego najlepszego członka. Każdy eksperyment, który nazywamy warunkiem, to kombinacja typu zadania, procesu decyzyjnego i sześciu parametrów liczbowych.
Trzy typy zadań
| Zadanie | Co robią członkowie | Przykład z życia | Jak jest oceniane |
|---|---|---|---|
| Szacowanie | każdy szacuje nieznaną liczbę | waga wołu, koszty projektu, liczba klientów w przyszłym roku | wielkość błędu |
| Wybór | pytanie z dwiema odpowiedziami, jedna jest poprawna | „Czy stolicą Australii jest Sydney, czy Canberra?” | skuteczność |
| Łamigłówka | do rozwiązania potrzeba kilku różnych fragmentów wiedzy | awaria samochodu z trzema przyczynami, diagnoza rzadkiej choroby | rozwiązana albo nie |
Łamigłówkę pojedyncza osoba rozwiąże tylko wtedy, gdy zna wszystkie potrzebne fragmenty. Grupa może ją rozwiązać nawet wtedy, gdy każdy zna tylko część, o ile wiedza rzeczywiście połączy się w dyskusji.
Trzy sposoby podejmowania decyzji
- Niezależnie: członkowie nie rozmawiają ze sobą, a odpowiedzi łączy się mechanicznie. Przy szacowaniu średnią, przy wyborze głosowaniem, a przy łamigłówce grupa oddaje rozwiązanie najbardziej szanowanej osoby spośród tych, którzy uważają, że ją rozwiązali. Jak ankieta online.
- Dyskusja: swobodna debata w ograniczonym czasie, zakończona konsensusem. Jak narada.
- Lider: najbardziej szanowany członek konsultuje się z kilkoma innymi i decyduje sam. Jak szef, który wysłucha zespołu.
Sześć parametrów liczbowych
| Parametr | Zakres | Co oznacza | Przykład |
|---|---|---|---|
| Wielkość grupy | 3–12, w teście końcowym 16–60 | liczba członków | zespół, dział, cała firma |
| Średnia kompetencja | 0–1 | jak zdolni są członkowie przeciętnie | studenci albo profesjonaliści |
| Nierówność kompetencji | 0–1 | jak bardzo wyróżnia się najlepszy członek | zgrany zespół albo jedna gwiazda i pomocnicy |
| Korelacja błędów | 0–1 | jak podobnie członkowie się mylą | wszyscy studiowali na tej samej uczelni i czytają te same wiadomości |
| Widoczność kompetencji | 0–1 | jak dobrze grupa rozpoznaje, kto jest kompetentny | zespół, w którym wiadomo, kto jest ekspertem, albo taki, w którym decyduje pewność siebie |
| Demonstrowalność | 0–1 | jak łatwo inni rozpoznają poprawną odpowiedź | dowód matematyczny albo ocena wina |
Co jest mierzone
W każdym warunku grupa rozwiązuje 2000 zadań. Jej najlepszy członek rozwiązuje te same zadania sam. Obliczamy, o ile grupa była lepsza albo gorsza i czy wygrała co najmniej o jeden punkt procentowy.
W trzeciej fali każdy warunek rozwiązuje dziesięć różnych grup o tych samych parametrach. Mierzymy wtedy odsetek grup, które pokonały swojego najlepszego członka. Dlaczego było to konieczne, wyjaśnimy przy drugiej fali.
Co jest w środku, a czego zespoły nie widzą
W symulatorze są wbudowane konkretne reguły, które zespoły AI miały odkryć. Na przykład:
- Skuteczność przy wyborze wynosi 0,3 + 0,65 × kompetencja. Najsłabsi członkowie mylą się więc częściej, niż gdyby rzucali monetą, i dają się złapać na „przynętę”.
- Łamigłówka wymaga 5 fragmentów wiedzy. Wypowiedzianą wiedzę grupa przyjmuje z prawdopodobieństwem 0,5 + 0,5 × demonstrowalność.
- W dyskusji naprawdę mówi tylko 6 najbardziej szanowanych członków, a lider konsultuje się z najwyżej pięcioma osobami. Przy szacowaniu lider nadaje własnej opinii wagę 70%.
- Kto nie rozwiązał łamigłówki, błędnie sądzi, że ją rozwiązał, z prawdopodobieństwem 0,5 × (1 − demonstrowalność). Tacy „fałszywi rozwiązujący” mogą przebić prawdziwego.
Symulator najpierw sprawdziliśmy dziesięcioma testami kontrolnymi, na przykład czy odtwarza twierdzenie Condorceta, mądrość tłumu albo szkodliwość skorelowanych błędów. Dopiero potem udostępniliśmy go zespołom.
Zespoły naukowców AI, teorie jako kod i sędzia
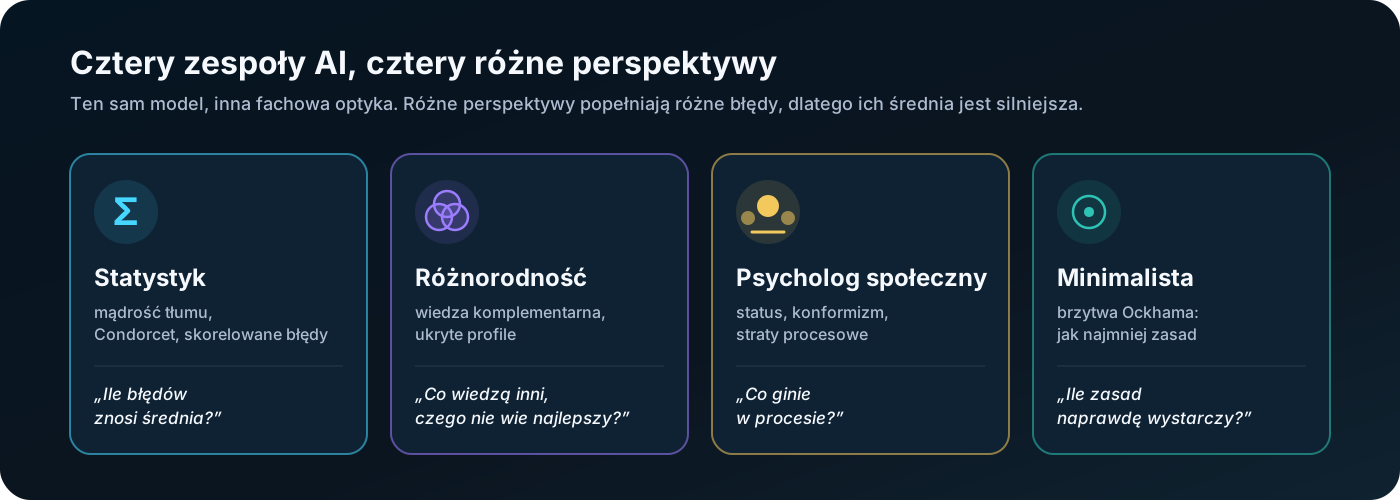
Cztery instancje modelu Claude Opus 5.5 pracowały jako samodzielne zespoły badawcze, każda z inną perspektywą badawczą. Różne perspektywy wybraliśmy z tego samego powodu, dla którego działają zróżnicowane grupy ludzi: różne punkty widzenia prowadzą do różnych błędów.
| Zespół | Perspektywa | Pytanie, które sobie zadaje |
|---|---|---|
| Statystyk | mądrość tłumu, Condorcet, skorelowane błędy | Ile błędów zniweluje uśrednianie? |
| Różnorodność | wiedza komplementarna, ukryte profile | Co wiedzą inni, a czego nie wie najlepszy? |
| Psycholog społeczny | Steiner, Laughlin, status, konformizm | Co gubi się po drodze w procesie? |
| Minimalista | brzytwa Ockhama | Jaka najmniejsza liczba zasad wystarczy? |
Zespoły działają bez narzędzi i bez dostępu do plików, więc fizycznie nie mogą zajrzeć do symulatora. Na początku dostają tylko opis eksperymentu, swoją perspektywę i 60 pilotażowych wierszy danych. Każdy wiersz to jeden warunek z parametrami i wynikiem.
Jak wygląda teoria
Każda teoria ma cztery części:
- Nazwa, na przykład „Składanie kawałków przeciw wspólnej ślepocie”.
- Twierdzenie: od 4 do 8 zdań o tym, jakie mechanizmy decydują.
- Trzy falsyfikowalne predykcje: śmiałe twierdzenia, które eksperyment może obalić.
- Funkcja
predict(c): krótki program w Pythonie, który dla dowolnego warunku zwraca prawdopodobieństwo, że grupa pokona swojego najlepszego członka.
Dlaczego kod? Słowa bywają mgliste: stwierdzenia „grupy zwykle wygrywają, gdy są zróżnicowane” nie da się zmierzyć. Kod przekłada teorię na jednoznaczne przewidywania dla każdej sytuacji. Symulator mierzy następnie, na ile te przewidywania odpowiadają jego wynikom. W odróżnieniu od dowodu formalnego sukces kodu nie dowodzi jednak, że słuszne jest także wyjaśnienie słowne.
Przykład prawdziwej linijki z teorii Psychologa społecznego z pierwszej fali:
k_del = min(n - 1.0, 6.0) # limited airtime: only ~6 other voices really heard
Komentarz mówi: „ograniczony czas, w rzeczywistości słychać tylko około 6 innych głosów”. Opis eksperymentu wspominał tylko o „ograniczonym czasie”. Czy zespół wywnioskował liczbę 6 z danych, czy oszacował ją na podstawie wiedzy o grupach, tego z jego odpowiedzi nie da się poznać. Symulator ma ustawionych właśnie 6 mówców.
Sędzia i wynik Briera
Sędzia uruchamia kod teorii w izolowanym procesie, w którym dostępna jest tylko biblioteka matematyczna, bez plików i sieci. Dla każdego warunku porównuje przewidywanie z rzeczywistością i oblicza wynik Briera.
Wynik Briera znasz z prognozy pogody. Meteorolog mówi „80% szans na deszcz”:
- gdy pada, jego błąd wynosi (1 − 0,8)² = 0,04,
- gdy nie pada, jego błąd wynosi (0 − 0,8)² = 0,64,
- wynik Briera to średnia tych błędów ze wszystkich dni.
Zero oznacza doskonałą prognozę. Kto za każdym razem mówi „50%”, dostaje 0,25, czyli poziom rzutu monetą. Im niższy wynik, tym lepiej. W trzeciej fali porównywaliśmy przewidywanie z odsetkiem zwycięskich grup. Metryką jest tam średni błąd kwadratowy (MSE) względem tego odsetka, a stała prognoza 50% uzyskuje na niej około 0,22.
Zespół dostaje następnie informację zwrotną z danych treningowych: wynik ogólny, rozbicie według dziewięciu kombinacji zadania i procesu oraz 30 największych pomyłek. Potem przerabia teorię. Każdy zespół miał dwie rundy rewizji, więc z każdego zespołu powstały trzy wersje teorii: r0, r1 i r2.
Podręcznik, sprawdzian i egzaminy
Dane podzieliliśmy na cztery części po 300 warunków, podobnie jak w szkole:
| Zbiór | Szkolny odpowiednik | Co z niego widzi zespół |
|---|---|---|
| Trening | zbiór ćwiczeń z odpowiedziami | wszystko: wyniki i informację zwrotną |
| Walidacja | sprawdzian, który poprawia nauczyciel | od drugiej fali tylko „przyjęto” albo „odrzucono” |
| Test | egzamin końcowy z tego samego materiału | nic |
| Duże grupy | egzamin z wyższej klasy: grupy 16–60 członków, w treningu tylko 3–12 | nic |
Właśnie zbiór dużych grup jest najtrudniejszym egzaminem. Teoria, która tylko dopasowała liczby do treningu, tam zawodzi. Teoria, która uchwyciła rzeczywisty mechanizm, potrafi go przenieść także na nieznany zakres.
Porównanie z uczeniem maszynowym
Aby wiedzieć, czy teorie są w ogóle dobre, porównaliśmy je z modelami uczenia maszynowego bez żadnej teorii. Nazywamy je baseline'ami: gradient boosting (połączenie wielu drzew decyzyjnych), regresja logistyczna i średnia z treningu. Baseline'y uczą się na wszystkich 300 wierszach treningowych, zespoły zaczynają od 60. Gdyby teoria nie pokonała zwykłego dopasowania krzywej do danych, nie byłaby dobrą teorią.
Pierwsza fala: teorie pokonały uczenie maszynowe, ale rewizje szkodziły
W pierwszej fali teorie, które widziały tylko 60 wierszy danych, przewidywały lepiej niż uczenie maszynowe na 300 wierszach. Każda kolejna rewizja raczej je jednak pogarszała. Przebieg trwał 148 minut, z późniejszym uzupełnieniem 181 minut, i kosztował 18,21 dolara.
Ustawienia były najprostsze z możliwych. Każdy zespół napisał pierwszą wersję i dwie rewizje, a każda rewizja automatycznie stawała się podstawą kolejnej. Każdy warunek rozwiązywała jedna grupa, a jednocześnie działały cztery wywołania modelu.
Wyniki pierwszych wersji
Wynik Briera, niższy jest lepszy:
| Model | Test (3–12 członków) | Duże grupy (16–60) |
|---|---|---|
| Średnia czterech pierwszych teorii | 0,078 | 0,098 |
| Różnorodność r0 | 0,083 | 0,108 |
| Minimalista r0 | 0,085 | 0,129 |
| Statystyk r0 | 0,091 | 0,114 |
| Gradient boosting, 300 wierszy | 0,112 | 0,137 |
| Psycholog społeczny r0 | 0,119 | 0,131 |
| Regresja logistyczna | 0,122 | 0,285 |
Trzy zespoły z czterech pokonały gradient boosting na teście, Różnorodność i Minimalista w sposób istotny statystycznie. Regresja logistyczna załamała się poza zakresem treningu: na dużych grupach wypadła gorzej niż zwykła średnia z treningu (0,247). Prosta dopasowana do grup liczących od 3 do 12 członków nie ma sensu dla grupy liczącej 50 członków.
Co odkryły zespoły
Najbardziej zaskoczyło nas, jak bardzo zespoły zbliżyły się do ukrytych reguł symulatora. Statystyk na podstawie 60 wierszy oszacował niemal ten sam kształt rozkładu kompetencji w grupie:
s = [min(0.99, max(0.0, m + 0.3 * sp * _ppf((i + 0.625) / (n + 0.25)))) for i in range(n)]
tau = 0.5 + 0.5 * dem  # chance a voiced piece is accepted
Symulator używa wzoru średnia + 0,3 × nierówność × kwantyl rozkładu normalnego. Stała 0,3 zgadza się dokładnie, ale kwantyle zespół obliczał nieco inaczej i inaczej przycinał górną granicę. Przyjęcie wypowiedzianej wiedzy 0,5 + 0,5 × demonstrowalność odpowiada symulatorowi dokładnie.
Przegląd wybranych reguł i tego, jak bardzo zespoły się do nich zbliżyły:
| Reguła symulatora | Szacunek zespołu | Zgodność |
|---|---|---|
| kompetencja: średnia + 0,3 × nierówność × kwantyl | Statystyk: 0,3 × nierówność × kwantyl, inne obliczanie kwantyli i przycięcie | przybliżona |
| przyjęcie wypowiedzianej wiedzy: 0,5 + 0,5 × demonstrowalność | Statystyk i Minimalista: ta sama zależność | dokładna |
| pułap skuteczności 0,95 | Statystyk i Psycholog społeczny: 0,95 | dokładna |
| w dyskusji mówi 6 najbardziej szanowanych | Psycholog społeczny: „około 6 głosów” | dokładna |
| skuteczność przy wyborze: 0,3 + 0,65 × kompetencja | Minimalista: podstawa 0,3 + 0,7 × kompetencja | przybliżona |
| lider nadaje własnemu szacunkowi 70% wagi | trzy zespoły: 65–67% | przybliżona |
| dyskusja przy szacowaniu waży szacunki według statusu i dokładności w danym problemie | Różnorodność: grupa wybiera „najlepszy szacunek dla problemu, a nie najlepszą osobę” | podobna idea, inny mechanizm |
| łamigłówka wymaga 5 fragmentów wiedzy | szacunki od 2 do 4 | odmienna |
| lider konsultuje się z najwyżej 5 osobami | od 3 osób do 80% grupy | odmienna |
Limity pojemności, takie jak liczba fragmentów wiedzy albo doradców, najtrudniej rozpoznać na podstawie danych o małych grupach.
Pętla potrafi obalać
Minimalista w pierwszej rewizji wprowadził „sufit umiejętności”: gdy wszyscy są bardzo kompetentni, najlepszy nie ma gdzie uciec. W drugiej rewizji napisał: „Dane obaliły sufit: przy średniej kompetencji 0,81 uśrednianie przegrało o 17%.” I zastąpił go poprawną zależnością: błąd maleje liniowo wraz z kompetencją, więc wśród doświadczonych najlepszy jest relatywnie jeszcze dokładniejszy.
Rewizje potrafiły jednak też coś zgubić. Zarówno Statystyk, jak i Psycholog społeczny mieli w pierwszej rewizji poprawnie, że „fałszywych rozwiązujących” ubywa wraz z demonstrowalnością. W drugiej rewizji obaj tę poprawną zależność usunęli.
Rewizje szkodziły
Pierwsza rewizja pogorszyła wynik na teście u wszystkich czterech zespołów, u trzech z nich w sposób istotny:
| Zespół | Test r0 → r1 |
|---|---|
| Minimalista | 0,085 → 0,128 |
| Różnorodność | 0,083 → 0,116 |
| Psycholog społeczny | 0,119 → 0,149 |
| Statystyk | 0,091 → 0,102 |
Teorie przy tym się rozrastały: u Minimalisty z 873 do 1 406 węzłów drzewa składniowego, czyli o 60%. Informacja zwrotna „oto 30 największych pomyłek” kusiła do łatania pojedynczych przypadków zamiast budowania lepszych mechanizmów. Laboratorium przyjęło ponadto każdą rewizję, także gorszą, bo nie zatrzymało jej nic takiego jak Lean.
Gdzie teorie zawiodły
Na dużych grupach teorie przeszacowały łamigłówki rozwiązywane w dyskusji. Przewidywały 89–93% wygranych, rzeczywistość wynosiła 79%. Rozumowały logicznie, że więcej członków wniesie więcej wiedzy. W symulatorze mówi jednak tylko 6 najbardziej szanowanych, więc większość wiedzy dużej grupy nigdy nie pada.
Grupa teorii jest mądrzejsza od najlepszej teorii
Gdy uśredniliśmy przewidywania czterech pierwszych teorii, otrzymaliśmy wynik lepszy niż najlepsza pojedyncza teoria: 0,078 wobec 0,083 na teście i 0,098 wobec 0,108 na dużych grupach. Średnia wszystkich 12 wersji osiągnęła na dużych grupach nawet 0,092. Laboratorium pokazało więc na własnych teoriach dokładnie to zjawisko, które bada: różne perspektywy popełniają różne błędy, a średnia je znosi.
Problemy techniczne
- Zawieszone wywołania: 4 z 13 wywołań nie wróciły. Limit czasu w Windows zakończył tylko skrypt uruchamiający, a właściwy proces działał dalej i laboratorium na niego czekało.
- Błąd sandboxa: rewizję Statystyka sędzia odrzucił, bo kod użył standardowej funkcji
reversed, której zapomnieliśmy dopuścić. To był nasz błąd. Po poprawce ta sama odpowiedź przeszła i nie musieliśmy płacić za nią ponownie. - Uzupełnienie: dwa zespoły z powodu zawieszeń nie dokończyły rewizji. Uzupełniliśmy je dwie godziny później: 3 wywołania, 33 minuty, 5,83 dolara, tym razem bez ani jednego zawieszenia.
Z pierwszej fali wynieśliśmy trzy lekcje. Rewizje potrzebują sędziego, który nie przepuści gorszej wersji. Odpowiedzią laboratorium ma być grupa teorii, a nie jedna teoria. A cztery jednoczesne wywołania modelu to za dużo.
Druga fala: zapadka i średnia teorii
W drugiej fali średnia teorii po raz pierwszy była w sposób istotny statystycznie lepsza od najlepszej przyjętej teorii. Nowa „zapadka”, która miała zatrzymywać gorsze rewizje, decydowała jednak raczej losowo. Przebieg na nowych danych trwał 96 minut i kosztował 24,67 dolara. Z 13 wywołań nie zawiesiło się ani jedno.
Co zmieniliśmy
- Zapadka: doszła walidacja, 300 warunków, których zespoły nie widzą. Rewizja przechodzi tylko wtedy, gdy poprawi na nich wynik Briera co najmniej o 0,005. W przeciwnym razie zespół kontynuuje od swojej najlepszej wersji i dowiaduje się tylko, że rewizja nie przeszła. To nasz odpowiednik Leana, który przyjmuje tylko poprawny krok.
- Odpowiedź laboratorium: to już nie jedna teoria, lecz średnia przewidywań najlepszych przyjętych wersji wszystkich zespołów.
- Kwestie operacyjne: najwyżej dwa wywołania jednocześnie, każdy zespół przechodzi swoje rundy osobno, a limit czasu kończy całe drzewo procesów.
Wyniki
| Model | Test | Duże grupy |
|---|---|---|
| Odpowiedź laboratorium (średnia najlepszych teorii) | 0,075 | 0,085 |
| Średnia pierwszych wersji | 0,080 | 0,094 |
| Najlepsza pojedyncza teoria według walidacji (Statystyk r1) | 0,093 | 0,131 |
| Gradient boosting | 0,131 | 0,139 |
Odpowiedź laboratorium pokonała gradient boosting o 0,056 na teście i o 0,054 na dużych grupach. Najlepszą przyjętą teorię pokonała o 0,018 i o 0,047. Obie różnice są istotne statystycznie na obu zbiorach: 95% przedziały ufności z bootstrapu nie obejmują zera.
Jedno zastrzeżenie: wersja z najniższym błędem walidacji spośród wszystkich, r2 Statystyka, którą zapadka odrzuciła, była na teście lepsza niż średnia (0,070 wobec 0,075). Na dużych grupach jednak przegrała (0,106 wobec 0,085). Średnia w sposób udowodniony pokonała więc najlepszą przyjętą teorię, ale nie każdą pojedynczą wersję. Prawdopodobny powód jest taki sam jak u ludzi: każdy zespół myli się gdzie indziej, a średnia znosi błędy.
Zapadka nie była w stanie wychwycić subtelnych różnic
Zapadka niezawodnie zatrzymała katastrofy. Odrzuciła wszystkie trzy wyraźnie gorsze rewizje (Różnorodność r1 i r2, Minimalista r1). Przy subtelniejszych różnicach jednak się myliła:
- Przyjęła Statystyka r1, bo poprawił się na walidacji o 0,016. Na teście i na dużych grupach był jednak gorszy niż poprzednia wersja (0,082 → 0,093 i 0,114 → 0,131).
- Odrzuciła Statystyka r2, bo poprawił się na walidacji tylko o 0,001. A przecież była to najlepsza na teście teoria całego przebiegu (0,070) i lepsza była także na dużych grupach.
Z ośmiu decyzji trzy były poprawne, dwie błędne, a trzy mieszane. To niewiele lepiej niż rzut monetą.
Prawdopodobna przyczyna: szum w etykietach
Za prawdopodobną przyczynę uważamy sam pomiar. Wzięliśmy 60 warunków i każdy zasymulowaliśmy z 20 różnymi grupami. Parametry były te same, różniła się tylko losowa kolejność statusu, czyli kto jest liderem i kto mówi.
W 15 z 60 warunków niektóre grupy wygrały, a inne przegrały. Odsetek wygranych wahał się od 5 do 95%. Na większej próbie 300 warunków takich warunków było od 18 do 20%. Mniej więcej w jednej piątej warunków wynik jednej grupy jest więc prawie rzutem monetą.
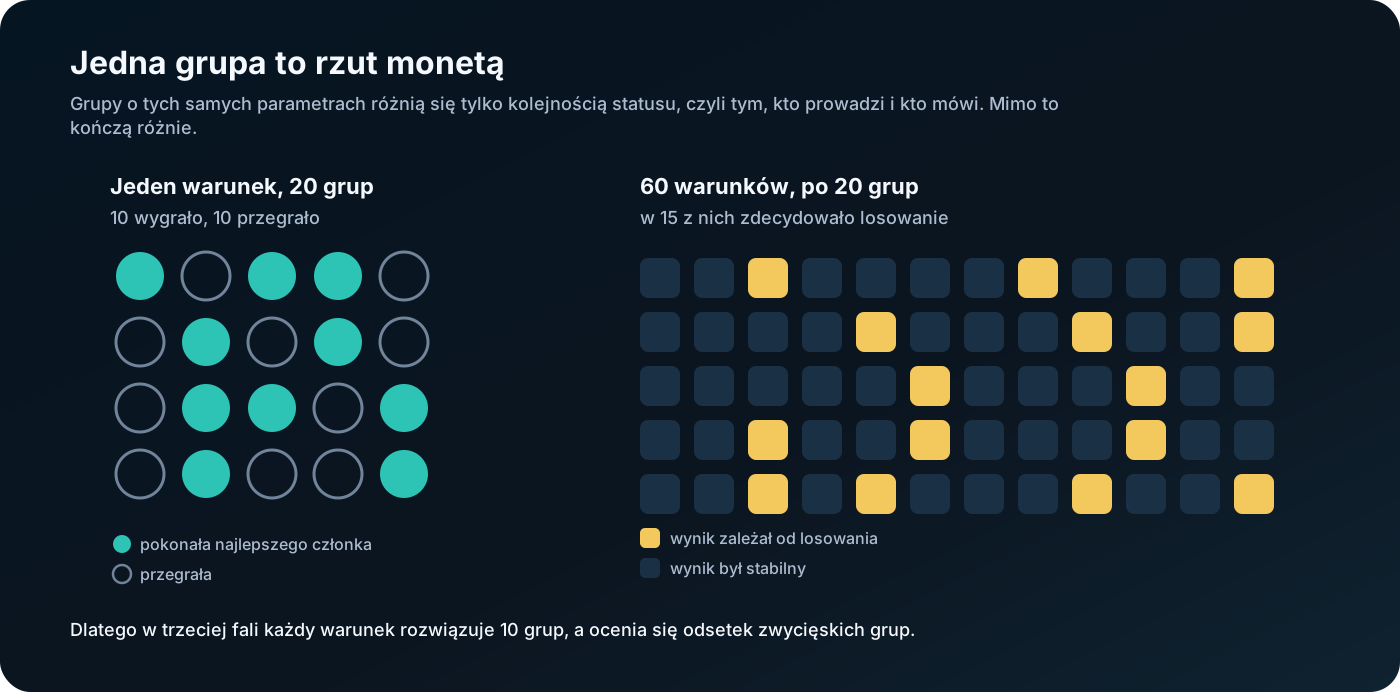
Wyobraź sobie nauczyciela, który ocenia każdego ucznia na podstawie jednego pytania ze sprawdzianu. Nawet świetny uczeń czasem dostanie jedynkę, a słaby szóstkę. Taki szum tworzył nieredukowalny błąd wyniku Briera od 0,025 do 0,032. Samo w sobie nie dowodzi to, że zapadka decydowała losowo: decyduje różnica między dwiema teoriami w tych samych warunkach, a ta jest mniej zaszumiona. Szum wyraźnie utrudnia jednak wychwycenie subtelnych różnic.
Lekcja: sędzia musi być nie tylko niezależny, ale też wystarczająco precyzyjny. Lean przy dowodzie matematycznym się nie myli, nasz sędzia pracował na zaszumionych danych.
Jeden techniczny drobiazg: jedna odpowiedź przyszła ucięta, bo interfejs modelu zwrócił tylko ostatni blok tekstu. Sędzia odrzucił ją z powodu formatu, a druga próba przeszła.
Niezależna krytyka: sześć propozycji i co z nimi zrobiliśmy
Po drugiej fali zleciliśmy ocenę eksperymentu i przyjęliśmy krytykę w całości. Recenzję przygotował inny asystent AI: przejrzał symulator, sterowanie zespołami i zapisane wyniki, ponownie uruchomił testy i przeliczył teorie. Każde twierdzenie, które dało się zweryfikować, sprawdziliśmy sami. Wszystkie się potwierdziły.
1. Ukryte testy mogły przeciekać
Sędzia uruchamiał kod teorii także na ukrytych danych. Gdy kod się wysypał, treść błędu wracała do zespołu. Teoria, która przy błędzie wypisałaby cały warunek, mogłaby w ten sposób zdradzić parametry ukrytych egzaminów, na przykład to, że są w nich grupy liczące 40 członków.
W pierwszych dwóch falach tak się nie stało, ale taka ścieżka istniała. Poprawka: ukryte zbiory są oceniane dopiero po zamrożeniu wszystkich teorii. Z walidacji zespół dowiaduje się tylko „przyjęto” albo „odrzucono”, a błędy na ukrytych danych nie są nigdzie zgłaszane.
2. Jedna grupa to zaszumiona etykieta
2000 zadań nie oznacza 2000 niezależnych grup. Hierarchia szacunku, lider i mówcy są losowani raz dla całego warunku. W recenzji wskazano 14 z 60 warunków, które przy innym losowaniu dały odwrotny wynik. My naliczyliśmy 15 z 60.
Właśnie ten punkt wyjaśnił, dlaczego zapadka w drugiej fali się myliła. Poprawka: każdy warunek rozwiązuje dziesięć grup, a ocenia się odsetek tych, które wygrały. Zapisywany jest też średni zysk i jego wariancja.
3. Twierdzeń słownych nikt nie sprawdzał
Sędzia oceniał tylko funkcję predict(c). Predykcje słowne mogły być fałszywe i nikt by tego nie zauważył. Przykład: Różnorodność w drugiej fali twierdziła, że „łamigłówka z dyskusją nigdy nie ma zysku niższego niż −0,01”. Dane treningowe zawierały tymczasem cztery kontrprzykłady, najgorszy z zyskiem −0,199.
Poprawka: każda predykcja jest teraz czytelna maszynowo. Określa, dla jakiego obszaru parametrów obowiązuje, jaką wielkość mierzy i jaki próg musi spełnić. Sędzia symuluje w tym obszarze 40 nowych warunków i twierdzenie potwierdza albo obala. Dopiero w ten sposób słowo „falsyfikowalna” nabiera praktycznego znaczenia.
4. Stare wyniki mieszały się z nowymi zasadami
Uzupełniony raport pierwszej fali oznaczał wszystkie wersje jako „przyjęte”, chociaż pierwsza fala nie miała żadnej zapadki. Na przykład Statystyk na dodatkowo obliczonej walidacji pogorszył się z 0,073 do 0,085, a mimo to figurował w tabeli jako przyjęty. Recenzja zwróciła też uwagę, że wielokrotne podejmowanie decyzji na podstawie tej samej walidacji stopniowo ją „zużywa”. Dlatego potrzebny jest test końcowy, który nigdy nie służy do podejmowania decyzji.
Poprawka: stary raport poprawiliśmy. Każdy przebieg zapisuje teraz konfigurację, dokładne oznaczenie modelu, wszystkie prompty, kopię kodu i rzeczywiste decyzje zapadki. Test i duże grupy nigdy nie służą do podejmowania decyzji.
5. Co w laboratorium naprawdę pomaga?
W recenzji zaproponowano porównanie, przy tym samym budżecie, czterech różnych perspektyw, czterech neutralnych agentów i jednego agenta. Zwrócono też uwagę, że porównanie z uczeniem maszynowym nie jest uczciwe. Agent dostaje opis mechanizmów i liczbowy zysk, podczas gdy klasyfikatory uczą się tylko wyniku tak/nie.
Poprawka: dodaliśmy silniejsze baseline'y, regresję logistyczną z interakcjami zadanie × proces i gradient boosting uczony na zysku. Porównanie perspektyw z neutralnymi agentami na razie pozostaje do zrobienia.
6. Niech zespoły proponują eksperymenty rozstrzygające
Najciekawsza propozycja: po pierwszych teoriach wybrać warunki, w których ich przewidywania najbardziej się rozchodzą, zasymulować je i zwrócić wyniki zespołom. Tak pracuje prawdziwa nauka: szuka eksperymentu, który rozstrzygnie między konkurencyjnymi teoriami.
Zalążek tego ma już trzecia fala: predykcje są w gruncie rzeczy eksperymentami, które zespół sam sobie projektuje. Właściwy wybór warunków rozstrzygających wciąż pozostaje do zrobienia.
Do tego w recenzji zalecono zapisywanie stanu po każdej rundzie, aby przerwany przebieg nie poszedł na marne. To również wdrożyliśmy.
Trzecia fala: precyzyjniejszy sędzia i testowane predykcje
W trzeciej fali rewizje po raz pierwszy naprawdę poprawiały wyniki, a odpowiedź laboratorium była wyraźnie dokładniejsza niż pojedyncze teorie i baseline'y. Przebieg na nowych danych trwał 81 minut i kosztował 20,55 dolara. Wszystkie 12 wywołań przeszło za pierwszym razem.
Co zmieniliśmy
- Dziesięć grup na warunek: szum w ocenianym celu spadł mniej więcej dziesięciokrotnie, z 0,025–0,032 do około 0,003.
- Zamrożenie teorii: test i duże grupy są oceniane dopiero wtedy, gdy wszystkie zespoły skończą.
- Testowane predykcje: każda teoria ma trzy predykcje w formacie JSON, a sędzia weryfikuje je na nowych eksperymentach.
- Zapis przebiegu: konfiguracja, prompty, kopia kodu i możliwość wznowienia po przerwaniu.
- Silniejsze baseline'y i składanie całej odpowiedzi ze wszystkich bloków tekstu.
Jak wygląda testowana predykcja
Prawdziwa predykcja Statystyka z jego pierwszej rewizji:
{"claim": "Prosta średnia szacunków pokona najlepszego członka nawet przy wysokiej kompetencji i dużej nierówności, jeśli korelacja błędów jest bardzo niska, a grupa duża.",
 "where": {"task": ["estimate"], "process": ["independent"], "skill_mean": [0.75, 1.0],
           "skill_spread": [0.4, 0.9], "correlation": [0.0, 0.1], "n": [9, 12]},
 "stat": "p_beats", "op": ">=", "value": 0.6}
Mówiąc prościej: przy szacowaniu z uśrednianiem, bardzo kompetentnych i nierównych członkach, niemal niezależnych błędach i od 9 do 12 członkach co najmniej 60% grup pokona najlepszego członka. To śmiałe twierdzenie, bo intuicja podpowiada, że wśród ekspertów średnia tylko „rozwodni” najlepszego. Sędzia zasymulował 40 nowych warunków w tym obszarze i najlepszego pokonało 100% grup. Predykcja spełniła swój próg w testowanych warunkach.
Aby zespoły nie mogły za pomocą predykcji zajrzeć do egzaminu końcowego, mogły testować tylko grupy liczące od 3 do 12 członków.
Wyniki
Metryką jest średni błąd kwadratowy (MSE) względem odsetka zwycięskich grup, niższy jest lepszy. Liczby nie są bezpośrednio porównywalne z wynikiem Briera z dwóch pierwszych fal. Gdybyśmy te same przewidywania oceniali klasycznym wynikiem Briera względem wyniku każdej pojedynczej grupy, odpowiedź laboratorium miałaby 0,062 na teście i 0,070 na dużych grupach. Kolejność modeli by się nie zmieniła.
| Model | Test | Duże grupy |
|---|---|---|
| Odpowiedź laboratorium | 0,032 | 0,037 |
| Najlepsza pojedyncza teoria według walidacji (Minimalista r1) | 0,041 | 0,070 |
| Średnia pierwszych wersji | 0,064 | 0,057 |
| Regresja logistyczna z interakcjami | 0,086 | 0,175 |
| Gradient boosting | 0,106 | 0,090 |
Odpowiedź laboratorium pokonała najlepszy baseline według walidacji, czyli regresję logistyczną, o 0,054 na teście i o 0,138 na dużych grupach. Gradient boosting wypadł na dużych grupach lepiej (0,090), ale i nad nim przewaga laboratorium wynosi 0,053. Najlepszą przyjętą teorię, która miała zarazem najniższy błąd walidacji spośród wszystkich wersji, pokonała o 0,010 na teście, ale tylko w oszacowaniu punktowym, nie w sposób istotny statystycznie, i o 0,033 na dużych grupach, tam już istotnie. Regresja logistyczna, najlepszy baseline na walidacji, ponownie załamała się poza zakresem treningu.
W tej konfiguracji rewizje pomogły
Wynik Briera na teście dla poszczególnych wersji:
| Zespół | r0 | r1 | r2 | Finalna |
|---|---|---|---|---|
| Różnorodność | 0,144 | 0,041 | 0,041 | r2 |
| Minimalista | 0,072 | 0,041 | 0,079, odrzucono | r1 |
| Statystyk | 0,086 | 0,052 | 0,131, odrzucono | r1 |
| Psycholog społeczny | 0,075 | 0,076, odrzucono | 0,109, odrzucono | r0 |
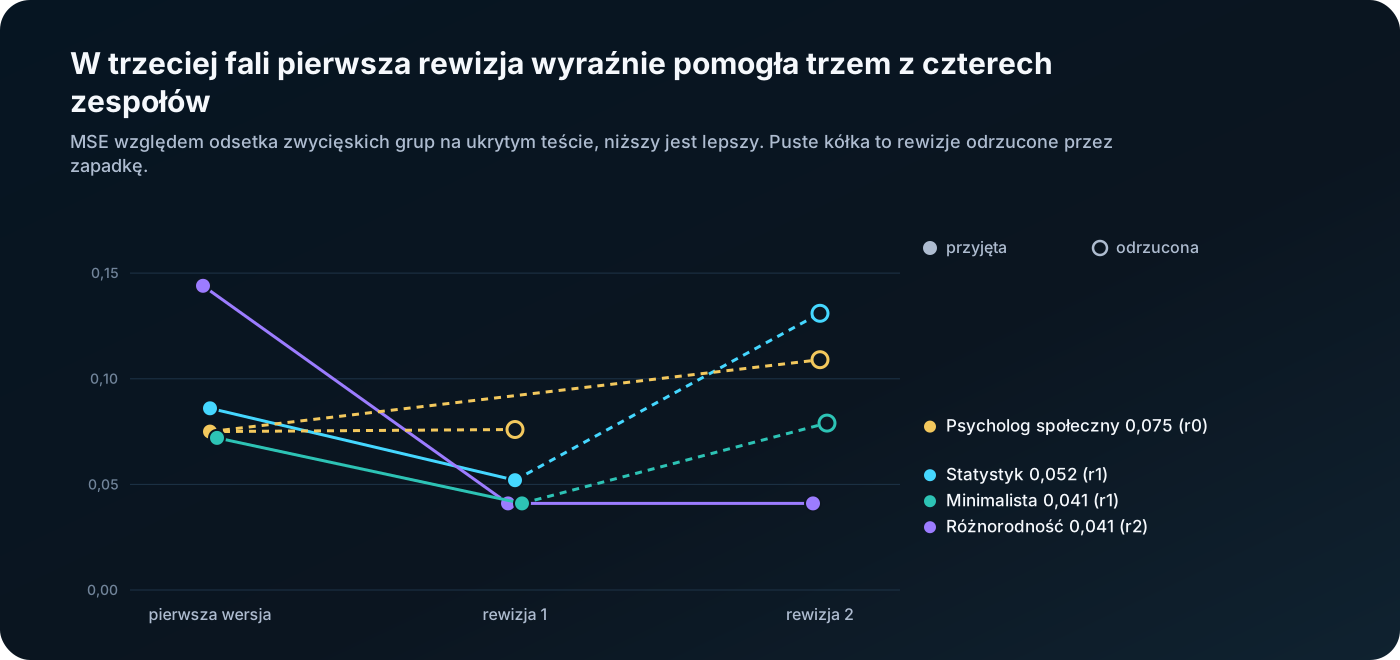
Trzy zespoły z czterech wyraźnie poprawiły się w pierwszej rewizji. Statystyk poprawił się na dużych grupach z 0,106 do 0,046, czyli o ponad połowę. Różnorodność zaczynała gorzej niż baseline'y, a po rewizji znalazła się wśród najlepszych.
Druga rewizja zwykle nie pomogła: zapadka odrzuciła trzy z czterech. Rewizja r2 Statystyka pogorszyłaby wynik na teście z 0,052 do 0,131. Bez zapadki trafiłaby do odpowiedzi laboratorium.
Zapadka zdecydowała poprawnie w 7 z 8 przypadków, w drugiej fali tylko w 3 z 8. Jedyną mieszaną decyzją było odrzucenie r2 Minimalisty, która na teście była gorsza, ale na dużych grupach odrobinę lepsza. Dzięki rewizjom odpowiedź laboratorium jest istotnie lepsza niż średnia pierwszych wersji: o 0,033 na teście i o 0,020 na dużych grupach.
Predykcje, które się potwierdziły, i te, które nie
Z 36 predykcji 33 spełniły swój próg w nowo zasymulowanych warunkach. Czterdzieści losowych warunków może twierdzenie poprzeć albo znaleźć dla niego kontrprzykład, ale w ogólności go nie dowodzi, a przy wynikach bliskich progu brakuje przedziału niepewności. Przykłady:
- Spełniła próg: „Dyskusja przy łamigłówce łączy fragmenty wiedzy nawet przy niemal zerowej demonstrowalności. Grupy o niskiej korelacji i słabych lub średnich członkach przewyższą najlepszego członka co najmniej o 0,2.” (Minimalista r1). Zaobserwowany zysk: 0,33.
- Spełniła próg i przewiduje porażkę: „Lider przy wyborze kieruje się większością doradców. Przy silnej korelacji, nierównych umiejętnościach i niskiej demonstrowalności grupa przegrywa z najlepszym co najmniej o 2 punkty procentowe.” (Minimalista r1). Zaobserwowano: −8 punktów.
- Nie spełniła progu, o włos: „Mechaniczne głosowanie kopiuje typowego członka, przy wyraźnej nierówności najlepszego nie pokona prawie żadna grupa (najwyżej 10%).” (Różnorodność r0). Zaobserwowano: 16%.
- Nie spełniła progu, wyraźnie: r2 Statystyka twierdziła, że w łamigłówkach z bardzo kompetentnymi i nierównymi członkami wygra najwyżej 20% grup. Zaobserwowano: 97%.
Predykcje, które nie spełniły progu, należały do wersji, które były słabsze także według liczb. Dwie należały do rewizji odrzuconych przez zapadkę. Trzecia należała do pierwszej wersji Różnorodności, którą zespół poprawił w kolejnej rewizji. Niepowodzenie predykcji mówi więc zapewne coś także o jakości całej teorii.
Jedno zastrzeżenie: skuteczność na poziomie 92% może oznaczać także to, że zespoły formułowały ostrożne predykcje. Ich śmiałości laboratorium na razie nie potrafi zmierzyć.
Do czego doszliśmy
Najważniejszy wynik: średnia teorii była we wszystkich trzech falach lepsza niż najlepsza przyjęta pojedyncza teoria. Laboratorium pokazało więc na własnej pracy zjawisko, które bada. Jak mocny jest ten wynik, zależy jednak od tego, z jaką pojedynczą teorią go porównamy. Łącznie doszliśmy do siedmiu wniosków, które dotyczą tego eksperymentu i tych baseline'ów.
1. Średnia teorii pokonała najlepszą przyjętą teorię
Średnia przewidywań wszystkich zespołów była we wszystkich trzech falach lepsza niż najlepsza przyjęta teoria, w sposób istotny statystycznie w drugiej fali na obu ukrytych zbiorach i w trzeciej fali na dużych grupach. Gdybyśmy jednak wybierali po prostu wersję z najniższym błędem walidacji spośród wszystkich, łącznie z odrzuconymi, w drugiej fali byłaby to r2 Statystyka, a ta była na teście lepsza niż średnia (0,070 wobec 0,075). Przewaga średniej zależy więc od sposobu wyboru: wobec najlepszej przyjętej teorii jest wyraźna, wobec minimum walidacji tylko częściowa.
Prawdopodobny powód znamy z rozdziału o mądrości tłumu. Statystyk, Różnorodność, Psycholog społeczny i Minimalista mylili się w różnych miejscach, a średnia znosiła ich błędy. Gdyby wszystkie zespoły dostały te same instrukcje, ich błędy byłyby bardziej skorelowane, a przewaga by zmalała. Tę hipotezę chcemy przetestować następnym razem.
2. Teorie ekstrapolowały lepiej niż użyte baseline'y
Odpowiedź laboratorium pokonała najlepszy baseline we wszystkich trzech falach. Największą przewagę miała na dużych grupach, których nikt nie widział: w trzeciej fali 0,037 wobec 0,175 u najlepszego baseline'u według walidacji i wobec 0,090 u gradient boostingu.
Mechanizm taki jak „błąd średniej zmniejsza się do √(ρ + (1 − ρ) / n)” obowiązuje dla grupy 50 osób tak samo jak dla grupy 5 osób. Prosta dopasowana do grup liczących od 3 do 12 członków poza swoim zakresem nie ma sensu. To dobry powód, by szukać mechanizmów, a nie tylko dopasowywać krzywą do danych. Dotyczy to jednak naszych konkretnych baseline'ów, a w trzeciej fali zespoły miały ponadto ukierunkowaną informację zwrotną z dodatkowych symulacji, której baseline'y nie dostały.
3. Rewizje pomogły dopiero w trzeciej konfiguracji
W pierwszych dwóch falach rewizje szkodziły. W trzeciej fali poprawiały wyniki, a zapadka decydowała poprawnie w 7 z 8 przypadków. Na razie nie wiemy jednak dlaczego: zmieniło się powtarzanie grup, informacja zwrotna z nowych eksperymentów i dane, a rolę mógł odegrać także przypadek.
Nasza robocza hipoteza brzmi: wąskim gardłem pętli „zaproponuj, zweryfikuj, popraw” nie jest model, lecz jakość informacji zwrotnej. Zweryfikują ją dopiero kontrolowane porównania, które opisujemy w rozdziale Co dalej.
4. Zapadka jest potrzebna nawet z dobrym sędzią
Nawet w trzeciej fali druga rewizja była zwykle gorsza od pierwszej. Model po informacji zwrotnej woli przebudować całą teorię, niż ostrożnie ją doprecyzować. Bez zapadki dobre rewizje zginęłyby pod złymi.
5. AI potrafi odkryć ukryte mechanizmy, limity pojemności są najtrudniejsze
Zespoły zbliżyły się do większości reguł symulatora, w niektórych przypadkach łącznie ze stałymi: 0,3 × nierówność, 0,5 + 0,5 × demonstrowalność, 6 mówców, pułap skuteczności 0,95. Inne szacunki były tylko przybliżone albo opisywały odmienny mechanizm, jak pokazuje tabela w rozdziale o pierwszej fali. Najgorzej szacowały limity, które ujawniają się dopiero w dużych grupach: liczbę fragmentów wiedzy i liczbę doradców lidera. Na podstawie danych o małych grupach prawie nie da się ich rozpoznać.
6. Falsyfikowalne predykcje mają wartość
Trzy predykcje, które nie spełniły swojego progu, należały do słabszych wersji teorii. Predykcje dają sędziemu drugi, niezależny kanał: nie ocenia on tylko liczb, ale też to, czy teoria mówi prawdę o konkretnych sytuacjach. A teorię zmuszają do powiedzenia czegoś, co może okazać się nieprawdą.
7. Infrastruktura to połowa badań
Zawieszone wywołania, ucięte odpowiedzi, błąd sandboxa i możliwy wyciek danych z ukrytych testów: każdy z tych drobiazgów mógł zniekształcić wynik. Bez zapisu konfiguracji i możliwości wznowienia po przerwaniu wyników nie dałoby się powtórzyć ani zweryfikować.
Odpowiedź symulowanego świata na nasze pytanie
Na 4 500 warunkach zmierzyliśmy, jak poszczególne czynniki wpływają na szansę grupy na pokonanie najlepszego członka:
| Czynnik | Niska wartość (0–0,25) | Wysoka wartość (0,75–1) |
|---|---|---|
| Korelacja błędów | 81% | 36% |
| Nierówność kompetencji | 80% | 47% |
| Demonstrowalność | 47% | 73% |
| Widoczność kompetencji | 53% | 68% |
Grupa pokonuje więc swojego najlepszego członka, gdy:
- błędy i luki w wiedzy członków nie są skorelowane,
- kompetencje nie są zbyt nierówne,
- poprawną odpowiedź da się rozpoznać albo widać, kto jest kompetentny,
- zadanie wymaga łączenia różnej wiedzy.
W łamigłówkach grupa wygrywa w 68–94% warunków. W zwykłym głosowaniu nad pytaniem z dwiema odpowiedziami tylko w 10–21%. Średnia kompetencja i wielkość grupy mają ogólnie tylko niewielki wpływ, ale w poszczególnych sytuacjach duży: większa grupa pomaga głosowaniu, a dyskusji wręcz szkodzi.
Uwaga: te reguły umieściliśmy w symulatorze my, na podstawie podręczników. To odpowiedź naszego modelu świata, a nie nowe odkrycie dotyczące ludzi.
Co to oznacza dla agentów AI i dla zespołów ludzi
Te same reguły, które decydują o tym, kiedy grupa ludzi pokona swojego najlepszego członka, decydują też o tym, kiedy grupa agentów AI pokona najlepszego agenta. Poniższe zalecenia to nasza interpretacja. Opierają się na eksperymencie, a przede wszystkim na literaturze fachowej; nie wszystkie testowaliśmy bezpośrednio w laboratorium.
Dla systemów z wieloma agentami AI
- Różnorodność zamiast klonów. Daj agentom różne perspektywy, role, a nawet różne modele. Klony mylą się tak samo i wtedy nie pomoże im ani głosowanie, ani średnia. Średnia naszych czterech perspektyw pokonała najlepszą przyjętą teorię.
- Najpierw niezależne propozycje, potem średnia. Przy wynikach liczbowych i probabilistycznych pozwól agentom pracować niezależnie, a ich odpowiedzi uśrednij. Wspólna debata może prowadzić do owczego pędu, gdy agenci skłaniają się ku temu najbardziej przekonującemu. Debaty agentów w laboratorium nie testowaliśmy, opieramy się na badaniach grup ludzi.
- Zewnętrzny sędzia. Testy, symulacje, kontrola formalna albo mierzalna metryka. Nie pozwalaj modelom oceniać samych siebie.
- Najpierw precyzyjna ocena, potem więcej iteracji. Zaszumiona ocena zamienia iteracje w loterię. W jakość weryfikacji opłaca się zainwestować wcześniej niż w kolejne rundy.
- Zapadka. Przyjmuj zmianę tylko wtedy, gdy poprawia wynik na danych, których agent nie widział, i to o rozsądną wartość. Zawsze zachowuj najlepszą wersję.
- Weryfikowalne twierdzenia. Wymagaj od agentów konkretnych twierdzeń, które da się automatycznie sprawdzić, i sprawdzaj je.
- Kwestie operacyjne. Ogranicz liczbę jednoczesnych wywołań, zapisuj konfigurację i prompty, a przebiegi pisz tak, aby dało się je dokończyć po przerwaniu.
Dla zespołów ludzi
- Gdy poprawną odpowiedź da się zademonstrować, na przykład przy obliczeniach, kodzie albo diagnozie, którą można przetestować, postaw na dyskusję. Wystarczy jedna osoba z poprawnym rozwiązaniem, jeśli pozostali potrafią je zweryfikować.
- Przy szacunkach i osądach, gdzie odpowiedzi nie da się zademonstrować, zbieraj opinie niezależnie przed dyskusją. Inaczej wszyscy zakotwiczą się przy pierwszej liczbie albo przy najgłośniejszej osobie. Na tej zasadzie opiera się na przykład planning poker w zespołach zwinnych czy metoda delficka.
- Gdy wiesz, kto jest ekspertem, pozwól mu zdecydować po konsultacji z pozostałymi. Gdy tego nie wiesz, średnia niezależnych opinii jest bezpieczniejsza niż lider wybrany według pewności siebie.
- Różne doświadczenia zmniejszają skorelowane błędy. Zespół ludzi z tej samej uczelni, którzy czytają te same wiadomości, ma też te same ślepe punkty.
- Na dużej naradzie większość wiedzy nie zostaje wypowiedziana. Zbieraj unikalne informacje pisemnie z wyprzedzeniem i pytaj każdego, co wie tylko on.
- Głosowanie nad podchwytliwymi pytaniami wzmacnia błąd. Tam, gdzie większość może dać się nabrać na mylącą intuicję, nie decyduj zwykłą większością.
Ograniczenia: czego eksperyment nie dowodzi
Eksperyment pokazuje, że AI potrafi odkrywać i doprecyzowywać teorie ukrytego systemu. Nie pokazuje niczego nowego o rzeczywistych ludziach i ma kilka słabych stron, o których uczciwie trzeba wiedzieć.
- Świat jest naszym modelem. Reguły symulatora wzięliśmy z podręczników. Zespoły mogły odkryć tylko to, co w nim umieściliśmy.
- Każda fala to jeden przebieg na innych danych. Różnice między falami mogą częściowo wynikać z danych i ze szczęścia zespołów. Potrzebujemy więcej powtórzeń.
- Trzecia fala zmieniła kilka rzeczy naraz. Precyzyjniejszy cel, testowane predykcje w informacji zwrotnej i ochrona ukrytych danych pojawiły się jednocześnie. Na razie nie wiemy, która zmiana spowodowała poprawę rewizji.
- Zespoły mają przewagę wiedzy. Model zna Condorceta i Laughlina, baseline'y nie. Porównanie pokazuje wartość wcześniejszej wiedzy i mechanizmów, a nie ogólną przewagę modeli językowych nad uczeniem maszynowym.
- Predykcje mogą być ostrożne. Skuteczność na poziomie 92% to dobra wiadomość tylko wtedy, gdy predykcje coś ryzykują. Tego na razie nie mierzymy.
- Małe próby. Każdy zbiór ma 300 warunków, więc różnice rzędu 0,01 wyniku Briera często mieszczą się w szumie. Dlatego przy kluczowych porównaniach podajemy 95% przedziały ufności z bootstrapu.
- Wybór porównania. Przewaga średniej teorii zależy od tego, z jaką pojedynczą teorią ją porównamy. Wobec najlepszej przyjętej teorii wygrała we wszystkich falach, wobec wersji z najniższym błędem walidacji w drugiej fali przegrała na teście.
- Metryka trzeciej fali to MSE względem odsetka zwycięskich grup, a nie klasyczny wynik Briera. Liczb z różnych fal nie porównujemy więc bezpośrednio.
- Jeden model. Wszystkie zespoły działały na Claude Opus 5.5. Inne modele albo ich mieszanka mogą zachowywać się inaczej.
Co dalej
Najbliższym krokiem jest ustalenie, co dokładnie spowodowało poprawę w trzeciej fali. Potem chcemy wypuścić laboratorium na świat, którego sami nie zaprogramowaliśmy.
- Ablacja trzeciej fali. To samo laboratorium uruchomimy dwa razy: raz bez testowanych predykcji w informacji zwrotnej i raz z jedną grupą na warunek. Okaże się, czy rewizje poprawił precyzyjniejszy sędzia, czy predykcje. Szacunkowo 2 × 20 dolarów.
- Perspektywy kontra neutralni agenci. Cztery różne perspektywy, czterech neutralnych agentów i jeden agent przy tym samym budżecie. Jeśli mamy rację, że siła średniej teorii wynika z różnych błędów, neutralni agenci będą mieli bardziej skorelowane błędy, a ich średnia będzie słabsza.
- Eksperymenty rozstrzygające. Po pierwszych teoriach laboratorium znajdzie warunki, w których ich przewidywania najbardziej się rozchodzą, zasymuluje je i zwróci wyniki zespołom. Część budżetu przypadnie na losowy wybór jako kontrolę.
- Śmiałość predykcji. Zmierzymy, jak dużą część przestrzeni predykcja wyklucza, a śmiałe predykcje, które się potwierdzą, będziemy nagradzać bardziej niż ostrożne.
- Więcej powtórzeń. Kilka przebiegów każdej wersji na różnych danych, aby dało się oddzielić szczęście od umiejętności.
- Prawdziwe grupy. Symulowanych członków zastąpimy grupami agentów AI, które rozwiązują prawdziwe zadania: szacowanie, zagadki logiczne, pytania o fakty. Świat nie będzie wtedy naszym modelem, a teorie mogą odkryć coś, czego nikt w nim nie umieścił. Później można by zaangażować także grupy ludzi, za ich świadomą zgodą i pod nadzorem etycznym.
- Filozofia. Tę samą pętlę można zastosować także do argumentów filozoficznych. Logika formalna zweryfikuje, czy wniosek rzeczywiście wynika z przesłanek. Prawdziwości przesłanek nie zweryfikuje jednak żaden sędzia, a właśnie o nią toczy się zwykle spór w filozofii. AI mogłaby tu przynajmniej systematycznie wykrywać ukryte założenia, z których wynikają poszczególne wnioski.
Eksperyment w liczbach
| Pozycja | Wartość |
|---|---|
| Fale eksperymentu | 3, do tego uzupełnienie pierwszej fali |
| Zespoły AI | 4, model Claude Opus 5.5 (claude-opus-5-5) |
| Wersje teorii | 36: 4 zespoły × 3 wersje × 3 fale |
| Wywołania modelu | 41, z tego 4 zawieszone, wszystkie w pierwszej fali |
| Łączny czas działania | 358 minut, czyli około 6 godzin |
| Koszt według cennika | 63,43 USD: 18,21 + 24,67 + 20,55 |
| Warunków w jednej fali | od 900 do 1 200 |
| Zadań dla każdej grupy | 2 000 |
| Grup na warunek w trzeciej fali | 10 |
| Testowanych predykcji | 36, z tego 33 spełniło swój próg |
| Najlepszy wynik | MSE 0,032 na teście i 0,037 na dużych grupach (trzecia fala, odpowiedź laboratorium) |
Wszystkie dane, teorie i wykresy znajdziesz w interaktywnym raporcie (po czesku).
Słowniczek pojęć
- Baseline: porównawczy model uczenia maszynowego bez teorii, na przykład gradient boosting.
- Wynik Briera: średni błąd kwadratowy przewidywanego prawdopodobieństwa. 0 to doskonała prognoza, 0,25 rzut monetą.
- Bootstrap i 95% przedział ufności: wielokrotne ponowne próbkowanie danych. Gdy przedział różnicy nie obejmuje zera, różnica jest istotna statystycznie.
- Demonstrowalność: jak łatwo inni rozpoznają, że wypowiedziana odpowiedź jest poprawna.
- Ekstrapolacja: przewidywanie poza zakresem danych, na których model się uczył.
- Falsyfikowalna predykcja: twierdzenie, które eksperyment może obalić.
- Korelacja błędów: jak bardzo członkowie grupy mylą się w ten sam sposób.
- Lean: program do formalnej weryfikacji dowodów matematycznych.
- MSE względem odsetka zwycięskich grup: metryka trzeciej fali, średni błąd kwadratowy przewidywania względem odsetka grup, które pokonały najlepszego członka.
- p_beats: odsetek grup, które pokonały swojego najlepszego członka.
- Sandbox: izolowane środowisko, w którym kod teorii działa bez dostępu do plików i sieci.
- Walidacja: dane, na podstawie których decyduje się o przyjęciu rewizji. Zespół nigdy ich nie widzi.
- Zapadka: reguła, która przyjmuje zmianę tylko wtedy, gdy w sposób udowodniony poprawia wynik.
Źródła
- Physical Superintelligence: strona badawcza poświęcona dowodowi hipotezy Aaronsona i Ambainisa oraz formalizacja w Leanie na GitHubie.
- Francis Galton: Vox Populi, Nature 75, 1907.
- Markiz de Condorcet: Essai sur l'application de l'analyse à la probabilité des décisions rendues à la pluralité des voix, 1785.
- Patrick R. Laughlin, Alan L. Ellis: Demonstrability and social combination processes on mathematical intellective tasks, Journal of Experimental Social Psychology 22, 1986.
- Garold Stasser, William Titus: Pooling of unshared information in group decision making, Journal of Personality and Social Psychology 48, 1985.
- Ivan D. Steiner: Group Process and Productivity, Academic Press, 1972.
- Shane Frederick: Cognitive Reflection and Decision Making, Journal of Economic Perspectives 19, 2005 (zagadka z kijem i piłką).