Das Theorie-Labor: Wann eine Gruppe klüger ist als ihr klügstes Mitglied
Vier Instanzen eines Sprachmodells entwarfen und korrigierten prädiktive Theorien über einen verborgenen Simulator für Gruppenentscheidungen. In drei explorativen Läufen verfolgten wir ihre Genauigkeit, den Nutzen der Revisionen und die Mittelung der Vorhersagen. Die Kombination der Theorien übertraf die verwendeten Modelle des maschinellen Lernens; der Vorteil gegenüber einzelnen Theorien hing davon ab, wie wir diese auswählen. Das Experiment zeigte zudem, wie Messrauschen und die Form des Feedbacks die Ergebnisse beeinflussen.
Warum wir das Theorie-Labor gebaut haben
Wir haben ein kleines Forschungslabor gebaut, in dem vier KI-Teams selbstständig wissenschaftliche Theorien entwickeln, testen und korrigieren. An einem einzigen Tag liefen drei Wellen des Experiments: 36 Theorien, 41 Aufrufe des Modells Claude Opus und rund sechs Stunden Rechenzeit für 63 Dollar. Die gemeinsame Antwort des Labors sagte besser voraus als die verwendeten Modelle des maschinellen Lernens und in allen drei Wellen auch besser als die beste angenommene Einzeltheorie. Wie groß dieser Vorteil ist, hängt allerdings davon ab, wie wir die Einzeltheorie auswählen.
Die Inspiration war die Ankündigung des Startups Physical Superintelligence (PSI) vom November 2026. Dessen Forschungssystem mit einem unveröffentlichten Modell von Anthropic hat nach Angaben der Autoren eine mathematische Vermutung aus dem Jahr 2008 bewiesen. Den Beweis prüfte Lean, ein Programm, das jeden logischen Schritt verifiziert. Zum Zeitpunkt der Ankündigung handelte es sich um einen frischen Preprint, die unabhängige Begutachtung lief noch.
Uns interessierte daran vor allem die Methode. Die KI hat darin niemanden mit Worten überzeugt. Sie machte Vorschläge, und ein unabhängiger, unbestechlicher Richter entschied, was gilt. Das Prinzip „Hypothesengenerator + unabhängiger Richter + wiederholte Verbesserung“ ist allgemein.
Wir haben uns deshalb gefragt: Funktioniert dieselbe Schleife auch außerhalb der Mathematik? Also dort, wo es kein Lean gibt, zum Beispiel in der Psychologie oder in der Philosophie?
Der Artikel behandelt:
- welche Frage wir untersucht haben und was die Wissenschaft darüber bereits weiß,
- wie das Labor funktioniert, Schritt für Schritt und anhand von Beispielen,
- die drei Wellen des Experiments, einschließlich der Fehler, die uns unterwegs passiert sind,
- die unabhängige Kritik, die wir erhalten haben, und was wir daraus gemacht haben,
- was wir herausgefunden haben und was das für Teams aus Menschen und KI-Agenten bedeutet.
Der Artikel ist lang, die Lektüre dauert etwa eine halbe Stunde. Wer es eilig hat, kann direkt zum Kapitel Was wir herausgefunden haben springen.
Interaktiver Report: Alle 36 Theorien im vollen Wortlaut, Diagramme, Statistiken und jede Entscheidung der Sperrklinke finden sich im interaktiven Report (auf Tschechisch).
Auf einen Blick
Was wir gemessen haben: wie genau von KI geschriebene Theorien die Ergebnisse eines verborgenen Simulators für Gruppenentscheidungen vorhersagen. Es ging nicht um Versuche mit Menschen. Maßstab ist der Fehler einer probabilistischen Vorhersage: in den ersten beiden Wellen der Brier-Score, in der dritten Welle der MSE gegenüber dem Anteil siegreicher Gruppen. Niedriger ist besser, und die Zahlen der dritten Welle lassen sich mit den ersten beiden nicht direkt vergleichen.
| Welle | Antwort des Labors | Beste angenommene Theorie | Beste Baseline |
|---|---|---|---|
| 1 | 0,078 / 0,098 | 0,083 / 0,108 | 0,112 / 0,137 |
| 2 | 0,075 / 0,085 | 0,093 / 0,131 | 0,131 / 0,139 |
| 3 (andere Metrik) | 0,032 / 0,037 | 0,041 / 0,070 | 0,086 / 0,175 |
Die Werte sind verdeckter Test / große Gruppen. In Welle 1 gab es noch keine Sperrklinke, deshalb ist die Antwort des Labors dort der Durchschnitt der ersten Versionen und die beste Theorie die beste erste Version. Eine Ausnahme: In der zweiten Welle hätte die Version mit dem niedrigsten Validierungsfehler von allen, die die Sperrklinke abgelehnt hatte, den Durchschnitt im Test geschlagen (0,070 gegenüber 0,075), bei den großen Gruppen nicht (0,106 gegenüber 0,085).
Die Frage: Wann eine Gruppe klüger ist als ihr bestes Mitglied
Wir haben eine einzige Frage untersucht: Unter welchen Bedingungen ist eine Gruppe intelligenter als ihr intelligentestes Mitglied? Wir fragen nicht, ob die Gruppe besser ist als ein durchschnittliches Mitglied. Das ist meist leicht. Wir fragen, ob sie den Besten schlagen kann, der in ihr sitzt.
Man stelle sich eine Besprechung von fünf Ärzten vor, von denen einer ein Spitzenspezialist ist. Wenn die Gruppe die Meinungen nur mittelt, „verwässern“ die schwächeren Stimmen den Spezialisten. Um ihn zu schlagen, muss die Gruppe etwas beitragen, das er selbst nicht hat: eine andere Information, einen anderen Blickwinkel oder die Korrektur seines Fehlers.
Wann Gruppen gewinnen und wann sie verlieren, zeigen vier alltägliche Situationen:
- Die Gruppe gewinnt: Hundert Menschen schätzen die Zahl der Bonbons in einem Glas. Der Durchschnitt der Tipps liegt meist näher an der Wahrheit als fast jeder Einzelne, weil Überschätzungen in die eine Richtung die Unterschätzungen in die andere aufheben.
- Die Gruppe gewinnt: Ein Auto springt nicht an, und die Panne hat drei Ursachen. Der Elektriker findet ein defektes Kabel, der Mechaniker einen verstopften Filter und der Programmierer einen Fehler im Steuergerät. Keiner von ihnen könnte das Auto allein reparieren, gemeinsam schon.
- Die Gruppe verliert: Eine Jury beantwortet eine Fangfrage, auf die die meisten Menschen intuitiv falsch antworten. Die Abstimmung hebt den Fehler nicht auf, sondern bestätigt ihn.
- Die Gruppe verliert: In einer Besprechung entscheidet der lauteste und selbstbewussteste Mensch, nicht der fähigste. Die Gruppe ist dann nur so klug, wie genau der Status in ihr die tatsächliche Kompetenz widerspiegelt.
Die Frage hat heute eine sehr praktische Dimension, bei Menschen ebenso wie bei künstlicher Intelligenz:
- Unternehmen und Teams überlegen, wann sie eine Besprechung einberufen, wann sie einen Experten entscheiden lassen und wann sie einfach abstimmen.
- KI-Entwickler kombinieren heute routinemäßig mehrere Agenten: Einer schreibt, ein zweiter prüft, ein dritter stimmt ab. Wann entsteht daraus etwas Klügeres als der beste Agent und wann nur teures Rauschen?
- Die Wissenschaft trifft hier aus drei Richtungen zusammen: Die Philosophie fragt, was kollektives Wissen ist, die Psychologie untersucht, wie Gruppen entscheiden, und die Informatik baut Systeme aus vielen Modellen.
In unserem Experiment hat „das beste Mitglied schlagen“ eine genaue Bedeutung. Das beste Mitglied ist dasjenige mit der tatsächlich höchsten Kompetenz, und es löst dieselben Aufgaben wie die Gruppe, nur allein. Die Gruppe selbst muss nicht wissen, wer das ist. Sie gewinnt, wenn sie um mindestens einen Prozentpunkt Erfolgsquote besser ist, bei Schätzungen mit einem um 1 % kleineren Fehler.
Was wir über kollektive Intelligenz bereits wissen
Die Wissenschaft kennt sechs Mechanismen, die darüber entscheiden, ob eine Gruppe ihr bestes Mitglied schlägt. Alle haben wir später in die simulierte Welt eingebaut, und die KI-Teams sollten sie neu entdecken, ohne in diese Welt hineinsehen zu können.
1. Weisheit der Vielen und korrelierte Fehler
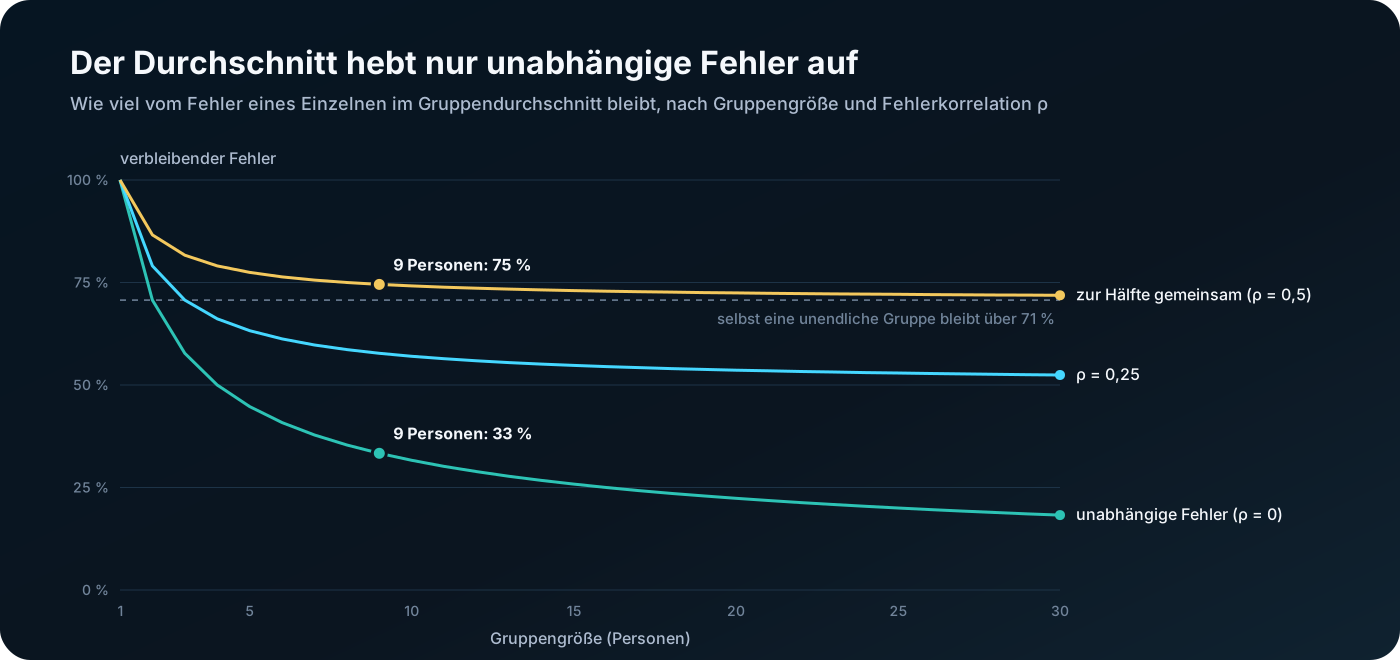
Im Jahr 1906 schätzten auf einem Viehmarkt im englischen Plymouth fast 800 Menschen das Gewicht eines Ochsen. Der mittlere Tipp wich vom tatsächlichen Gewicht um knapp 1 % ab. Der Durchschnitt funktioniert, weil sich unabhängige Fehler gegenseitig aufheben.
Der Haken liegt im Wort unabhängige. Wenn alle denselben irreführenden Artikel gelesen haben, irren sie in dieselbe Richtung, und der Durchschnitt hebt den Fehler nicht auf. Mathematisch: Der Fehler des Durchschnitts schrumpft auf √(ρ + (1 − ρ) / n) des ursprünglichen Fehlers, wobei n die Gruppengröße und ρ die Fehlerkorrelation ist. Das gilt unter der Annahme, dass alle gleich große Fehler haben und jedes Paar von Mitgliedern dieselbe Korrelation aufweist. Beim mittleren absoluten Fehler setzen wir zusätzlich normalverteilte Fehler voraus.
- Neun Menschen mit unabhängigen Fehlern (ρ = 0) verringern den Fehler auf ein Drittel.
- Neun Menschen, deren Fehler zur Hälfte gemeinsam sind (ρ = 0,5), verringern ihn nur auf etwa 75 %.
- Und wenn ein Mitglied viel genauer ist als die anderen, „verwässert“ der Durchschnitt umgekehrt seine Genauigkeit.
2. Das Condorcet-Theorem und seine Umkehrung
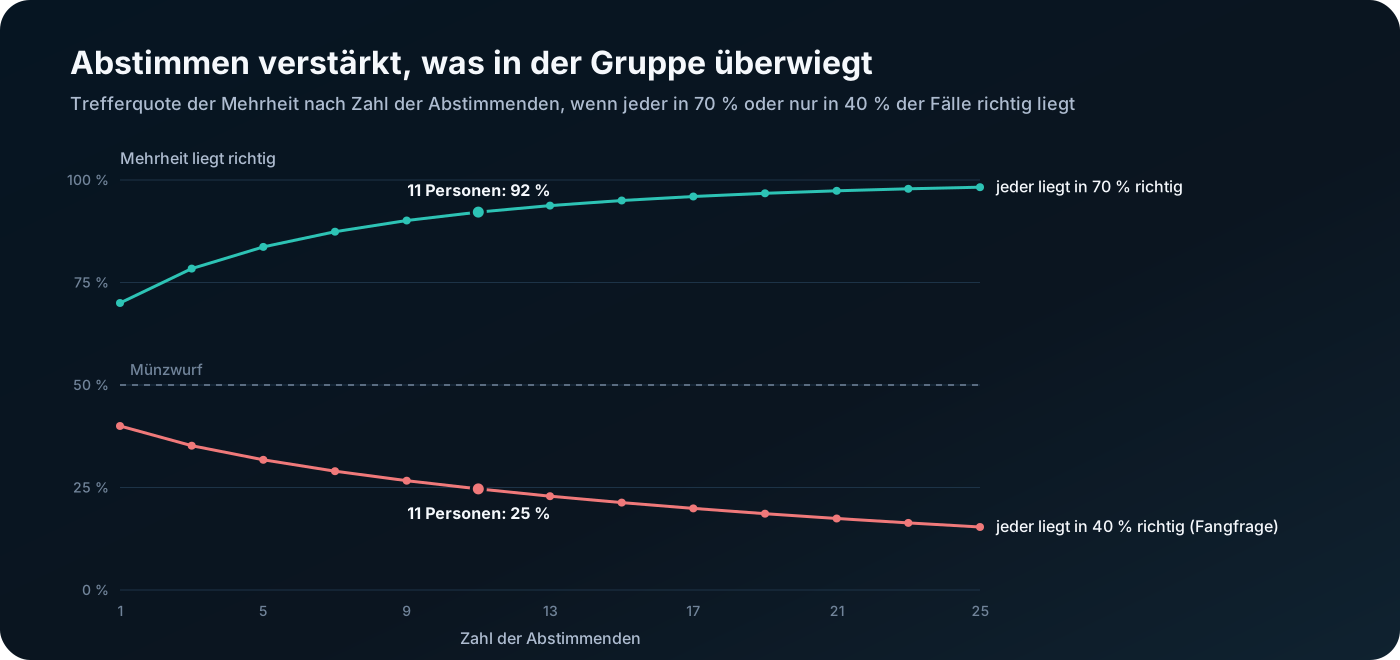
Der Marquis de Condorcet zeigte 1785, dass eine Mehrheit klüger sein kann als die Einzelnen. Wenn alle Geschworenen dieselbe Chance auf die richtige Antwort haben, die über 50 % liegt, und unabhängig entscheiden, liegt die Mehrheit häufiger richtig als jeder Einzelne von ihnen. Elf Geschworene, von denen jeder in 70 % der Fälle recht hat, entscheiden per Mehrheit in rund 92 % der Fälle richtig. Die Annahme gleicher Erfolgsquoten ist wichtig. Drei unabhängig Abstimmende mit Erfolgsquoten von 99 %, 51 % und 51 % liegen per Mehrheit nur in etwa 75 % der Fälle richtig und schneiden damit deutlich schlechter ab als ihr bestes Mitglied. Auch das ist eine Antwort auf unsere Frage.
Das Theorem gilt aber auch umgekehrt. Nehmen wir eine Fangfrage: Schläger und Ball kosten zusammen 1,10 €, der Schläger kostet 1,00 € mehr als der Ball. Wie viel kostet der Ball? Die meisten Menschen antworten intuitiv 10 Cent, richtig sind 5 Cent. Wenn jeder nur in 40 % der Fälle recht hat, entscheidet die Mehrheit von elf Menschen nur in rund 25 % der Fälle richtig. Die Abstimmung hebt den Fehler nicht auf, sondern verstärkt ihn.
3. Demonstrierbarkeit: Die Wahrheit gewinnt
Der Psychologe Patrick Laughlin unterschied Aufgaben danach, ob sich die richtige Antwort vorführen lässt. Bei einer Mathematikaufgabe oder einer Denksportaufgabe genügt es, wenn ein einziger Mensch die Lösung findet. Sobald er sie ausspricht, erkennen die anderen sofort, dass sie richtig ist, und „die Wahrheit gewinnt“.
Bei anderen Aufgaben geht das nicht. Welches Logo ist besser, welcher Bewerber wird ein guter Kollege, welcher Wein ist der beste? Dort überzeugt die richtige Antwort nicht aus sich selbst heraus, und es entscheiden die Mehrheit oder der Status.
4. Hidden Profiles: Wissen, das niemand ausspricht
Garold Stasser und William Titus stellten 1985 fest, dass sich Gruppen in der Diskussion vor allem mit Informationen befassen, die ohnehin jeder kennt. Eine einzigartige Information, die nur ein Mensch hat, kommt oft gar nicht zur Sprache.
Ein Beispiel: Eine Auswahlkommission entscheidet zwischen den Kandidaten A und B. Jedes Mitglied kennt eine andere Schwäche von Kandidat A, sodass jedem für sich genommen A als der Beste erscheint. Würden die Mitglieder ihr Wissen zusammenlegen, gewänne klar B. Die Diskussion dreht sich aber um die allen bekannten Vorzüge von Kandidat A. Komplementäres Wissen ist damit die stärkste Quelle des Gruppenvorteils und zugleich die zerbrechlichste.
5. Status und Sichtbarkeit der Kompetenz
Gruppen hören auf diejenigen, die kompetent wirken: selbstbewusst, ranghoch, laut. Wenn dieser Eindruck der tatsächlichen Kompetenz entspricht, funktionieren ein Anführer oder eine gewichtete Diskussion hervorragend. Wenn nicht, folgt die Gruppe dem Selbstbewussten, der sich irrt. Ein Beispiel: Der erfahrenste Ingenieur im Team ist still, es entscheidet der neue, selbstsichere Manager.
6. Prozessverluste und Gruppengröße
Ivan Steiner fasste 1972 die Leistung einer Gruppe als Potenzial minus Prozessverluste zusammen. Verluste entstehen durch Koordination, durch begrenzte Zeit, durch Konformität oder dadurch, dass sich jemand „mitziehen lässt“. Eine größere Gruppe hat ein größeres Potenzial, aber auch größere Verluste. In einer einstündigen Besprechung mit dreißig Personen prägen tatsächlich nur einige der Aktivsten die Entscheidung.
Keiner dieser Mechanismen beantwortet die Frage allein. Das Ergebnis hängt von ihrem Zusammenspiel ab, und genau das ist die Aufgabe einer Theorie: sie so zu verbinden, dass sie auch Situationen vorhersagt, die noch niemand zuvor gesehen hat.
Die Grundidee: KI schlägt vor, ein unabhängiger Richter entscheidet
Unsere Grundidee ist einfach: Das Modell darf nicht über sich selbst urteilen. Die Theorien schlägt die künstliche Intelligenz vor, aber ob sie gelten, entscheidet ein unabhängiger Richter, der sich von Eloquenz nicht überzeugen lässt.
Warum genügt es nicht, dass sich mehrere Chatbots einigen? Sprachmodelle sind überzeugend, und eine Debatte mehrerer von ihnen läuft auf das hinaus, was am besten klingt, nicht auf das, was wahr ist. Abstimmungen zwischen Modellen stoßen zudem auf das Condorcet-Problem aus dem vorigen Kapitel. Wenn alle Modelle denselben blinden Fleck haben, bestätigt die Abstimmung ihn nur. Die Frage, die wir untersuchen, betrifft damit auch unsere eigene Methode.
In der Mathematik ist Lean der Richter. In der Psychologie gibt es kein Lean, und Experimente mit Menschen sind langsam und teuer. Wir haben deshalb eine simulierte Welt gebaut: ein Programm, das Gruppen von Menschen beim Lösen von Aufgaben simuliert und im Experiment die Rolle der Natur spielt. Die KI-Teams sehen ihren Code nie, so wie ein Wissenschaftler die Naturgesetze nicht sieht. Sie kennen nur die Versuchsbeschreibung und die Ergebnisse.
| PSI (Mathematik) | Theorie-Labor (kollektive Intelligenz) | |
|---|---|---|
| Wer schlägt vor | unveröffentlichtes Modell von Anthropic | vier Teams aus Claude Opus 5.5, jedes mit einer anderen fachlichen Perspektive |
| Wer urteilt | Lean, Beweisprüfung | simulierte Welt und eine Sandbox, die den Code der Theorie ausführt |
| Was geprüft wird | jeder logische Schritt des Beweises | die Vorhersagen der Theorie für Situationen, die das Team nie gesehen hat |
| Wann eine Änderung angenommen wird | nur wenn der Schritt gültig ist | ab der zweiten Welle nur, wenn die Revision die verdeckte Bewertung verbessert |
Fairerweise muss man sagen, was wir damit testen und was nicht. Der Simulator enthält Mechanismen, die wir nach Lehrbüchern eingebaut haben. Wir testen also nicht, ob die Theorien für echte Menschen gelten. Wir testen, ob eine KI die verborgenen Regeln eines Systems entdecken kann, in das sie nicht hineinsieht, ob sie sie als Theorie formulieren und auf Situationen verallgemeinern kann, die sie nie gesehen hat.
Genau das ist eine der Schlüsselfähigkeiten eines Wissenschaftlers. Und der Test ist sauber, weil wir die richtige Antwort kennen und genau messen können, was die KI gefunden und was sie übersehen hat.
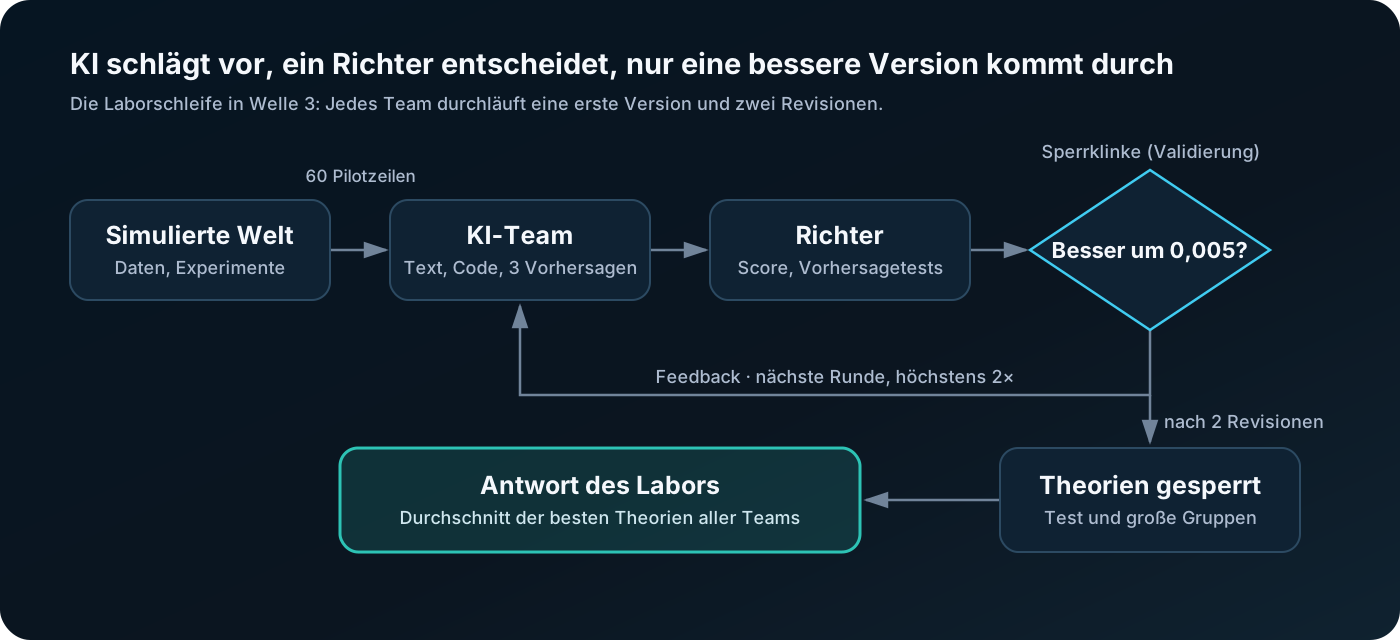
Jedes Team durchläuft die Schleife dreimal: eine erste Version und zwei Revisionen. Ab der zweiten Welle entscheidet die Sperrklinke über die Annahme einer Revision, in der dritten Welle testet der Richter zusätzlich die Vorhersagen an neuen Experimenten.
Die simulierte Welt: Wo Gruppen Aufgaben lösen
Die simulierte Welt ist ein Programm, in dem Gruppen virtueller Menschen Tausende von Aufgaben lösen, während wir messen, ob die Gruppe ihr bestes Mitglied geschlagen hat. Jeder Versuch, den wir Bedingung nennen, ist eine Kombination aus Aufgabentyp, Entscheidungsprozess und sechs numerischen Parametern.
Drei Aufgabentypen
| Aufgabe | Was die Mitglieder tun | Beispiel aus dem Leben | Wie bewertet wird |
|---|---|---|---|
| Schätzung | jeder schätzt eine unbekannte Zahl | Gewicht eines Ochsen, Projektkosten, Zahl der Kunden im nächsten Jahr | Größe des Fehlers |
| Auswahlfrage | eine Frage mit zwei Antwortmöglichkeiten, eine davon ist richtig | „Ist die Hauptstadt Australiens Sydney oder Canberra?“ | Erfolgsquote |
| Rätsel | zur Lösung braucht es mehrere verschiedene Wissensbausteine | Autopanne mit drei Ursachen, Diagnose einer seltenen Krankheit | gelöst oder nicht |
Ein Rätsel löst ein Einzelner nur, wenn er alle nötigen Bausteine kennt. Eine Gruppe kann es auch lösen, wenn jeder nur einen Teil kennt, sofern das Wissen in der Diskussion tatsächlich zusammenkommt.
Drei Entscheidungsweisen
- Unabhängig: Die Mitglieder sprechen nicht miteinander, und die Antworten werden mechanisch kombiniert. Bei der Schätzung per Durchschnitt, bei der Auswahlfrage per Abstimmung, beim Rätsel reicht die Gruppe die Lösung des Angesehensten unter denen ein, die glauben, es gelöst zu haben. Wie eine Online-Umfrage.
- Diskussion: eine freie Debatte mit begrenzter Zeit, die mit einem Konsens endet. Wie eine Besprechung.
- Anführer: Das angesehenste Mitglied berät sich mit einigen anderen und entscheidet allein. Wie ein Chef, der sich das Team anhört.
Sechs numerische Parameter
| Parameter | Bereich | Bedeutung | Beispiel |
|---|---|---|---|
| Gruppengröße | 3–12, im Abschlusstest 16–60 | Zahl der Mitglieder | Team, Abteilung, ganze Firma |
| Durchschnittliche Kompetenz | 0–1 | wie fähig die Mitglieder im Durchschnitt sind | Studierende oder Profis |
| Ungleichheit der Kompetenz | 0–1 | wie stark das beste Mitglied herausragt | eingespieltes Team oder ein Star mit Helfern |
| Fehlerkorrelation | 0–1 | wie ähnlich sich die Mitglieder irren | alle haben an derselben Hochschule studiert und lesen dieselben Nachrichten |
| Sichtbarkeit der Kompetenz | 0–1 | wie gut die Gruppe erkennt, wer fähig ist | ein Team, in dem man weiß, wer der Experte ist, oder eines, in dem Selbstbewusstsein entscheidet |
| Demonstrierbarkeit | 0–1 | wie leicht die anderen die richtige Antwort erkennen | mathematischer Beweis oder Weinbewertung |
Was gemessen wird
In jeder Bedingung löst die Gruppe 2000 Aufgaben. Ihr bestes Mitglied löst dieselben Aufgaben allein. Wir berechnen, um wie viel die Gruppe besser oder schlechter war und ob sie um mindestens einen Prozentpunkt gewonnen hat.
In der dritten Welle lösen zehn verschiedene Gruppen mit denselben Parametern jede Bedingung. Wir messen dann den Anteil der Gruppen, die ihr bestes Mitglied geschlagen haben. Warum das nötig war, erklären wir bei der zweiten Welle.
Was drinsteckt und die Teams nicht sehen
Im Simulator sind konkrete Regeln eingebaut, die die KI-Teams entdecken sollten. Zum Beispiel:
- Die Erfolgsquote bei der Auswahlfrage beträgt 0,3 + 0,65 × Kompetenz. Die schwächsten Mitglieder irren sich also häufiger, als wenn sie eine Münze werfen würden, und fallen auf einen „Köder“ herein.
- Ein Rätsel erfordert 5 Wissensbausteine. Einen ausgesprochenen Baustein nimmt die Gruppe mit einer Wahrscheinlichkeit von 0,5 + 0,5 × Demonstrierbarkeit an.
- In der Diskussion sprechen tatsächlich nur die 6 angesehensten Mitglieder, und der Anführer berät sich mit höchstens fünf Personen. Bei der Schätzung gibt der Anführer seiner eigenen Meinung 70 % Gewicht.
- Wer das Rätsel nicht gelöst hat, glaubt mit einer Wahrscheinlichkeit von 0,5 × (1 − Demonstrierbarkeit) fälschlicherweise das Gegenteil. Solche „falschen Löser“ können den echten überstimmen.
Den Simulator haben wir zunächst mit zehn Kontrolltests überprüft, etwa darauf, dass er das Condorcet-Theorem, die Weisheit der Vielen oder die Schädlichkeit korrelierter Fehler reproduziert. Erst dann haben wir die Teams an ihn herangelassen.
KI-Forscherteams, Theorien als Code und der Richter
Vier Instanzen des Modells Claude Opus 5.5 arbeiteten als eigenständige Forschungsteams, jede mit einer anderen fachlichen Perspektive. Unterschiedliche Perspektiven haben wir aus demselben Grund gewählt, aus dem vielfältige Gruppen von Menschen funktionieren: Unterschiedliche Sichtweisen machen unterschiedliche Fehler.
| Team | Perspektive | Die Frage, die es sich stellt |
|---|---|---|
| Statistiker | Weisheit der Vielen, Condorcet, korrelierte Fehler | Wie viele Fehler hebt die Mittelung auf? |
| Diversität | komplementäres Wissen, Hidden Profiles | Was wissen die anderen, was der Beste nicht weiß? |
| Sozialpsychologe | Steiner, Laughlin, Status, Konformität | Was geht unterwegs im Prozess verloren? |
| Minimalist | Ockhams Rasiermesser | Mit wie wenigen Prinzipien kommt man aus? |
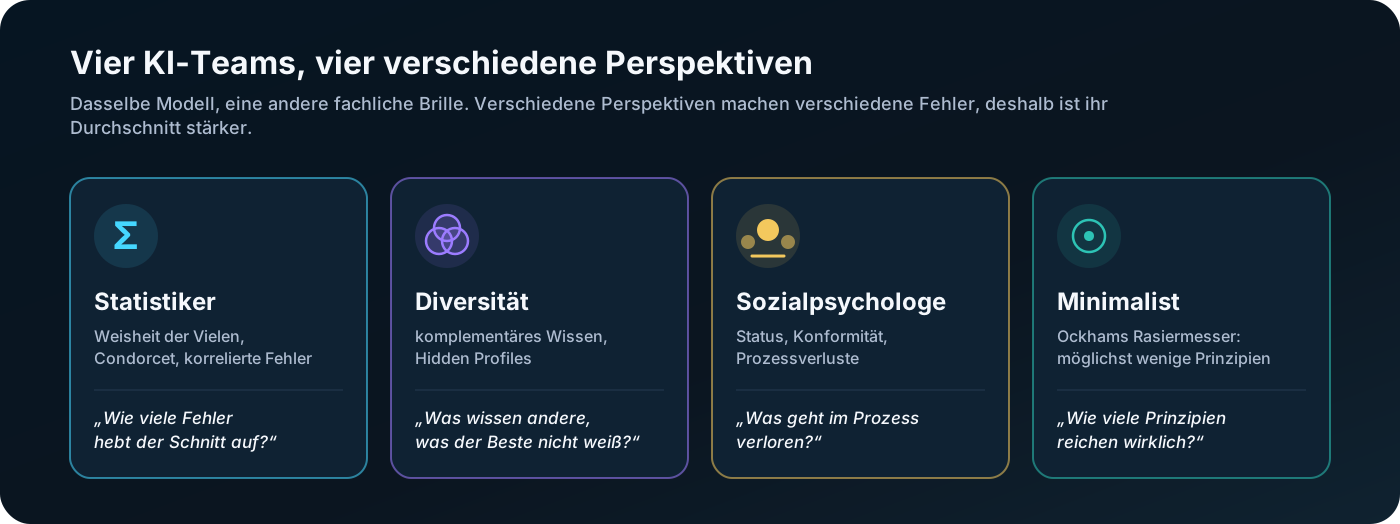
Die Teams laufen ohne Werkzeuge und ohne Dateizugriff, sie können also physisch nicht in den Simulator hineinsehen. Zu Beginn erhalten sie nur die Versuchsbeschreibung, ihre Perspektive und 60 Pilotzeilen mit Daten. Jede Zeile ist eine Bedingung mit Parametern und Ergebnis.
Wie eine Theorie aussieht
Jede Theorie besteht aus vier Teilen:
- Name, zum Beispiel „Bausteine zusammensetzen gegen geteilte Blindheit“.
- Aussage: 4 bis 8 Sätze darüber, welche Mechanismen entscheiden.
- Drei falsifizierbare Vorhersagen: kühne Aussagen, die ein Experiment widerlegen kann.
- Die Funktion
predict(c): ein kurzes Python-Programm, das für jede beliebige Bedingung die Wahrscheinlichkeit zurückgibt, dass die Gruppe ihr bestes Mitglied schlägt.
Warum Code? Worte sind oft vage: „Gruppen gewinnen meistens, wenn sie vielfältig sind“ lässt sich nicht messen. Code überführt die Theorie in eindeutige Vorhersagen für jede Situation. Der Simulator misst dann, wie gut diese Vorhersagen zu seinen Ergebnissen passen. Anders als ein formaler Beweis belegt der Erfolg des Codes aber nicht, dass auch die verbale Erklärung zutrifft.
Ein Beispiel für eine echte Zeile aus der Theorie des Sozialpsychologen aus der ersten Welle:
k_del = min(n - 1.0, 6.0) # limited airtime: only ~6 other voices really heard
Der Kommentar besagt: „begrenzte Redezeit, tatsächlich gehört werden nur etwa 6 weitere Stimmen“. Die Versuchsbeschreibung erwähnte nur „begrenzte Zeit“. Ob das Team die Zahl 6 aus den Daten abgeleitet oder aus seinem Wissen über Gruppen geschätzt hat, lässt sich seiner Ausgabe nicht entnehmen. Im Simulator sind genau 6 Sprecher eingestellt.
Der Richter und der Brier-Score
Der Richter führt den Code der Theorie in einem isolierten Prozess aus, in dem nur eine Mathematikbibliothek zur Verfügung steht, keine Dateien und kein Netzwerk. Für jede Bedingung vergleicht er die Vorhersage mit der Wirklichkeit und berechnet den Brier-Score.
Den Brier-Score kennt man aus der Wettervorhersage. Ein Meteorologe sagt „80 % Regenwahrscheinlichkeit“:
- wenn es regnet, beträgt sein Fehler (1 − 0,8)² = 0,04,
- wenn es nicht regnet, beträgt sein Fehler (0 − 0,8)² = 0,64,
- der Brier-Score ist der Durchschnitt dieser Fehler über alle Tage.
Null bedeutet eine perfekte Vorhersage. Wer jedes Mal „50 %“ sagt, erhält 0,25, also das Niveau eines Münzwurfs. Je niedriger der Score, desto besser. In der dritten Welle haben wir die Vorhersage mit dem Anteil siegreicher Gruppen verglichen. Metrik ist dort der mittlere quadratische Fehler (MSE) gegenüber diesem Anteil, und eine konstante Vorhersage von 50 % erreicht darauf etwa 0,22.
Das Team erhält dann Feedback aus den Trainingsdaten: den Gesamtscore, eine Aufschlüsselung nach den neun Kombinationen aus Aufgabe und Prozess sowie die 30 größten Irrtümer. Danach überarbeitet es die Theorie. Jedes Team hatte zwei Revisionsrunden, sodass bei jedem Team drei Versionen der Theorie entstanden: r0, r1 und r2.
Lehrbuch, Klassenarbeit und Prüfungen
Die Daten haben wir in vier Teile zu je 300 Bedingungen aufgeteilt, ähnlich wie in der Schule:
| Datensatz | Schulisches Gegenstück | Was das Team davon sieht |
|---|---|---|
| Training | Übungsbuch mit Lösungen | alles: Ergebnisse und Feedback |
| Validierung | Klassenarbeit, die der Lehrer korrigiert | ab der zweiten Welle nur „angenommen“ oder „abgelehnt“ |
| Test | Abschlussprüfung über denselben Stoff | nichts |
| Große Gruppen | Prüfung aus einer höheren Klassenstufe: Gruppen mit 16–60 Mitgliedern, im Training nur 3–12 | nichts |
Gerade der Datensatz der großen Gruppen ist die härteste Prüfung. Eine Theorie, die nur Zahlen an das Training angepasst hat, scheitert dort. Eine Theorie, die den tatsächlichen Mechanismus erfasst hat, kann ihn auch auf einen unbekannten Bereich übertragen.
Vergleich mit maschinellem Lernen
Um zu wissen, ob die Theorien überhaupt gut sind, haben wir sie mit Modellen des maschinellen Lernens ohne jede Theorie verglichen. Wir nennen sie Baselines: Gradient Boosting (ein Ensemble von Entscheidungsbäumen), logistische Regression und der Durchschnitt aus dem Training. Die Baselines lernen aus allen 300 Trainingszeilen, die Teams beginnen mit 60. Würde eine Theorie das bloße Anpassen einer Kurve an die Daten nicht schlagen, wäre sie keine gute Theorie.
Erste Welle: Theorien schlugen maschinelles Lernen, Revisionen schadeten aber
In der ersten Welle sagten Theorien, die nur 60 Datenzeilen gesehen hatten, besser voraus als maschinelles Lernen mit 300 Zeilen. Jede weitere Revision machte sie jedoch eher schlechter. Der Lauf dauerte 148 Minuten, mit der späteren Ergänzung 181 Minuten, und kostete 18,21 Dollar.
Der Aufbau war der einfachstmögliche. Jedes Team schrieb eine erste Version und zwei Revisionen, und jede Revision wurde automatisch zur Grundlage der nächsten. Jede Bedingung löste eine einzige Gruppe, und es liefen vier Modellaufrufe gleichzeitig.
Ergebnisse der ersten Versionen
Brier-Score, niedriger ist besser:
| Modell | Test (3–12 Mitglieder) | Große Gruppen (16–60) |
|---|---|---|
| Durchschnitt der vier ersten Theorien | 0,078 | 0,098 |
| Diversität r0 | 0,083 | 0,108 |
| Minimalist r0 | 0,085 | 0,129 |
| Statistiker r0 | 0,091 | 0,114 |
| Gradient Boosting, 300 Zeilen | 0,112 | 0,137 |
| Sozialpsychologe r0 | 0,119 | 0,131 |
| Logistische Regression | 0,122 | 0,285 |
Drei von vier Teams schlugen Gradient Boosting im Test, Diversität und Minimalist statistisch signifikant. Die logistische Regression brach außerhalb des Trainingsbereichs zusammen: Bei den großen Gruppen schnitt sie schlechter ab als der einfache Durchschnitt aus dem Training (0,247). Eine Gerade, die an Gruppen mit 3 bis 12 Mitgliedern angepasst wurde, ergibt für eine Gruppe mit 50 Mitgliedern keinen Sinn.
Was die Teams entdeckt haben
Am meisten überraschte uns, wie nahe die Teams den verborgenen Regeln des Simulators kamen. Der Statistiker schätzte aus 60 Zeilen nahezu dieselbe Form der Kompetenzverteilung in der Gruppe:
s = [min(0.99, max(0.0, m + 0.3 * sp * _ppf((i + 0.625) / (n + 0.25)))) for i in range(n)]
tau = 0.5 + 0.5 * dem  # chance a voiced piece is accepted
Der Simulator verwendet Durchschnitt + 0,3 × Ungleichheit × Quantil der Normalverteilung. Die Konstante 0,3 stimmt exakt, die Quantile berechnete das Team aber etwas anders und kappte die Werte nach oben anders. Die Annahme eines ausgesprochenen Wissensbausteins mit 0,5 + 0,5 × Demonstrierbarkeit entspricht exakt dem Simulator.
Eine Übersicht ausgewählter Regeln und wie nahe ihnen die Teams kamen:
| Regel des Simulators | Schätzung des Teams | Übereinstimmung |
|---|---|---|
| Kompetenz: Durchschnitt + 0,3 × Ungleichheit × Quantil | Statistiker: 0,3 × Ungleichheit × Quantil, andere Berechnung der Quantile und andere Kappung | ungefähr |
| Annahme eines ausgesprochenen Wissensbausteins: 0,5 + 0,5 × Demonstrierbarkeit | Statistiker und Minimalist: derselbe Zusammenhang | exakt |
| Obergrenze der Erfolgsquote 0,95 | Statistiker und Sozialpsychologe: 0,95 | exakt |
| in der Diskussion sprechen die 6 Angesehensten | Sozialpsychologe: „etwa 6 Stimmen“ | exakt |
| Erfolgsquote bei der Auswahlfrage: 0,3 + 0,65 × Kompetenz | Minimalist: Basis 0,3 + 0,7 × Kompetenz | ungefähr |
| der Anführer gibt seiner eigenen Schätzung 70 % Gewicht | drei Teams: 65–67 % | ungefähr |
| bei der Schätzung gewichtet die Diskussion die Schätzwerte nach Status und Genauigkeit beim jeweiligen Problem | Diversität: Die Gruppe wählt „die beste Schätzung für das Problem, nicht den besten Menschen“ | ähnliche Idee, anderer Mechanismus |
| ein Rätsel erfordert 5 Wissensbausteine | Schätzungen 2 bis 4 | abweichend |
| der Anführer berät sich mit höchstens 5 Personen | von 3 Personen bis zu 80 % der Gruppe | abweichend |
Kapazitätsgrenzen wie die Zahl der Wissensbausteine oder der Berater lassen sich aus Daten über kleine Gruppen am schwersten erkennen.
Die Schleife kann widerlegen
Der Minimalist führte in der ersten Revision eine „Fähigkeitsobergrenze“ ein: Wenn alle sehr fähig sind, kann sich der Beste nicht mehr absetzen. In der zweiten Revision schrieb er: „Die Daten haben die Obergrenze widerlegt: Bei einer durchschnittlichen Kompetenz von 0,81 verlor die Mittelung um 17 %.“ Und er ersetzte sie durch den richtigen Zusammenhang: Der Fehler sinkt linear mit der Kompetenz, sodass unter Erfahrenen der Beste relativ gesehen sogar noch genauer ist.
Revisionen konnten aber auch Erkenntnisse verlieren. Sowohl der Statistiker als auch der Sozialpsychologe hatten in der ersten Revision richtig erkannt, dass die „falschen Löser“ mit steigender Demonstrierbarkeit abnehmen. In der zweiten Revision strichen beide diesen richtigen Zusammenhang wieder.
Die Revisionen schadeten
Die erste Revision verschlechterte das Testergebnis bei allen vier Teams, bei dreien davon signifikant:
| Team | Test r0 → r1 |
|---|---|
| Minimalist | 0,085 → 0,128 |
| Diversität | 0,083 → 0,116 |
| Sozialpsychologe | 0,119 → 0,149 |
| Statistiker | 0,091 → 0,102 |
Dabei wuchsen die Theorien: beim Minimalisten von 873 auf 1.406 Knoten des Syntaxbaums, also um 60 %. Das Feedback „hier sind die 30 größten Irrtümer“ verleitete zu Flicken für Einzelfälle statt zu besseren Mechanismen. Außerdem übernahm das Labor jede Revision, auch eine schlechtere, weil nichts wie Lean sie aufhielt.
Wo die Theorien versagten
Bei den großen Gruppen überschätzten die Theorien Rätsel, die per Diskussion gelöst werden. Sie sagten 89–93 % Siege voraus, tatsächlich waren es 79 %. Sie argumentierten logisch, dass mehr Mitglieder mehr Wissen einbringen. Im Simulator sprechen aber nur die 6 Angesehensten, sodass der größte Teil des Wissens einer großen Gruppe nie zur Sprache kommt.
Eine Gruppe von Theorien ist klüger als die beste Theorie
Als wir die Vorhersagen der vier ersten Theorien mittelten, erhielten wir ein besseres Ergebnis als mit der besten Einzeltheorie: 0,078 gegenüber 0,083 im Test und 0,098 gegenüber 0,108 bei den großen Gruppen. Der Durchschnitt aller 12 Versionen erreichte bei den großen Gruppen sogar 0,092. Das Labor führte damit an seinen eigenen Theorien genau das Phänomen vor, das es untersucht: Unterschiedliche Perspektiven machen unterschiedliche Fehler, und der Durchschnitt hebt sie auf.
Technische Probleme
- Hängende Aufrufe: 4 von 13 Aufrufen kamen nicht zurück. Das Zeitlimit unter Windows beendete nur das Startskript, der eigentliche Prozess lief weiter, und das Labor wartete auf ihn.
- Sandbox-Fehler: Die Revision des Statistikers lehnte der Richter ab, weil der Code die Standardfunktion
reversedverwendete, die wir freizugeben vergessen hatten. Das war unser Fehler. Nach der Korrektur ging dieselbe Antwort durch, und wir mussten nicht erneut dafür bezahlen. - Ergänzung: Zwei Teams hatten ihre Revisionen wegen der Hänger nicht abgeschlossen. Wir haben sie zwei Stunden später nachgeholt: 3 Aufrufe, 33 Minuten, 5,83 Dollar, diesmal ohne einen einzigen Hänger.
Aus der ersten Welle haben wir drei Lehren gezogen. Revisionen brauchen einen Richter, der eine schlechtere Version nicht durchlässt. Die Antwort des Labors sollte eine Gruppe von Theorien sein, nicht eine einzelne Theorie. Und vier gleichzeitige Modellaufrufe sind zu viele.
Zweite Welle: Sperrklinke und Durchschnitt der Theorien
In der zweiten Welle war der Durchschnitt der Theorien erstmals statistisch signifikant besser als die beste angenommene Theorie. Die neue „Sperrklinke“, die schlechtere Revisionen stoppen sollte, entschied jedoch eher zufällig. Der Lauf auf neuen Daten dauerte 96 Minuten und kostete 24,67 Dollar. Von den 13 Aufrufen blieb kein einziger hängen.
Was wir geändert haben
- Sperrklinke: Neu hinzu kam die Validierung, 300 Bedingungen, die die Teams nicht sehen. Eine Revision kommt nur durch, wenn sie dort den Brier-Score um mindestens 0,005 verbessert. Andernfalls macht das Team mit seiner besten Version weiter und erfährt nur, dass die Revision nicht durchgekommen ist. Das ist unser Gegenstück zu Lean, das nur einen gültigen Schritt akzeptiert.
- Antwort des Labors: Sie ist nicht mehr eine einzelne Theorie, sondern der Durchschnitt der Vorhersagen der besten angenommenen Versionen aller Teams.
- Betrieb: höchstens zwei Aufrufe gleichzeitig, jedes Team absolviert seine Runden separat, und das Zeitlimit beendet den gesamten Prozessbaum.
Ergebnisse
| Modell | Test | Große Gruppen |
|---|---|---|
| Antwort des Labors (Durchschnitt der besten Theorien) | 0,075 | 0,085 |
| Durchschnitt der ersten Versionen | 0,080 | 0,094 |
| Beste Einzeltheorie laut Validierung (Statistiker r1) | 0,093 | 0,131 |
| Gradient Boosting | 0,131 | 0,139 |
Die Antwort des Labors schlug Gradient Boosting um 0,056 im Test und um 0,054 bei den großen Gruppen. Die beste angenommene Theorie schlug sie um 0,018 bzw. 0,047. Beide Unterschiede sind auf beiden Datensätzen statistisch signifikant: Die 95-%-Konfidenzintervalle aus dem Bootstrap schließen die Null nicht ein.
Ein Vorbehalt: Die Version mit dem niedrigsten Validierungsfehler von allen, die von der Sperrklinke abgelehnte r2 des Statistikers, war im Test besser als der Durchschnitt (0,070 gegenüber 0,075). Bei den großen Gruppen verlor sie aber (0,106 gegenüber 0,085). Der Durchschnitt schlug also nachweislich die beste angenommene Theorie, nicht aber jede einzelne Version. Der wahrscheinliche Grund ist derselbe wie bei Menschen: Jedes Team irrt sich an anderer Stelle, und der Durchschnitt hebt die Fehler auf.
Die Sperrklinke konnte feine Unterschiede nicht auseinanderhalten
Katastrophen hielt die Sperrklinke zuverlässig auf. Alle drei klar schlechteren Revisionen lehnte sie ab (Diversität r1 und r2, Minimalist r1). Bei feineren Unterschieden irrte sie sich jedoch:
- Sie nahm Statistiker r1 an, weil er sich in der Validierung um 0,016 verbessert hatte. Im Test und bei den großen Gruppen war er aber schlechter als die vorherige Version (0,082 → 0,093 und 0,114 → 0,131).
- Sie lehnte Statistiker r2 ab, weil er sich in der Validierung nur um 0,001 verbessert hatte. Dabei war das im Test die beste Theorie des gesamten Laufs (0,070), und auch bei den großen Gruppen war sie besser.
Von acht Entscheidungen waren drei richtig, zwei falsch und drei gemischt. Das ist nicht viel besser als ein Münzwurf.
Wahrscheinliche Ursache: Rauschen in den Labels
Als wahrscheinliche Ursache sehen wir die Messung selbst. Wir nahmen 60 Bedingungen und simulierten jede mit 20 verschiedenen Gruppen. Die Parameter waren gleich, nur die zufällige Statusreihenfolge unterschied sich, also wer Anführer ist und wer spricht.
Bei 15 von 60 Bedingungen gewannen manche Gruppen und andere verloren. Der Anteil der Siege lag zwischen 5 und 95 %. In einer größeren Stichprobe von 300 Bedingungen waren es 18 bis 20 %. Bei etwa einem Fünftel der Bedingungen ist das Ergebnis einer einzelnen Gruppe also fast ein Münzwurf.
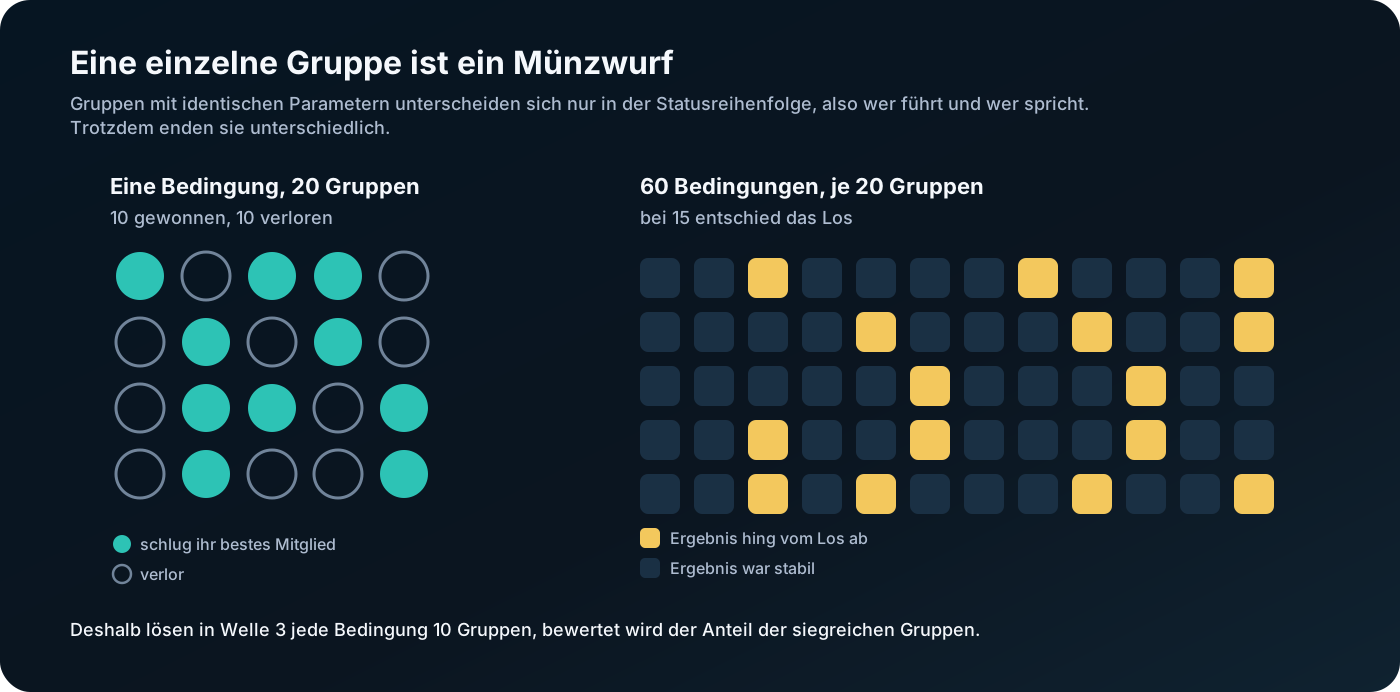
Man stelle sich einen Lehrer vor, der jeden Schüler nach einer einzigen Frage in der Klassenarbeit benotet. Auch ein ausgezeichneter Schüler bekommt dann manchmal eine Fünf und ein schwacher eine Eins. Dieses Rauschen erzeugte einen nicht reduzierbaren Fehler im Brier-Score von 0,025 bis 0,032. Das allein beweist nicht, dass die Sperrklinke zufällig entschied: Entscheidend ist der Unterschied zweier Theorien unter denselben Bedingungen, und der ist weniger verrauscht. Das Rauschen erschwert es aber erheblich, feine Unterschiede zu erkennen.
Die Lehre daraus: Der Richter muss nicht nur unabhängig, sondern auch hinreichend präzise sein. Lean irrt sich bei einem mathematischen Beweis nicht, unser Richter arbeitete mit verrauschten Daten.
Ein technisches Detail am Rande: Eine Antwort kam abgeschnitten an, weil die Schnittstelle des Modells nur den letzten Textblock zurückgab. Der Richter lehnte sie wegen des Formats ab, der zweite Versuch ging durch.
Unabhängige Kritik: sechs Vorschläge und was wir daraus gemacht haben
Nach der zweiten Welle haben wir das Experiment begutachten lassen und die Kritik vollständig angenommen. Das Gutachten erstellte ein anderer KI-Assistent: Er ging den Simulator, die Steuerung der Teams und die gespeicherten Ergebnisse durch, ließ die Tests erneut laufen und berechnete die Theorien neu. Jede Behauptung, die sich überprüfen ließ, haben wir selbst überprüft. Alle trafen zu.
1. Verdeckte Tests konnten durchsickern
Der Richter führte den Code der Theorie auch auf den verdeckten Daten aus. Stürzte der Code ab, ging der Fehlertext an das Team zurück. Eine Theorie, die bei einem Fehler die gesamte Bedingung ausgibt, hätte so die Parameter der verdeckten Prüfungen verraten, etwa dass darin Gruppen mit 40 Mitgliedern vorkommen.
In den ersten beiden Wellen ist das nicht passiert, der Weg existierte aber. Die Korrektur: Die verdeckten Datensätze werden erst nach dem Einfrieren aller Theorien ausgewertet. Aus der Validierung erfährt das Team nur „angenommen“ oder „abgelehnt“, und Fehler auf den verdeckten Daten werden nirgendwohin gemeldet.
2. Eine einzelne Gruppe ist ein verrauschtes Label
2000 Aufgaben bedeuten nicht 2000 unabhängige Gruppen. Ansehen, Anführer und Sprecher werden einmal für die ganze Bedingung ausgelost. Das Gutachten fand 14 von 60 Bedingungen, die bei einer anderen Auslosung das entgegengesetzte Ergebnis lieferten. Wir haben 15 von 60 gemessen.
Genau dieser Punkt erklärte, warum sich die Sperrklinke in der zweiten Welle geirrt hatte. Die Korrektur: Jede Bedingung lösen zehn Gruppen, und bewertet wird der Anteil derer, die gewonnen haben. Gespeichert werden auch der durchschnittliche Zugewinn und seine Varianz.
3. Die verbalen Aussagen hat niemand überprüft
Der Richter bewertete nur die Funktion predict(c). Die verbalen Vorhersagen konnten falsch sein, ohne dass es jemand gemerkt hätte. Ein Beispiel: Diversität behauptete in der zweiten Welle, dass „ein Rätsel mit Diskussion nie einen Zugewinn unter −0,01 hat“. Die Trainingsdaten enthielten dabei vier Gegenbeispiele, das schlimmste mit einem Zugewinn von −0,199.
Die Korrektur: Jede Vorhersage ist jetzt maschinenlesbar. Sie gibt an, für welchen Parameterbereich sie gilt, welche Größe sie misst und welche Schwelle erreicht werden muss. Der Richter simuliert in diesem Bereich 40 neue Bedingungen und bestätigt oder widerlegt die Aussage. Erst so bekommt das Wort „falsifizierbar“ eine praktische Bedeutung.
4. Alte Ergebnisse vermischten sich mit neuen Regeln
Der ergänzte Report der ersten Welle kennzeichnete alle Versionen als „angenommen“, obwohl die erste Welle gar keine Sperrklinke hatte. So verschlechterte sich etwa der Statistiker auf der nachträglich berechneten Validierung von 0,073 auf 0,085 und stand trotzdem als angenommen in der Tabelle. Das Gutachten wies außerdem darauf hin, dass wiederholtes Entscheiden anhand derselben Validierung diese nach und nach „abnutzt“. Deshalb braucht es einen Abschlusstest, der nie für Entscheidungen verwendet wird.
Die Korrektur: Den alten Report haben wir korrigiert. Jeder Lauf speichert jetzt die Konfiguration, die genaue Modellbezeichnung, alle Prompts, eine Kopie des Codes und die tatsächlichen Entscheidungen der Sperrklinke. Test und große Gruppen werden nie für Entscheidungen verwendet.
5. Was am Labor hilft tatsächlich?
Das Gutachten schlug vor, bei gleichem Budget vier verschiedene Perspektiven, vier neutrale Agenten und einen einzelnen Agenten zu vergleichen. Es wies auch darauf hin, dass der Vergleich mit maschinellem Lernen nicht fair ist. Der Agent erhält eine Beschreibung der Mechanismen und den numerischen Zugewinn, während die Klassifikatoren nur das Ergebnis Ja/Nein lernen.
Die Korrektur: Wir haben stärkere Baselines hinzugefügt, eine logistische Regression mit Interaktionen Aufgabe × Prozess und ein auf den Zugewinn trainiertes Gradient Boosting. Der Vergleich der Perspektiven mit neutralen Agenten steht noch aus.
6. Die Teams sollen trennscharfe Experimente vorschlagen
Der interessanteste Vorschlag: nach den ersten Theorien die Bedingungen auswählen, in denen ihre Vorhersagen am stärksten auseinandergehen, sie simulieren und die Ergebnisse an die Teams zurückgeben. So arbeitet echte Wissenschaft: Sie sucht das Experiment, das zwischen konkurrierenden Theorien entscheidet.
Ansätze davon gibt es schon in der dritten Welle: Die Vorhersagen sind eigentlich Experimente, die das Team selbst entwirft. Die eigentliche Auswahl trennscharfer Bedingungen steht noch aus.
Zusätzlich empfahl das Gutachten, den Zustand nach jeder Runde zu speichern, damit ein unterbrochener Lauf nicht verloren geht. Auch das haben wir umgesetzt.
Dritte Welle: ein präziserer Richter und getestete Vorhersagen
In der dritten Welle brachten die Revisionen erstmals echte Verbesserungen, und die Antwort des Labors war deutlich genauer als die einzelnen Theorien und die Baselines. Der Lauf auf neuen Daten dauerte 81 Minuten und kostete 20,55 Dollar. Alle 12 Aufrufe gingen auf Anhieb durch.
Was wir geändert haben
- Zehn Gruppen pro Bedingung: Das Rauschen in der bewerteten Zielgröße sank etwa um das Zehnfache, von 0,025–0,032 auf etwa 0,003.
- Einfrieren der Theorien: Test und große Gruppen werden erst ausgewertet, wenn alle Teams fertig sind.
- Getestete Vorhersagen: Jede Theorie hat drei Vorhersagen im JSON-Format, und der Richter überprüft sie an neuen Experimenten.
- Protokollierung des Laufs: Konfiguration, Prompts, Kopie des Codes und Fortsetzung nach einer Unterbrechung.
- Stärkere Baselines und das Zusammensetzen der vollständigen Antwort aus allen Textblöcken.
Wie eine getestete Vorhersage aussieht
Eine echte Vorhersage des Statistikers aus seiner ersten Revision:
{"claim": "Der einfache Durchschnitt der Schätzungen schlägt das beste Mitglied auch bei hoher Kompetenz und großer Ungleichheit, wenn die Fehlerkorrelation sehr niedrig und die Gruppe groß ist.",
 "where": {"task": ["estimate"], "process": ["independent"], "skill_mean": [0.75, 1.0],
           "skill_spread": [0.4, 0.9], "correlation": [0.0, 0.1], "n": [9, 12]},
 "stat": "p_beats", "op": ">=", "value": 0.6}
In Alltagssprache: Bei Schätzungen mit Mittelung, sehr fähigen und ungleichen Mitgliedern, nahezu unabhängigen Fehlern und 9 bis 12 Mitgliedern schlagen mindestens 60 % der Gruppen das beste Mitglied. Das ist kühn, denn die Intuition sagt, dass der Durchschnitt unter Experten den Besten nur „verwässert“. Der Richter simulierte 40 neue Bedingungen in diesem Bereich, und 100 % der Gruppen schlugen den Besten. Die Vorhersage erfüllte unter den getesteten Bedingungen ihre Schwelle.
Damit die Teams mithilfe der Vorhersagen keinen Blick in die Abschlussprüfung werfen konnten, durften sie nur Gruppen mit 3 bis 12 Mitgliedern testen.
Ergebnisse
Metrik ist der mittlere quadratische Fehler (MSE) gegenüber dem Anteil siegreicher Gruppen, niedriger ist besser. Die Zahlen sind mit dem Brier-Score der ersten beiden Wellen nicht direkt vergleichbar. Würden wir dieselben Vorhersagen mit dem klassischen Brier-Score gegenüber dem Ergebnis jeder einzelnen Gruppe bewerten, hätte die Antwort des Labors 0,062 im Test und 0,070 bei den großen Gruppen. An der Reihenfolge der Modelle würde sich nichts ändern.
| Modell | Test | Große Gruppen |
|---|---|---|
| Antwort des Labors | 0,032 | 0,037 |
| Beste Einzeltheorie laut Validierung (Minimalist r1) | 0,041 | 0,070 |
| Durchschnitt der ersten Versionen | 0,064 | 0,057 |
| Logistische Regression mit Interaktionen | 0,086 | 0,175 |
| Gradient Boosting | 0,106 | 0,090 |
Die Antwort des Labors schlug die laut Validierung beste Baseline, die logistische Regression, um 0,054 im Test und um 0,138 bei den großen Gruppen. Gradient Boosting schnitt bei den großen Gruppen besser ab (0,090), doch auch ihm gegenüber beträgt der Vorsprung des Labors 0,053. Die beste angenommene Theorie, die zugleich den niedrigsten Validierungsfehler aller Versionen hatte, schlug sie im Test um 0,010, allerdings nur im Punktwert, nicht statistisch signifikant, und bei den großen Gruppen um 0,033, dort signifikant. Die logistische Regression, die beste Baseline auf der Validierung, brach außerhalb des Trainingsbereichs erneut zusammen.
In dieser Konfiguration halfen die Revisionen
Brier-Score im Test für die einzelnen Versionen:
| Team | r0 | r1 | r2 | Final |
|---|---|---|---|---|
| Diversität | 0,144 | 0,041 | 0,041 | r2 |
| Minimalist | 0,072 | 0,041 | 0,079, abgelehnt | r1 |
| Statistiker | 0,086 | 0,052 | 0,131, abgelehnt | r1 |
| Sozialpsychologe | 0,075 | 0,076, abgelehnt | 0,109, abgelehnt | r0 |
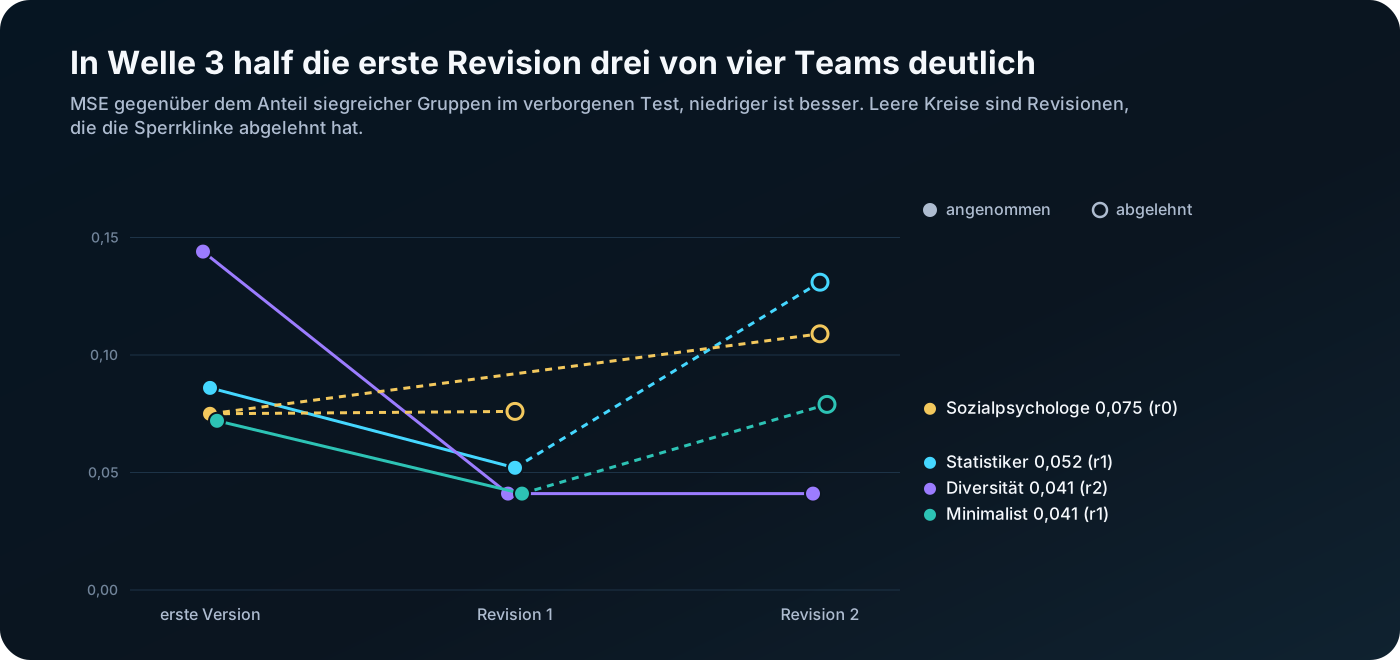
Drei von vier Teams verbesserten sich in der ersten Revision deutlich. Der Statistiker verbesserte sich bei den großen Gruppen von 0,106 auf 0,046, also um mehr als die Hälfte. Diversität startete schlechter als die Baselines und gehörte nach der Revision zu den Besten.
Die zweite Revision half meist nicht: Die Sperrklinke lehnte drei von vier ab. Die r2 des Statistikers hätte den Score im Test von 0,052 auf 0,131 verschlechtert. Ohne Sperrklinke wäre sie in die Antwort des Labors gelangt.
Die Sperrklinke entschied in 7 von 8 Fällen richtig, in der zweiten Welle nur in 3 von 8. Die einzige gemischte Entscheidung war die Ablehnung der r2 des Minimalisten, die im Test schlechter, bei den großen Gruppen aber ein wenig besser war. Dank der Revisionen ist die Antwort des Labors signifikant besser als der Durchschnitt der ersten Versionen: um 0,033 im Test und um 0,020 bei den großen Gruppen.
Vorhersagen, die bestanden haben, und solche, die scheiterten
Von 36 Vorhersagen erfüllten 33 ihre Schwelle unter neu simulierten Bedingungen. Vierzig zufällige Bedingungen können eine Aussage stützen oder ein Gegenbeispiel finden, beweisen sie aber nicht allgemein, und bei knappen Ergebnissen fehlt ein Unsicherheitsintervall. Beispiele:
- Erfüllte ihre Schwelle: „Die Diskussion beim Rätsel bündelt Wissensbausteine auch bei nahezu null Demonstrierbarkeit. Gruppen mit niedriger Korrelation und schwachen bis mittelstarken Mitgliedern übertreffen das beste Mitglied um mindestens 0,2.“ (Minimalist r1). Beobachteter Zugewinn: 0,33.
- Erfüllte ihre Schwelle und sagt eine Niederlage voraus: „Der Anführer folgt bei der Auswahlfrage der Mehrheit seiner Berater. Bei starker Korrelation, ungleichen Fähigkeiten und niedriger Demonstrierbarkeit verliert die Gruppe gegen das beste Mitglied um mindestens 2 Prozentpunkte.“ (Minimalist r1). Beobachtet: −8 Punkte.
- Verfehlte ihre Schwelle, knapp: „Mechanisches Abstimmen kopiert das typische Mitglied, bei merklicher Ungleichheit schlägt fast keine Gruppe das beste Mitglied (höchstens 10 %).“ (Diversität r0). Beobachtet: 16 %.
- Verfehlte ihre Schwelle, deutlich: Die r2 des Statistikers behauptete, dass bei Rätseln mit sehr fähigen und ungleichen Mitgliedern höchstens 20 % der Gruppen gewinnen. Beobachtet: 97 %.
Die Vorhersagen, die ihre Schwelle verfehlten, gehörten zu Versionen, die auch nach den Zahlen schwächer waren. Zwei gehörten zu Revisionen, die die Sperrklinke abgelehnt hatte. Die dritte gehörte zur ersten Version von Diversität, die das Team in der nächsten Revision korrigierte. Das Scheitern einer Vorhersage sagt damit offenbar auch etwas über die Qualität der ganzen Theorie aus.
Ein Vorbehalt: Die Erfolgsquote von 92 % kann auch bedeuten, dass die Teams vorsichtige Vorhersagen formuliert haben. Deren Kühnheit kann das Labor bisher nicht messen.
Was wir herausgefunden haben
Das wichtigste Ergebnis: Der Durchschnitt der Theorien war in allen drei Wellen besser als die beste angenommene Einzeltheorie. Das Labor führte damit an seiner eigenen Arbeit das Phänomen vor, das es untersucht. Wie stark dieses Ergebnis ist, hängt allerdings davon ab, mit welcher Einzeltheorie wir es vergleichen. Insgesamt sind wir zu sieben Schlussfolgerungen gekommen, die für dieses Experiment und diese Baselines gelten.
1. Der Durchschnitt der Theorien schlug die beste angenommene Theorie
Der Durchschnitt der Vorhersagen aller Teams war in allen drei Wellen besser als die beste angenommene Theorie, statistisch signifikant in der zweiten Welle auf beiden verdeckten Datensätzen und in der dritten Welle bei den großen Gruppen. Würden wir aber einfach die Version mit dem niedrigsten Validierungsfehler von allen auswählen, einschließlich der abgelehnten, wäre das in der zweiten Welle die r2 des Statistikers gewesen, und die war im Test besser als der Durchschnitt (0,070 gegenüber 0,075). Der Vorteil des Durchschnitts hängt also von der Art der Auswahl ab: Gegenüber der besten angenommenen Theorie ist er eindeutig, gegenüber dem Validierungsminimum nur teilweise.
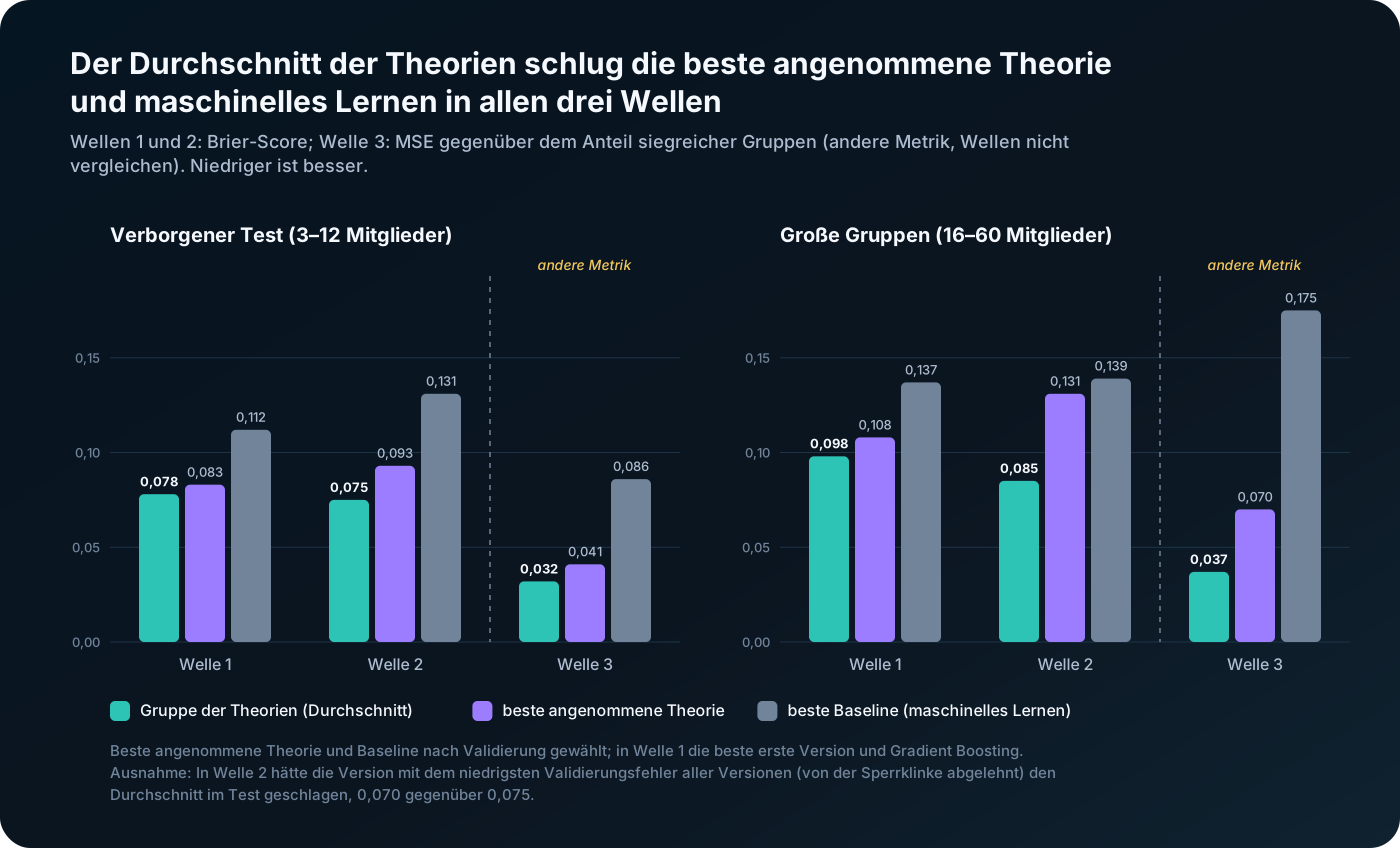
Den wahrscheinlichen Grund kennen wir aus dem Kapitel über die Weisheit der Vielen. Statistiker, Diversität, Sozialpsychologe und Minimalist irrten sich an verschiedenen Stellen, und der Durchschnitt hob ihre Fehler auf. Hätten alle Teams dieselbe Aufgabenstellung bekommen, wären ihre Fehler stärker korreliert gewesen und der Vorteil wäre geschrumpft. Diese Hypothese wollen wir als Nächstes testen.
2. Die Theorien extrapolierten besser als die verwendeten Baselines
Die Antwort des Labors schlug die beste Baseline in allen drei Wellen. Den größten Vorsprung hatte sie bei den großen Gruppen, die niemand gesehen hatte: in der dritten Welle 0,037 gegenüber 0,175 bei der laut Validierung besten Baseline und gegenüber 0,090 bei Gradient Boosting.
Ein Mechanismus wie „der Fehler des Durchschnitts schrumpft auf √(ρ + (1 − ρ) / n)“ gilt für eine Gruppe von 50 Menschen genauso wie für eine von 5. Eine an Gruppen mit 3 bis 12 Mitgliedern angepasste Gerade ergibt außerhalb ihres Bereichs keinen Sinn. Das ist ein guter Grund, nach Mechanismen zu suchen, statt nur eine Kurve durch die Daten zu legen. Das gilt allerdings für unsere konkreten Baselines, und in der dritten Welle hatten die Teams zusätzlich gezieltes Feedback aus weiteren Simulationen, das die Baselines nicht bekamen.
3. Die Revisionen halfen erst in der dritten Konfiguration
In den ersten beiden Wellen schadeten die Revisionen. In der dritten Welle brachten sie Verbesserungen, und die Sperrklinke entschied in 7 von 8 Fällen richtig. Warum, wissen wir aber noch nicht: Geändert haben sich die Wiederholung der Gruppen, das Feedback aus neuen Experimenten und die Daten, und auch der Zufall kann eine Rolle gespielt haben.
Unsere Arbeitshypothese lautet: Der Engpass der Schleife „vorschlagen, prüfen, korrigieren“ ist nicht das Modell, sondern die Qualität des Feedbacks. Überprüfen lässt sie sich erst mit kontrollierten Vergleichen, die wir im Kapitel „Wie es weitergeht“ beschreiben.
4. Die Sperrklinke ist auch mit einem guten Richter nötig
Auch in der dritten Welle war die zweite Revision meist schlechter als die erste. Nach dem Feedback baut das Modell lieber die ganze Theorie um, als sie behutsam zu präzisieren. Ohne Sperrklinke wären die guten Revisionen unter den schlechten verloren gegangen.
5. KI kann verborgene Mechanismen entdecken, Kapazitätsgrenzen sind am schwierigsten
Die Teams kamen den meisten Regeln des Simulators nahe, bei einigen samt Konstanten: 0,3 × Ungleichheit, 0,5 + 0,5 × Demonstrierbarkeit, 6 Sprecher, eine Obergrenze der Erfolgsquote von 0,95. Andere Schätzungen waren nur ungefähr oder beschrieben einen abweichenden Mechanismus, wie die Tabelle im Kapitel über die erste Welle zeigt. Am schlechtesten schätzten sie Grenzen ein, die sich erst bei großen Gruppen zeigen: die Zahl der Wissensbausteine und die Zahl der Berater des Anführers. Aus Daten über kleine Gruppen lassen sie sich kaum erkennen.
6. Falsifizierbare Vorhersagen sind wertvoll
Die drei Vorhersagen, die ihre Schwelle verfehlten, gehörten zu schwächeren Versionen der Theorien. Vorhersagen geben dem Richter einen zweiten, unabhängigen Kanal: Er bewertet nicht nur Zahlen, sondern auch, ob die Theorie über konkrete Situationen die Wahrheit sagt. Und sie zwingen die Theorie, etwas zu sagen, das falsch sein kann.
7. Infrastruktur ist die halbe Forschung
Hängende Aufrufe, abgeschnittene Antworten, ein Sandbox-Fehler und ein mögliches Datenleck aus den verdeckten Tests: Jede dieser Kleinigkeiten hätte das Ergebnis verzerren können. Ohne Protokollierung der Konfiguration und die Möglichkeit, nach einer Unterbrechung fortzufahren, ließen sich die Ergebnisse weder wiederholen noch überprüfen.
Die Antwort der simulierten Welt auf unsere Frage
An 4.500 Bedingungen haben wir gemessen, wie die einzelnen Faktoren die Chance einer Gruppe beeinflussen, ihr bestes Mitglied zu schlagen:
| Faktor | Niedriger Wert (0–0,25) | Hoher Wert (0,75–1) |
|---|---|---|
| Fehlerkorrelation | 81 % | 36 % |
| Ungleichheit der Kompetenz | 80 % | 47 % |
| Demonstrierbarkeit | 47 % | 73 % |
| Sichtbarkeit der Kompetenz | 53 % | 68 % |
Eine Gruppe schlägt ihr bestes Mitglied also, wenn:
- die Fehler und Wissenslücken der Mitglieder nicht korreliert sind,
- die Kompetenzen nicht zu ungleich verteilt sind,
- sich die richtige Antwort erkennen lässt oder sichtbar ist, wer kompetent ist,
- die Aufgabe das Zusammensetzen unterschiedlichen Wissens erfordert.
Bei Rätseln gewinnt die Gruppe in 68–94 % der Bedingungen. Bei einer einfachen Abstimmung über eine Frage mit zwei Antwortmöglichkeiten nur in 10–21 %. Durchschnittliche Kompetenz und Gruppengröße haben insgesamt nur einen geringen Einfluss, in einzelnen Situationen aber einen großen: Eine größere Gruppe hilft der Abstimmung, der Diskussion schadet sie dagegen.
Achtung: Diese Regeln haben wir selbst in den Simulator eingebaut, nach Lehrbüchern. Es ist die Antwort unseres Weltmodells, keine neue Entdeckung über Menschen.
Was das für KI-Agenten und für menschliche Teams bedeutet
Dieselben Regeln, die darüber entscheiden, wann eine Gruppe von Menschen ihr bestes Mitglied schlägt, entscheiden auch darüber, wann eine Gruppe von KI-Agenten den besten Agenten schlägt. Die folgenden Empfehlungen sind unsere Interpretation. Sie stützen sich auf das Experiment und vor allem auf die Fachliteratur, nicht alle haben wir im Labor direkt getestet.
Für Systeme mit mehreren KI-Agenten
- Vielfalt statt Klone. Den Agenten unterschiedliche Perspektiven, Rollen oder sogar verschiedene Modelle geben. Klone irren sich auf dieselbe Weise, und dann helfen ihnen weder Abstimmung noch Durchschnitt. Der Durchschnitt unserer vier Perspektiven schlug die beste angenommene Theorie.
- Erst unabhängige Vorschläge, dann der Durchschnitt. Bei numerischen und probabilistischen Ausgaben die Agenten unabhängig arbeiten lassen und ihre Antworten mitteln. Eine gemeinsame Debatte kann zu Herdenverhalten führen, bei dem sich die Agenten dem Überzeugendsten anschließen. Debatten von Agenten haben wir im Labor nicht getestet, wir stützen uns auf die Forschung zu menschlichen Gruppen.
- Externer Richter. Tests, Simulationen, formale Prüfung oder eine messbare Metrik. Modelle nicht sich selbst bewerten lassen.
- Erst präzise Bewertung, dann mehr Iterationen. Ein verrauschter Bewerter macht aus Iterationen eine Lotterie. In die Qualität der Überprüfung zu investieren, lohnt sich eher als in weitere Runden.
- Sperrklinke. Eine Änderung nur dann übernehmen, wenn sie das Ergebnis auf Daten verbessert, die der Agent nicht gesehen hat, und zwar um ein vernünftiges Stück. Immer die beste Version behalten.
- Überprüfbare Aussagen. Von Agenten konkrete Aussagen verlangen, die sich automatisch prüfen lassen, und sie auch prüfen.
- Betrieb. Die Zahl gleichzeitiger Aufrufe begrenzen, Konfiguration und Prompts protokollieren und Läufe so schreiben, dass sie sich nach einer Unterbrechung zu Ende führen lassen.
Für menschliche Teams
- Wenn sich die richtige Antwort vorführen lässt, etwa bei einer Berechnung, bei Code oder einer überprüfbaren Diagnose, lohnt sich die Diskussion. Ein einziger Mensch mit der richtigen Lösung genügt, sofern die anderen sie überprüfen können.
- Bei Schätzungen und Urteilen, bei denen sich die Antwort nicht vorführen lässt, die Meinungen vor der Diskussion unabhängig einsammeln. Sonst ankern alle bei der ersten Zahl oder beim Lautesten. Auf diesem Prinzip beruhen etwa Planning Poker in agilen Teams oder die Delphi-Methode.
- Wenn klar ist, wer der Experte ist, sollte er nach Rücksprache mit den anderen entscheiden. Ist das nicht klar, ist der Durchschnitt unabhängiger Meinungen sicherer als ein Anführer, der nach Selbstbewusstsein ausgewählt wurde.
- Unterschiedliche Erfahrungen verringern korrelierte Fehler. Ein Team aus Menschen von derselben Hochschule, die dieselben Nachrichten lesen, teilt auch dieselben blinden Flecken.
- In einer großen Besprechung kommt das meiste Wissen nicht zur Sprache. Einzigartige Informationen vorab schriftlich sammeln und jeden fragen, was nur er weiß.
- Abstimmungen über Fangfragen verstärken den Fehler. Wo die Mehrheit auf eine irreführende Intuition hereinfallen kann, nicht mit einfacher Mehrheit entscheiden.
Grenzen: Was das Experiment nicht beweist
Das Experiment zeigt, dass KI Theorien über ein verborgenes System entdecken und verfeinern kann. Es zeigt nichts Neues über echte Menschen und hat einige Schwächen, die man fairerweise kennen sollte.
- Die Welt ist unser Modell. Die Regeln des Simulators haben wir aus Lehrbüchern übernommen. Die Teams konnten nur entdecken, was wir hineingesteckt haben.
- Jede Welle ist ein einzelner Lauf auf anderen Daten. Unterschiede zwischen den Wellen können teilweise von den Daten und vom Glück der Teams herrühren. Wir brauchen mehr Wiederholungen.
- Die dritte Welle hat mehrere Dinge gleichzeitig geändert. Eine präzisere Zielgröße, getestete Vorhersagen im Feedback und der Schutz der verdeckten Daten kamen gleichzeitig. Wir wissen noch nicht, welche Änderung die Verbesserung der Revisionen bewirkt hat.
- Die Teams haben einen Wissensvorsprung. Das Modell kennt Condorcet und Laughlin, die Baselines nicht. Der Vergleich zeigt den Wert von Vorwissen und Mechanismen, nicht eine allgemeine Überlegenheit von Sprachmodellen gegenüber maschinellem Lernen.
- Vorhersagen können vorsichtig sein. Eine Erfolgsquote von 92 % ist nur dann eine gute Nachricht, wenn die Vorhersagen etwas riskieren. Das messen wir bisher nicht.
- Kleine Stichproben. Jeder Datensatz hat 300 Bedingungen, sodass Unterschiede um 0,01 im Brier-Score oft im Rauschen liegen. Deshalb geben wir bei den wichtigsten Vergleichen 95-%-Konfidenzintervalle aus dem Bootstrap an.
- Wahl des Vergleichs. Der Vorteil des Theoriedurchschnitts hängt davon ab, mit welcher Einzeltheorie wir ihn vergleichen. Gegenüber der besten angenommenen Theorie gewann er in allen Wellen, gegenüber der Version mit dem niedrigsten Validierungsfehler verlor er in der zweiten Welle im Test.
- Die Metrik der dritten Welle ist der MSE gegenüber dem Anteil siegreicher Gruppen, nicht der klassische Brier-Score. Die Zahlen verschiedener Wellen vergleichen wir deshalb nicht direkt.
- Ein einziges Modell. Alle Teams liefen auf Claude Opus 5.5. Andere Modelle oder eine Mischung aus ihnen können sich anders verhalten.
Wie es weitergeht
Der nächste Schritt ist herauszufinden, was genau in der dritten Welle die Verbesserung bewirkt hat. Danach wollen wir das Labor auf eine Welt loslassen, die wir nicht selbst programmiert haben.
- Ablation der dritten Welle. Wir lassen dasselbe Labor zweimal laufen: einmal ohne getestete Vorhersagen im Feedback und einmal mit nur einer Gruppe pro Bedingung. So zeigt sich, ob die Revisionen durch den präziseren Richter oder durch die Vorhersagen besser wurden. Geschätzt 2 × 20 Dollar.
- Perspektiven gegen neutrale Agenten. Vier verschiedene Perspektiven, vier neutrale Agenten und ein einzelner Agent mit demselben Budget. Wenn wir recht damit haben, dass die Stärke des Theoriedurchschnitts aus unterschiedlichen Fehlern rührt, werden die Fehler neutraler Agenten stärker korreliert sein und ihr Durchschnitt schwächer.
- Trennscharfe Experimente. Nach den ersten Theorien sucht das Labor die Bedingungen, in denen ihre Vorhersagen am stärksten auseinandergehen, simuliert sie und gibt die Ergebnisse an die Teams zurück. Ein Teil des Budgets entfällt als Kontrolle auf eine Zufallsauswahl.
- Kühnheit der Vorhersagen. Wir messen, welchen Anteil des Raums eine Vorhersage ausschließt, und belohnen kühne Vorhersagen, die zutreffen, stärker als vorsichtige.
- Mehr Wiederholungen. Mehrere Läufe jeder Version auf unterschiedlichen Daten, um Glück von Können trennen zu können.
- Echte Gruppen. Die simulierten Mitglieder ersetzen wir durch Gruppen von KI-Agenten, die echte Aufgaben lösen: Schätzungen, Logikaufgaben, Faktenfragen. Die Welt ist dann nicht mehr unser Modell, und die Theorien können etwas entdecken, das niemand hineingesteckt hat. Später ließen sich auch Gruppen von Menschen einbeziehen, mit informierter Einwilligung und ethischer Aufsicht.
- Philosophie. Dieselbe Schleife lässt sich auch auf philosophische Argumente anwenden. Formale Logik prüft, ob eine Schlussfolgerung tatsächlich aus den Prämissen folgt. Die Wahrheit der Prämissen prüft jedoch kein Richter, und gerade um sie wird in der Philosophie meist gestritten. KI könnte hier zumindest systematisch verborgene Annahmen aufdecken, aus denen die einzelnen Schlussfolgerungen hervorgehen.
Das Experiment in Zahlen
| Kennzahl | Wert |
|---|---|
| Wellen des Experiments | 3, dazu die Ergänzung der ersten Welle |
| KI-Teams | 4, Modell Claude Opus 5.5 (claude-opus-5-5) |
| Theorieversionen | 36: 4 Teams × 3 Versionen × 3 Wellen |
| Modellaufrufe | 41, davon 4 hängen geblieben, alle in der ersten Welle |
| Gesamtlaufzeit | 358 Minuten, also rund 6 Stunden |
| Kosten laut Preisliste | 63,43 USD: 18,21 + 24,67 + 20,55 |
| Bedingungen pro Welle | 900 bis 1.200 |
| Aufgaben pro Gruppe | 2.000 |
| Gruppen pro Bedingung in der dritten Welle | 10 |
| Getestete Vorhersagen | 36, davon erfüllten 33 ihre Schwelle |
| Bestes Ergebnis | MSE 0,032 im Test und 0,037 bei den großen Gruppen (dritte Welle, Antwort des Labors) |
Alle Daten, Theorien und Diagramme finden sich im interaktiven Report (auf Tschechisch).
Glossar
- Baseline: ein Vergleichsmodell des maschinellen Lernens ohne Theorie, zum Beispiel Gradient Boosting.
- Brier-Score: mittlerer quadratischer Fehler einer vorhergesagten Wahrscheinlichkeit. 0 ist eine perfekte Vorhersage, 0,25 ein Münzwurf.
- Bootstrap und 95-%-Konfidenzintervall: wiederholtes Ziehen neuer Stichproben aus den Daten. Schließt das Intervall eines Unterschieds die Null nicht ein, ist der Unterschied statistisch signifikant.
- Demonstrierbarkeit: wie leicht die anderen erkennen, dass eine ausgesprochene Antwort richtig ist.
- Extrapolation: eine Vorhersage außerhalb des Bereichs der Daten, aus denen das Modell gelernt hat.
- Falsifizierbare Vorhersage: eine Aussage, die ein Experiment widerlegen kann.
- Fehlerkorrelation: wie stark sich die Mitglieder einer Gruppe auf dieselbe Weise irren.
- Lean: ein Programm zur formalen Verifikation mathematischer Beweise.
- MSE gegenüber dem Anteil siegreicher Gruppen: Metrik der dritten Welle, mittlerer quadratischer Fehler der Vorhersage gegenüber dem Anteil der Gruppen, die ihr bestes Mitglied geschlagen haben.
- p_beats: Anteil der Gruppen, die ihr bestes Mitglied geschlagen haben.
- Sandbox: eine isolierte Umgebung, in der der Code der Theorie ohne Zugriff auf Dateien und Netzwerk läuft.
- Validierung: Daten, anhand derer über die Annahme einer Revision entschieden wird. Das Team sieht sie nie.
- Sperrklinke: eine Regel, die eine Änderung nur dann annimmt, wenn sie das Ergebnis nachweislich verbessert.
Quellen
- Physical Superintelligence: Forschungsseite zum Beweis der Vermutung von Aaronson und Ambainis und Lean-Formalisierung auf GitHub.
- Francis Galton: Vox Populi, Nature 75, 1907.
- Marquis de Condorcet: Essai sur l'application de l'analyse à la probabilité des décisions rendues à la pluralité des voix, 1785.
- Patrick R. Laughlin, Alan L. Ellis: Demonstrability and social combination processes on mathematical intellective tasks, Journal of Experimental Social Psychology 22, 1986.
- Garold Stasser, William Titus: Pooling of unshared information in group decision making, Journal of Personality and Social Psychology 48, 1985.
- Ivan D. Steiner: Group Process and Productivity, Academic Press, 1972.
- Shane Frederick: Cognitive Reflection and Decision Making, Journal of Economic Perspectives 19, 2005 (die Aufgabe mit Schläger und Ball).
Weitere Artikel
August 2026
Ich habe einen Simulator des tschechischen Quantencomputers gebaut. Jetzt können Sie ihn kostenlos von zu Hause ausprobieren
LesenJuli 2026
Vom Lösen von Textaufgaben zu Beweisjurys: fünf Jahre KI-Mathematik
LesenJuli 2026