Trzy miesiące na LUMI: AI często ma poprawną odpowiedź. Tylko nie potrafi jej wybrać.
Trzy miesiące i 4703 godziny GPU na fińskim superkomputerze. Kiedy pomaga współpraca modeli, co dało dotrenowanie ThinkingCap i dlaczego wybór poprawnej odpowiedzi bywa trudniejszy niż jej wygenerowanie. Wyniki, wykresy i zbiory danych do samodzielnej weryfikacji.

Mój projekt Fusion Playground na fińskim superkomputerze LUMI dobiega końca. W ciągu trzech miesięcy wykorzystałem 4703 z przydzielonych 5000 godzin GPU, przeprowadziłem ponad dwadzieścia eksperymentów i zebrałem ponad 305 000 ocenionych odpowiedzi. Prawie wszystkie prace badawczo-rozwojowe wykonuję sam, przy wsparciu czeskiego zespołu LUMI AI Factory w IT4Innovations.
Przyjechałem w lipcu z prostym pytaniem: Kiedy wiele modeli AI współpracuje lepiej niż jeden silny model? Ile to kosztuje?
Najciekawsze odkrycie okazało się dotyczyć czegoś innego niż rozmiar modelu. W przypadku trudnych pytań naukowych co najmniej jedna z ośmiu prób Gemmy była poprawna w 95,5% przypadków. Jednak w wyniku głosowania wybrano poprawną odpowiedź tylko w 86% przypadków. Rozwiązanie często już istniało. Po prostu zaginęło w drodze do użytkownika.
Co wyniosłem z LUMI
- Wygenerowanie większej liczby odpowiedzi nie wystarczy. W tym eksperymencie największą niewykorzystaną szansą był wybór tej właściwej.
- Dobry model ze zwięzłym rozumowaniem trudno pokonać. Gemma-4-31B uzyskała 91,3% w głównym porównaniu jakości i 91,4% w nowym zestawie. Testowane przeze mnie zespoły modeli i routery nie osiągnęły średnio lepszego wyniku.
- Współpraca ma sens, jeśli mamy ku temu dobry powód. Testy pomogły w programowaniu, wielokrotne próby pomogły w niektórych problemach matematycznych. Nie doprowadziło to jednak do powstania uniwersalnej receptury.
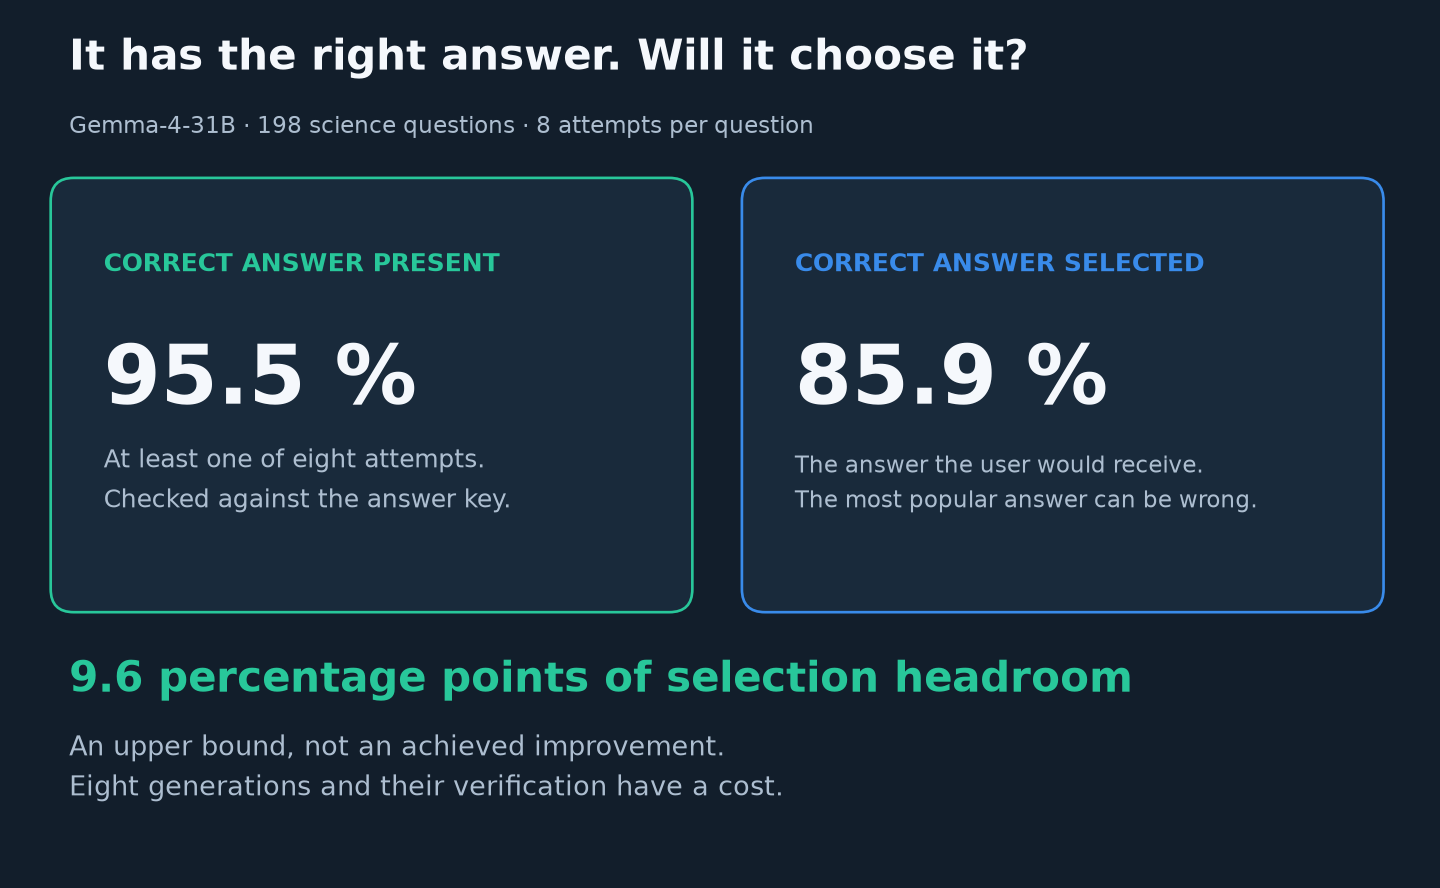
Te same osiem prób na pytanie, przy użyciu Gemma-4-31B na 198 pytaniach GPQA. Liczbę po lewej można wyznaczyć dzięki znajomości poprawnych odpowiedzi. Nie jest to dokładność systemu, który mogę dziś wdrożyć.
Osiem odpowiedzi od AI. Której warto zaufać?
Wyobraź sobie spotkanie, podczas którego ktoś proponuje właściwe rozwiązanie, ale większość opowiada się za innym. Dokładnie to samo wydarzyło się w moich eksperymentach. Więcej wygenerowanych odpowiedzi nie oznacza lepszych decyzji.
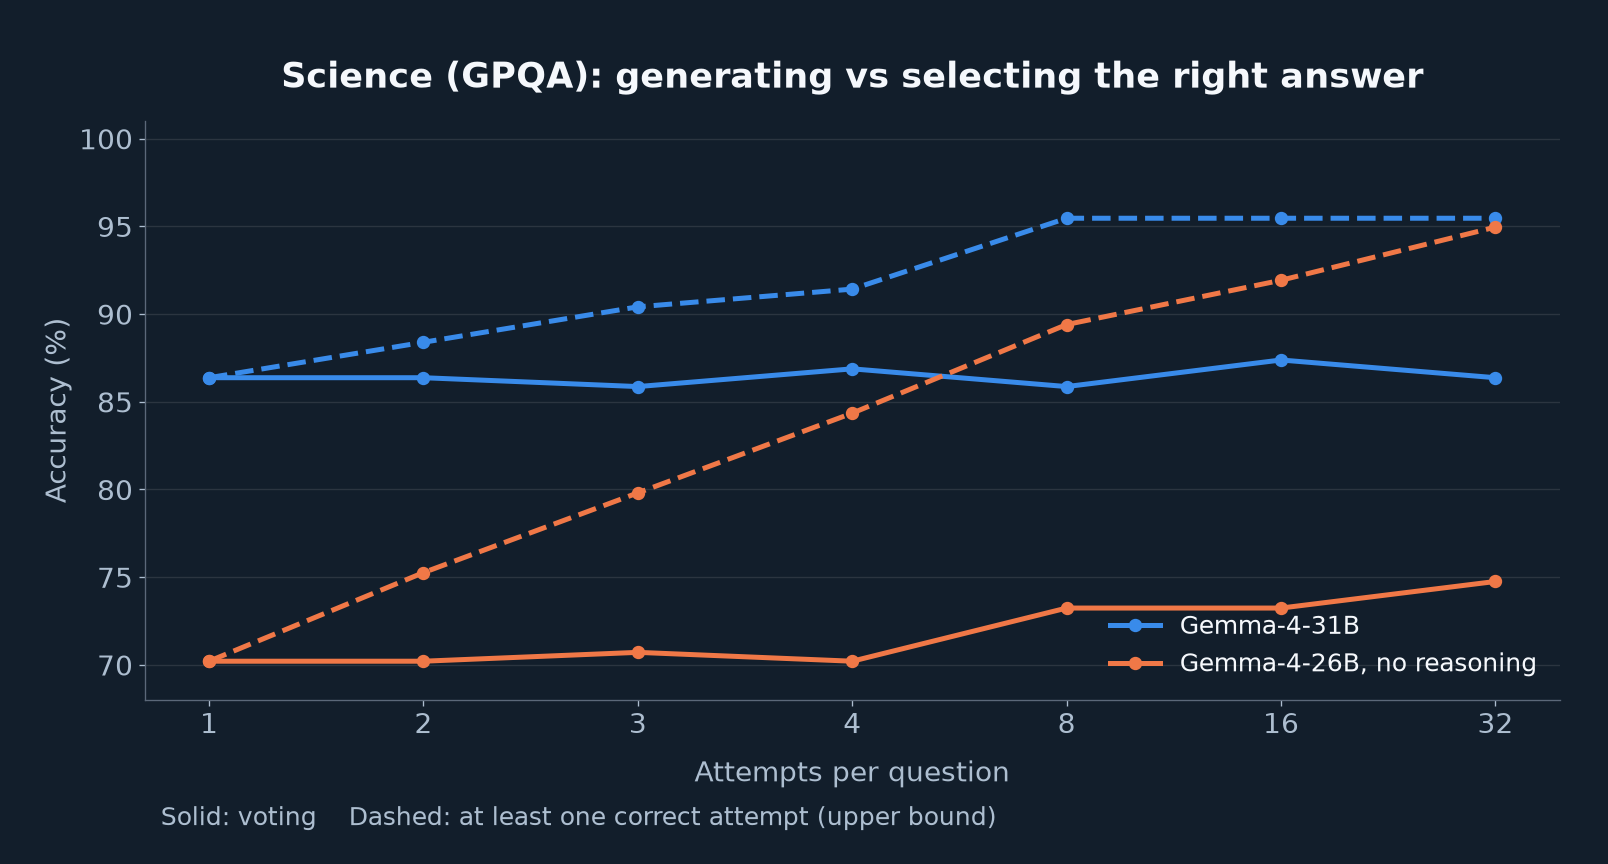
Linie ciągłe: rzeczywisty wynik głosowania. Linie przerywane: co najmniej jedna poprawna odpowiedź wśród prób. Ta górna granica wykorzystuje wiedzę o rozwiązaniu. Nawet 32 próby nie podniosły celności głosowania Gemmy-4-31B powyżej 86,4%.
Nazywam to ścianą selektora. Rzetelne wybranie właściwej odpowiedzi spośród tych ośmiu kandydatów mogłoby dodać prawie dziesięć punktów procentowych bez nowego modelu podstawowego. Nie byłoby to darmowe: zarówno wygenerowanie ośmiu odpowiedzi, jak i ich sprawdzenie kosztuje czas obliczeniowy.
Pozwolenie innej sztucznej inteligencji na podjęcie decyzji jest oczywistym kolejnym krokiem. Jednak w oddzielnym eksperymencie IFEval polegającym na przestrzeganiu instrukcji sędziowie, których testowałem, nie zgodzili się z kontrolami opartymi na regułach w 20-25% przypadków. Zapytani ponownie, zmienili werdykt w sprawie tej samej odpowiedzi w 9-25% przypadków. Nie wyklucza to sędziów AI. Oznacza to, że ci konkretni sędziowie i ustawienia wymagają walidacji. Nie można również zakładać, że dane liczbowe mają zastosowanie do zagadnień naukowych GPQA.
Sprawdzanie na solidnych podstawach sprawdzało się najlepiej: przeprowadź testy programu, przelicz wynik, sprawdź zasady formatowania. Model mówiący „to wygląda dobrze” to inny rodzaj dowodu.
Co właściwie oznacza współpraca modeli?
W Hyperspace tworzę HyperFusion, system do współpracy pomiędzy modelami oraz Atlas, który dobiera odpowiednią procedurę na podstawie zadania. Aby odczytać wyniki, warto rozróżnić cztery rzeczy:
| Procedura | Co się dzieje |
|---|---|
| Głosowanie | Model odpowiada wielokrotnie albo głosuje kilka modeli. Wygrywa najczęstsza odpowiedź. |
| Wybór | Spośród gotowych odpowiedzi wybierana jest jedna, na przykład na podstawie wyników testów. |
| Kaskada | Najpierw odpowiada tańszy model. Jeżeli odpowiedź nie może zostać odpowiednio zweryfikowana lub nie przejdzie pomyślnie testu, do pracy przystępuje silniejszy model. |
| Synteza | Inny model łączy kandydatów w nową odpowiedź. |
Wyniki jednej procedury nie są automatycznie wynikami innych. W końcowym eksperymencie mierzyłem rzeczywistą syntezę odpowiedzi w zadaniach sprawdzających przestrzeganie instrukcji oraz w pytaniach dotyczących dokumentów. Inne zadania polegały głównie na głosowaniu, selekcji lub kaskadzie. W przypadku kodu wykorzystano testy publiczne do selekcji i oddzielne testy ukryte do oceny końcowej.
Hyperspace działa również z dużymi hostowanymi modelami, które mają różne ceny i funkcje. Nie wyciągam zatem uniwersalnego wyroku na temat fuzji produkcyjnej na podstawie pomiarów modeli otwartych na LUMI.
Jeden mocny model jest trudny do pokonania
Ostateczne porównanie objęło jedenaście konfiguracji modeli i piętnaście rodzajów zadań. Oprócz przedmiotów ścisłych i matematyki obejmowały one programowanie, przetwarzanie tekstu, przestrzeganie instrukcji i czeskie egzaminy na zakończenie szkoły. W głównej matrycy na każde zadanie przypadało zwykle od czterech do ośmiu prób; w niektórych testach uzupełniających stosowano więcej powtórzeń.
Router wybiera model lub metodę w oparciu o zadanie. Porównałem pierwotne reguły i wyuczone strategie routingu z prostym podejściem: zawsze używać tego samego modelu.
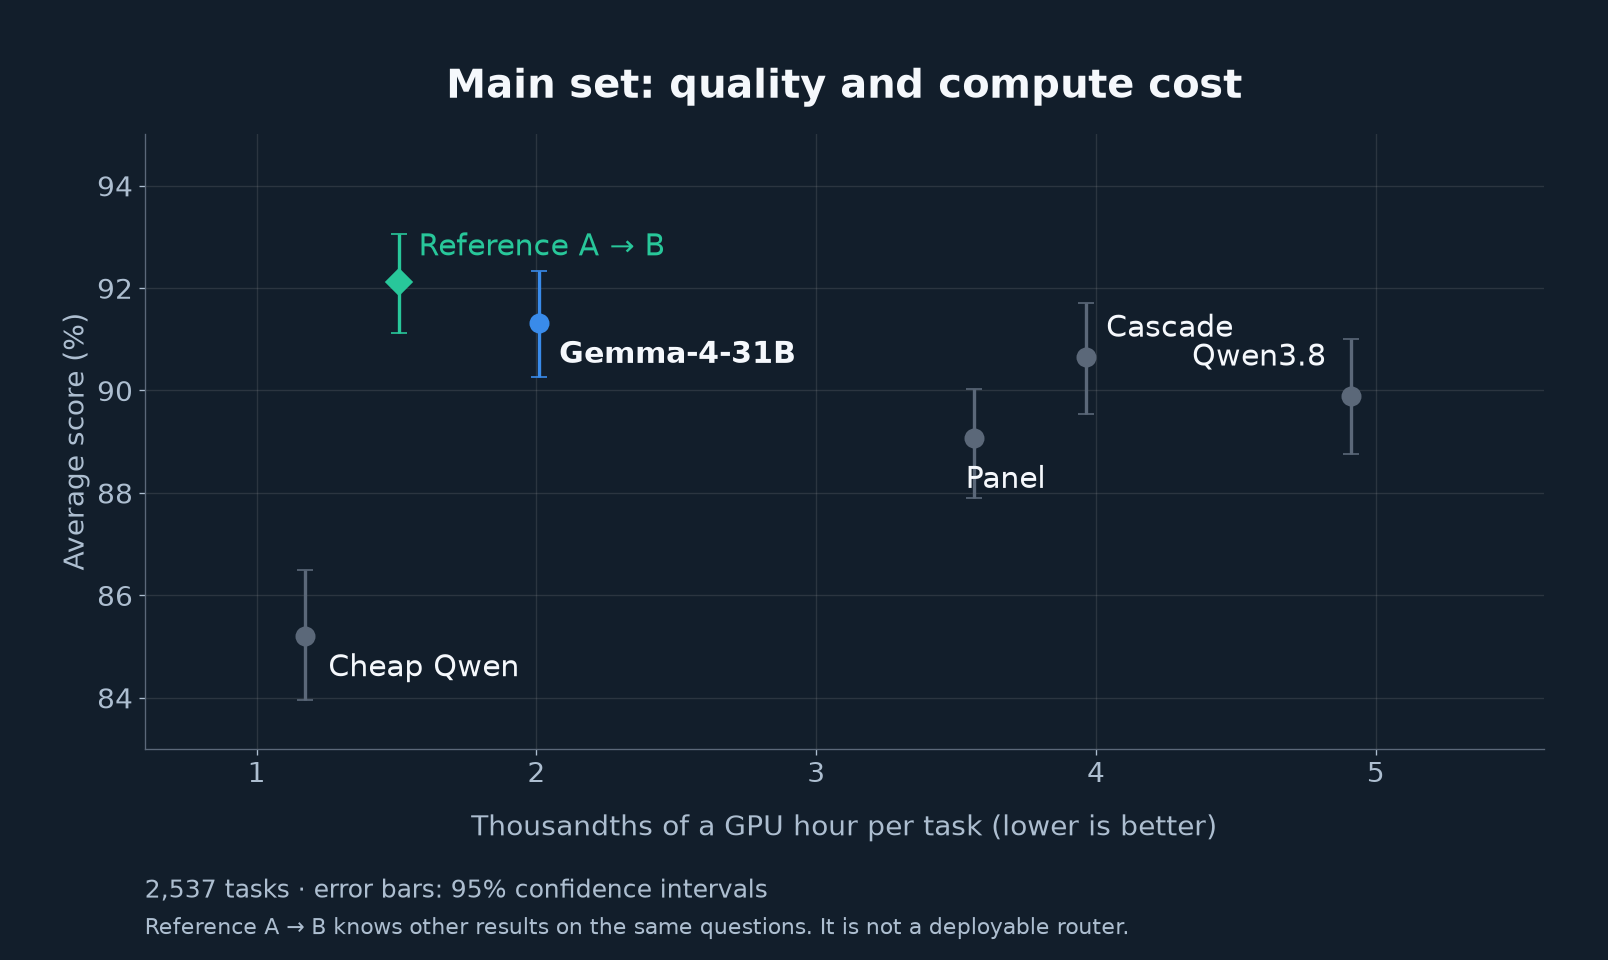
Lewy górny róg jest lepszy. Wybór referencyjny A → B zna wyniki innych prób dotyczących tych samych pytań, więc nie jest to router, który można wdrożyć. Optymistyczny wybór oparty wyłącznie na ocenionych wynikach nie jest tutaj pokazany.
| Procedura | Zestaw główny | Nowe typy zadań | Koszt: zestaw główny / nowy* |
|---|---|---|---|
| Qwen3.6-35B-A3B bez rozumowania | 85,2% | 88,7% | 1,17 / 0,71 |
| Qwen3.8-27B z rozumowaniem | 89,9% | 89,9% | 4,91 / 3,44 |
| Gemma-4-31B z rozumowaniem | 91,3% | 91,4% | 2,01 / 1,62 |
| Panel trzech modeli | 89,1% | 88,5% | 3,56 / 1,30 |
| Kaskada | 90,7% | 90,1% | 3,96 / 1,96 |
| Wyuczone routery | 90,2 do 91,3% | 90,3 do 91,4% | zgodnie z ustawieniem |
| Wybór odniesienia A → B | 92,1% | 92,8% | 1,51 / 0,96 |
Tysięczne części godziny procesora graficznego na zadanie. Jest to średni wynik określonej mieszaniny zadań, a nie uniwersalny ranking modeli. Godzina GPU oznacza tutaj godzinę pracy jednego modułu AMD MI250X.
Gemma połączyła dobre wyniki ze zwięzłym rozumowaniem. W głównym zestawie tańszy Qwen zużywał około 1/1,7 czasu GPU, ale tracił sześć punktów. Router miał zatem niewiele miejsca na błędy. Przy innej parze modeli i różnych cenach sytuacja może być znacznie korzystniejsza.
Jak duże zaufanie powinniśmy pokładać w liczbach?
Główny zestaw zawierał 2544 unikalne zadania, z czego 2537 przeszło do ścisłego porównania ze wszystkimi niezbędnymi odpowiedziami. W nowym zestawie dodano 1455 problemów sześciu dodatkowych typów. Reguły routera ustaliłem przed odczytaniem wyników nowego zestawu. Przy wyborze i ocenie zasad zastosowano również osobne powtórzenia, a szkolenie routerów również obejmowało podział według unikalnych pytań.
Nie każda dziesiąta część punktu oznacza rzeczywistą poprawę. Na przykład 91,3% dla Gemmy ma 95% przedział ufności w głównej analizie wynoszący około 90,3 do 92,3%. Dlatego małe różnice opisuję jako zaobserwowane wyniki, a nie jako udowodnioną wyższość. Powtarzające się odpowiedzi na to samo pytanie również nie są niezależnymi nowymi pytaniami.
W późniejszych eksperymentach z innymi recepturami i weryfikatorami ponownie wykorzystano dane, których wyniki zostały już sprawdzone. Są przydatne do znalezienia następnego kierunku, ale wymagają innego osobnego testu. Jest to szczególnie prawdziwe w przypadku oszczędności z JEV poniżej.
Kiedy wielokrotne próby naprawdę się opłaciły?
| Sytuacja | Co zadziałało | Zaobserwowany wynik |
|---|---|---|
| Programowanie z testami | Tani model, weryfikacja, potem ewentualnie mocniejszy model | Porównywalna jakość w mniej więcej połowie czasu GPU: 85,2% dla 3,0 w porównaniu z 84,8% dla 5,6 tysięcznych godziny GPU |
| Programowanie z naciskiem na jakość | Powtarzanie odpowiedzi silnego modelu i sprawdzanie ich testami | Około +1,4 do +1,9 punktów za cenę wyższą o 17 do 40% |
| Matematyka konkursowa | Głosowanie wielokrotne lub odpowiedni panel | W jednym porównaniu +3,4 punktu za 2,2-krotność ceny |
| Specjalistyczne pytania naukowe | Różne modele lub kaskada | Około +1,3 do +2,0 punktów, za od dwóch do sześciu razy więcej |
| Wyszukiwanie i obliczanie z tekstu | Tani model bez rozbudowanego uzasadnienia | Podobna lub lepsza jakość, od trzech do siedmiu razy tańsza |
W matematyce byłem zaskoczony, jak duży wpływ ma układ błędów. Mniejsza Gemma, z wyłączonym rozumowaniem, znacznie się poprawiła po wielokrotnych próbach. Silniejsza Gemma-4-31B ledwo się poprawiła. Głosowanie pomaga, gdy próby różnią się w użyteczny sposób. Powtórzenie tego samego błędu nie sprawi, że zniknie on w głosowaniu większościowym.
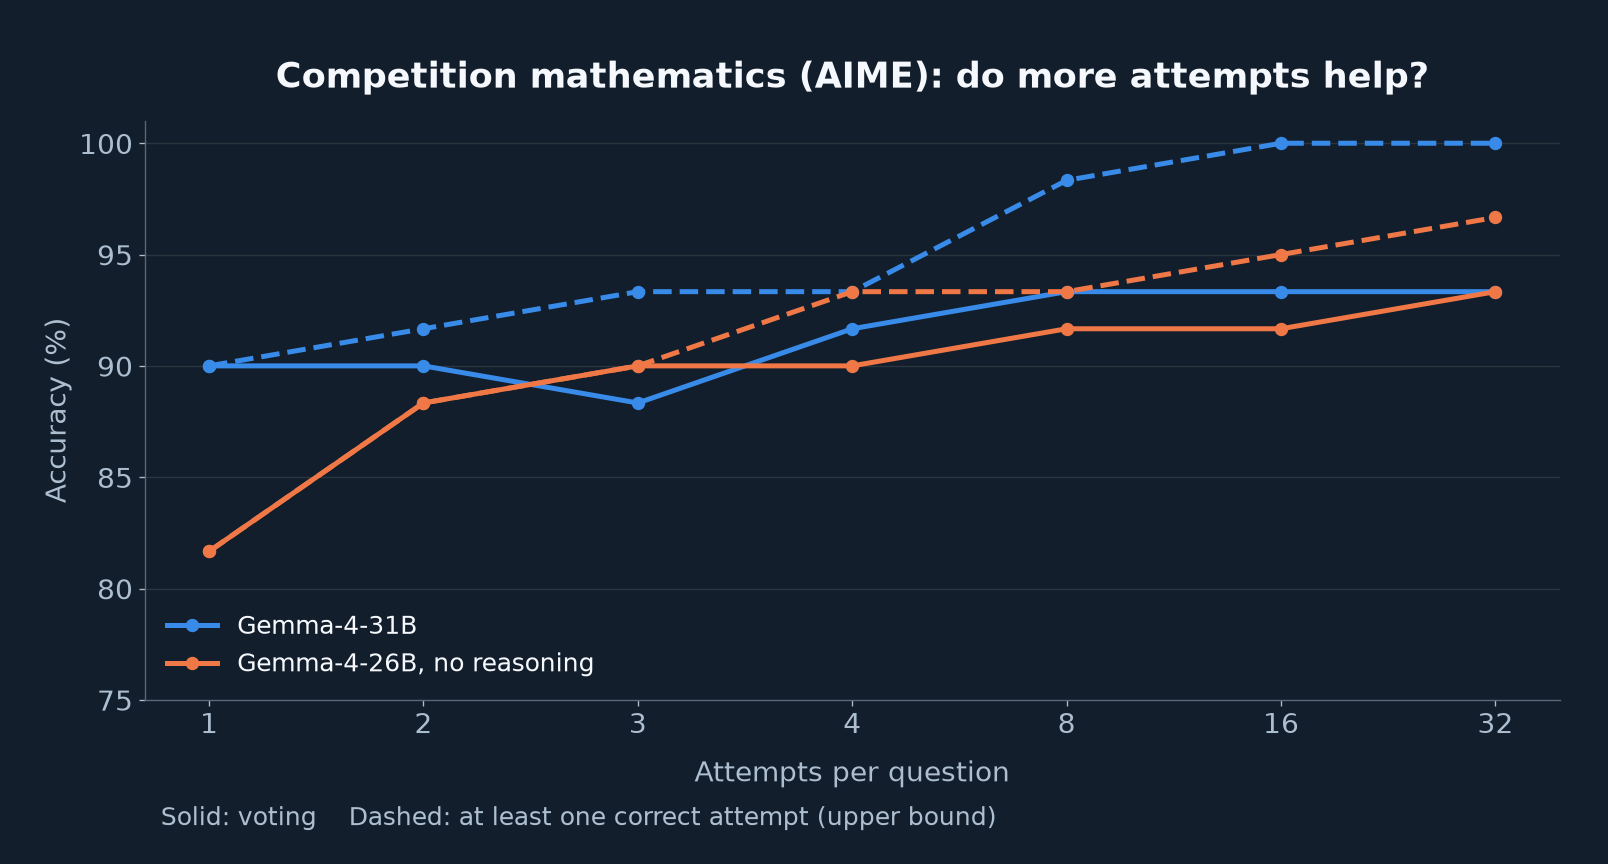
AIME zawiera 60 problemów konkursowych. Linia ciągła pokazuje wynik głosowania, linia przerywana oznacza co najmniej jedną poprawną próbę. Mała liczba pytań to kolejny powód, aby nie przeceniać drobnych różnic.
ThinkingCap: lepsza matematyka w 30 godzinach GPU
Jeden z najbardziej obiecujących wyników przyniosło dotrenowanie ThinkingCap-Qwen3.6-27B od BottleCap AI, firmy Tomáša Mikolova. Model ma już na celu zachowanie zwięzłości rozumowania. Chciałem sprawdzić, czy uda się go jeszcze poprawić.
Dla wariantu pokazanego na wykresie wykorzystałem 1400 przykładów matematycznych oraz 469 odpowiedzi naukowych i programistycznych wygenerowanych przez oryginalny model. Dla prostszej matematyki wybierałem krótkie poprawne rozwiązania, dla trudniejszych przykładów dłuższe. Oryginalne odpowiedzi miały pomóc zachować inne zdolności. Jedna taka sesja szkoleniowa trwała około 30 godzin GPU. Cała seria prób i ocen kosztowała więcej.
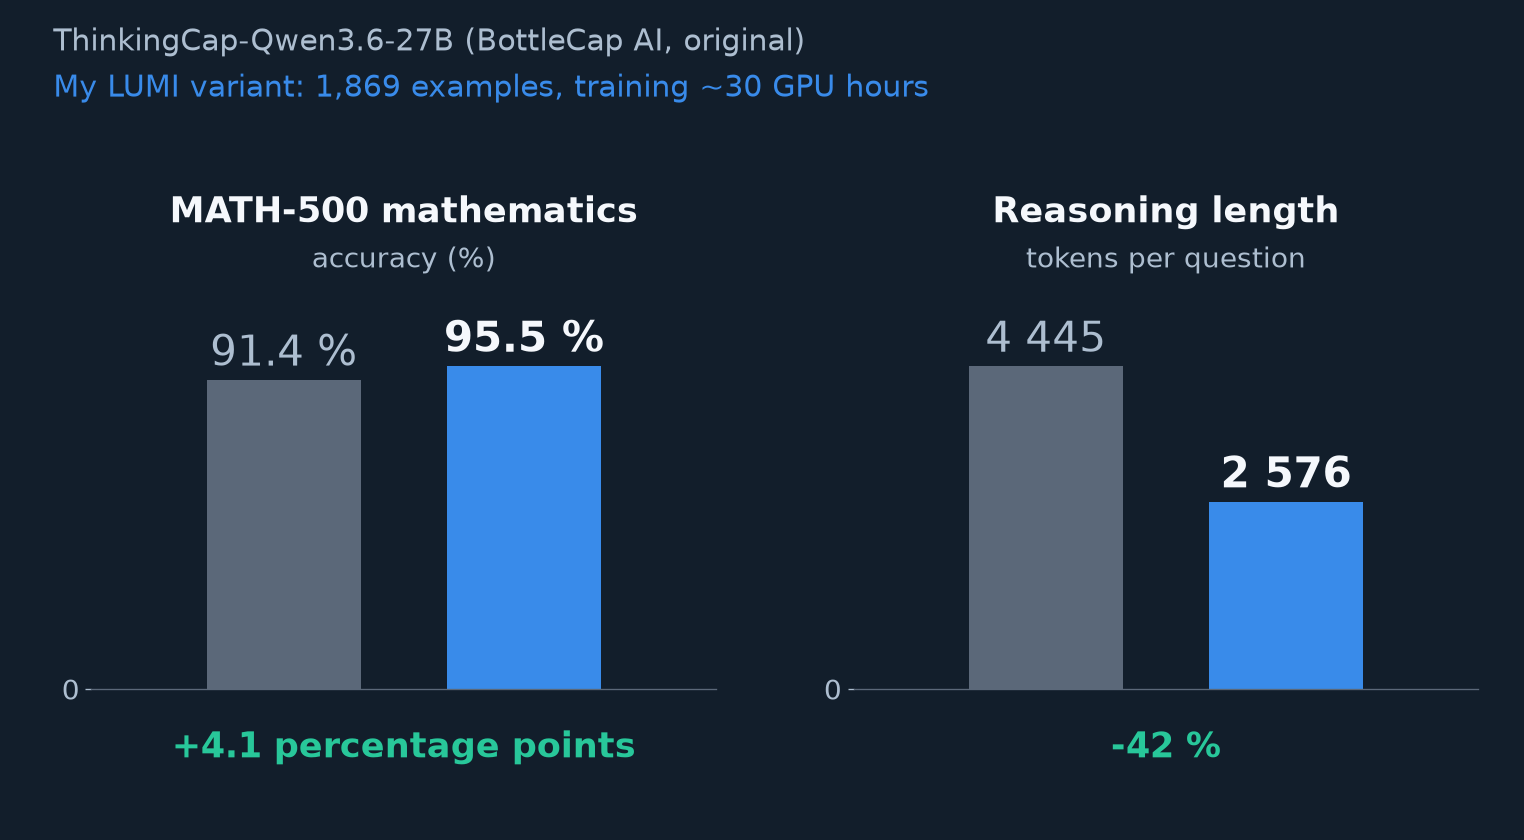
MATH-500: 500 pytań, po trzy razy każde, czyli 1500 prób na wariant. Ten sam dostrojony wariant zyskał 4,1 punktu procentowego i skrócił rozumowanie o 42%.
Bardziej dokładny i jednocześnie bardziej zwięzły niż oryginalny ThinkingCap. Jak na konkretny zestaw matematyczny, jest to bardzo dobry wynik przy niewielkim budżecie szkoleniowym.
Ma to jednak swoją cenę: ten sam wariant spadł o 3,3 punktu w matematyce konkursowej AIME i 5,6 punktu w pytaniach naukowych GPQA. Inny z pięciu wariantów treningu stracił mniej na pytaniach naukowych, ale był to inny model. Ich najlepsze liczby nie mogą zostać połączone w jednego zwycięzcę. Poprawiłem konkretną zdolność matematyczną, nie przebiłem ThinkingCap we wszystkim.
Przed szkoleniem sprawdziłem zarówno dokładne, jak i prawie pokrywające się teksty za pomocą testów MATH-500, AIME i GPQA; zastosowana kontrola nie wykryła takich podobieństw. Nie daje to całkowitej gwarancji, że podobne zadania nie miały miejsca w pierwotnym szkoleniu przygotowawczym. Jest to wersja oparta na Qwen3.6: BottleCap w międzyczasie wypuścił nowszą ThinkingCap-Qwen3.8, względem której nie mierzę tego wyniku.
Lepszy weryfikator zamiast większego modelu?
Atlas wykorzystuje szybki, wyspecjalizowany model JEV firmy TypeSafe do szacowania właściwości wejściowych. Wypróbowałem go również jako weryfikator już wygenerowanych odpowiedzi. W tych dalszych badaniach uzyskał lepsze wyniki niż samo oszacowanie trudności pytania.
| Sygnał do podjęcia decyzji, kiedy wystarczy tani model | AUC | Jakość przy około połowie czasu GPU Gemmy |
|---|---|---|
| Oryginalne pytania JEV dotyczące właściwości zadania | 0,77 | 88,8% |
| Nowe pytania JEV dotyczące trudności | 0,79 | 89,3% |
| Właściwości tekstu bez JEV | 0,61 | 88,3% |
| Weryfikacja odpowiedzi przez Gemma-4-31B | 0,77 | 89,4% |
| Sprawdzanie odpowiedzi za pomocą Qwen3.6 | 0,82 | 88,8% |
| Weryfikacja odpowiedzi przez JEV | 0,84 | 89,8% |
AUC opisuje, jak dobrze sygnał klasyfikuje przypadki według ryzyka błędu. Wartość 0,5 odpowiada kolejności losowej, 1 - idealnej. AUC wynoszące 0,84 nie oznacza 84% trafności odpowiedzi.
Przy tym ustawieniu oszczędność około 30% czasu procesora graficznego kosztuje pół punktu procentowego jakości. Oszczędność połowy czasu procesora graficznego kosztuje około półtora punktu. Są to punkty wybrane z krzywej zmierzonej na już wykorzystanych danych, a nie gotowa gwarancja na nowe zapytania klientów. Wywołania API do JEV kosztują dodatkowo 0,00005 USD za zadanie; ten koszt w dolarach nie jest uwzględniony w liczbach godzin pracy procesora graficznego.
JEV to wciąż model, który może popełniać błędy. Nie jest to odpowiednik testu wykonywalnego. Wypróbowałem także inne weryfikatory w konkretnej oszczędnej konfiguracji, ale nie we wszystkich możliwych formach. Niemniej jednak jest to bardziej obiecująca wskazówka do dalszej pracy niż zwykłe wrażenie trudności zadania.
Nowa generacja może mieć większe znaczenie niż miliardy dodatkowych parametrów
Nawet same modele zmieniły się w ciągu trzech miesięcy. W porównaniu z Qwen3.6-27B tej samej wielkości, Qwen3.8-27B zyskał w tych testach około 13 punktów procentowych z matematyki konkursowej i 18 punktów procentowych z programowania. Jednocześnie zużywał na te zadania około połowę czasu procesora graficznego.
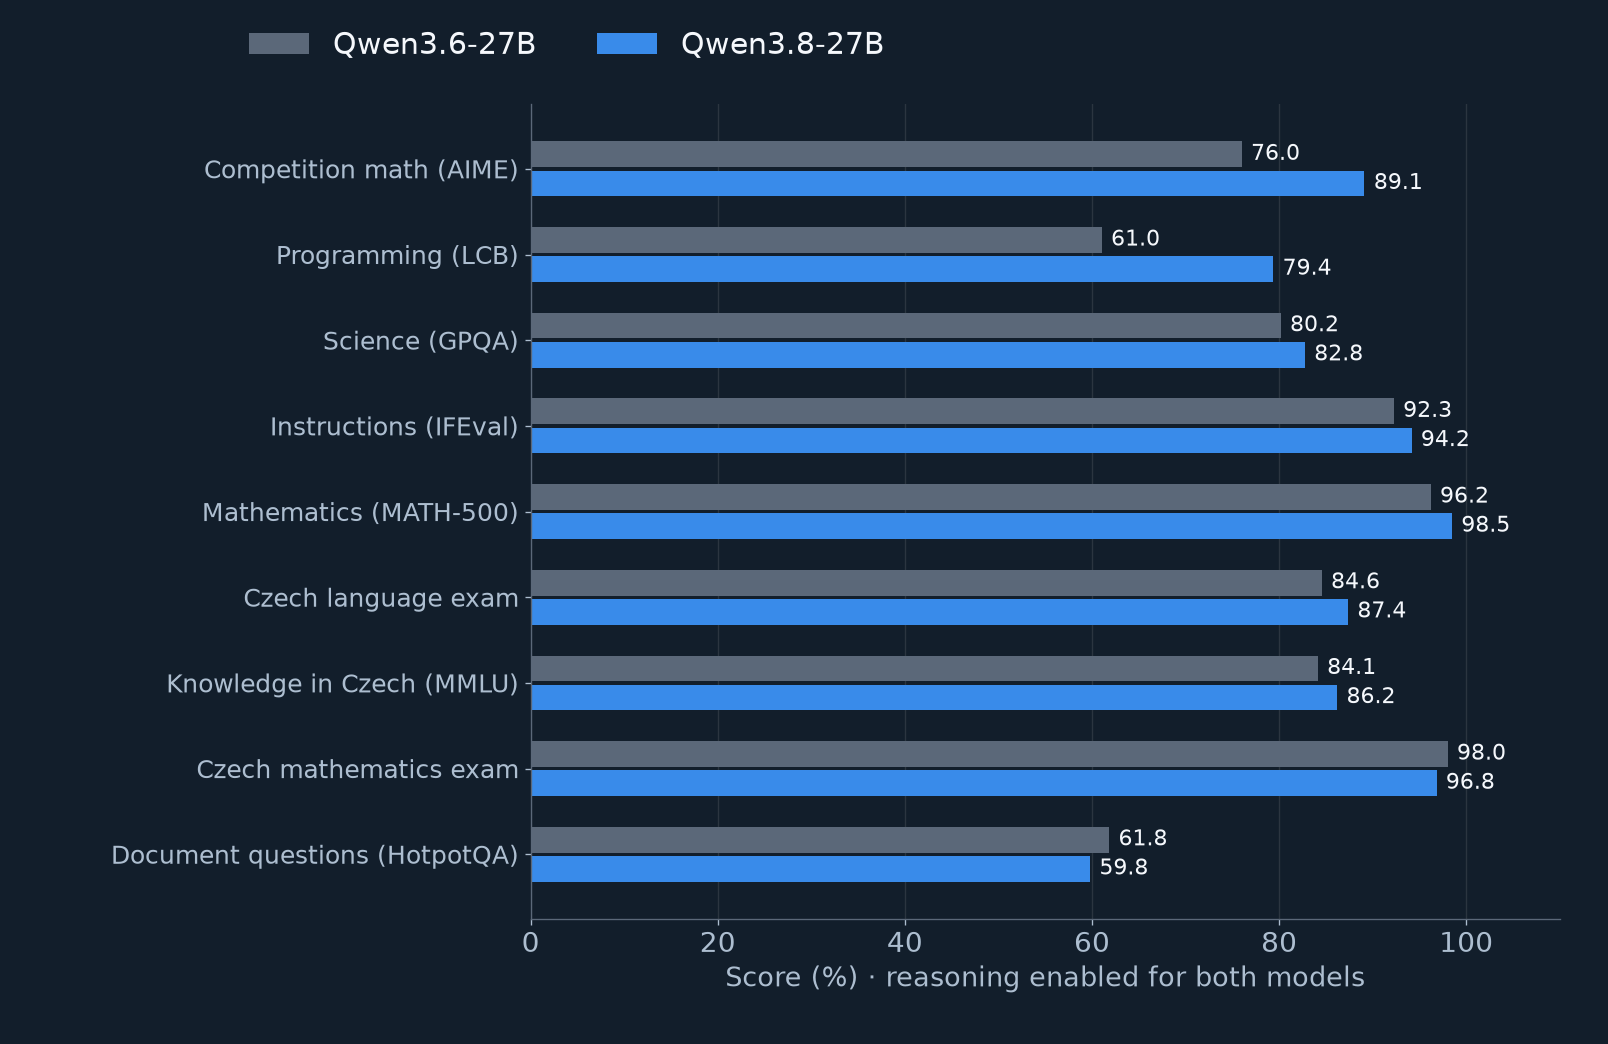
Rozumowanie zostało włączone dla obu modeli. Poprawa nie była powszechna: w niektórych zadaniach z tekstem i czeską matematyką nowszy model nieznacznie stracił. Sensowne jest ciągłe mierzenie modeli w ramach własnych zadań.
Przeciwną niespodziankę przyniósł MiMo-V2.6-Pro z około bilionem parametrów, największy model w ostatecznym porównaniu. Mieści się w jednym węźle w postaci skompresowanej, średnio 3,5 bita na parametr.
| MiMo-V2.6-Pro, 3,5 bit | Gemma-4-31B | |
|---|---|---|
| Pytania naukowe GPQA | 78,3% | 85,9% |
| Egzamin maturalny z języka czeskiego | 92,2% | 91,0% |
| Godziny pracy procesora graficznego na pytanie GPQA | około 0,52 | około 0,005 |
MiMo wypadło dobrze na egzaminie z języka czeskiego, ale było znacznie droższe i mniej dokładne na GPQA. Przy jednej piątej trudnych pytań model osiągnął limit długości odpowiedzi. Wariant MXFP4 o większej precyzji uzyskał o 4,7 punktu wyższy wynik na 64 pytaniach, na które oba warianty ukończyły odpowiedź, bez skróconych odpowiedzi. To ciekawa wskazówka, ale i mała, wyselekcjonowana próbka.
Przyczyną może być kompresja, jakość konkretnej wersji modelu, sposób jej uruchomienia i ustawione limity. MiMo działał przez llama.cpp, Gemma przez vLLM. Dodatkowo MiMo wykorzystuje architekturę MoE, która aktywuje tylko część parametrów dla każdego tokena. Nie jest to czysty eksperyment „bilion kontra 31 miliardów” i nie można go używać do potępienia modelu jako takiego.
Z taką samą ostrożnością interpretuję wcześniejsze porównania płatnego API:
| Mały test porównawczy | Przez API | w LUMI |
|---|---|---|
| GPQA, 138 pytań | Gemini 3.1 Pro 93,5%, Claude Sonnet 5 86,2% | Gemma-4-31B 84,1% |
| GLM-5.2, punktowane zadanie otwarte | 60 punktów na 60 | Wersja 4-bitowa: 35 punktów na 60 |
| Kimi K3, 40 zadań programistycznych | 31 poprawnych | Wersja 2-bitowa: 28 poprawnych |
Ostatni wiersz oznacza około 90% wyniku wersji API w tym konkretnym teście. Nie oznacza zachowania 90% wszystkich zdolności Kimi. Różnice pomiędzy API a wersją lokalną również same w sobie nie izolują efektu kwantyzacji, czyli kompresji wag numerycznych modelu. Może to działać dobrze, ale należy sprawdzić każdy konkretny plik i metodę wykonania.
Dwa ustalenia, o których szkoda byłoby zapomnieć
Długie dokumenty będą testować inną zdolność niż krótki test porównawczy. W teście pytań dotyczących dokumentów dodałem rozpraszający tekst i rozszerzyłem kontekst z około 8 tys. do 120 tys. tokenów. Testowane modele Qwen straciły około 2-5 punktów w wyniku F1, gpt-oss około 18. Nie jest to werdykt w przypadku wszystkich długich dokumentów, ale dobrze pokazuje, dlaczego rozmiar okna kontekstowego nie jest wystarczającą miarą jakości.
Ważne jest, kto ocenia. We wcześniejszej próbie podsumowania synteza zwyciężyła w 92,7% porównań, jeśli została oceniona przez ten sam model, który ją wyprodukował. W przypadku niezależnego oceniającego Llama było to 57,3%. Zmienił się oceniający, więc nie jest to dokładny pomiar jednej przyczyny. Ale różnica wystarczy jako ostrzeżenie przed modelem wystawiającym sobie świadectwo.
Jaki to ma związek z innymi badaniami
Moje eksperymenty nie są pierwszą pracą nad współpracą modeli. Pomagają mi przełożyć ogólne pomysły na konkretne koszty i ograniczenia LUMI:
- Self-Consistency pokazuje zalety wielu ścieżek rozwiązywania problemów i głosowania. Moje wyniki przypominają mi, że zależy to również od tego, jak podobne błędy popełniają próby.
- Mixture-of-Agents bada syntezę odpowiedzi wielu modeli. To inny proces niż samo głosowanie.
- RouteLLM rozwiązuje wybór modelu według stosunku jakości do ceny. Wynik takiego routera zawsze zależy od tego, jakie modele wybierze.
- Let’s Verify Step by Step bada trenowanie modeli do sprawdzania poszczególnych kroków rozwiązania. Moje dane zwykle oceniają tylko ostateczną odpowiedź, więc w przypadku podobnego podejścia konieczne byłoby dodanie innego rodzaju adnotacji.
- W artykule Quantization Inflates Reasoning opisano, że kompresja może wydłużyć rozumowanie. Jest to możliwe wyjaśnienie części moich obserwacji, a nie dowód związku przyczynowego w konkretnym uruchomieniu MiMo.
Czego się dowiedziałem o samym superkomputerze
Podczas końcowych eksperymentów jednocześnie działało do 140 zadań programu planującego. Każde obsługiwało wiele zapytań. Ta współbieżność pozwoliła zmieścić około 2900 godzin procesora graficznego w ciągu jednego dnia i nocy; nie oznacza to jednak, że jeden użytkownik tak długo czekał na odpowiedź.
Podział pracy zrobił wielką różnicę. Jeden węzeł LUMI ma cztery moduły MI250X, łącznie osiem układów obliczeniowych GCD. W przypadku modelu mieszczącego się w pamięci dwóch układów mógłbym uruchomić cztery oddzielne kopie zamiast jednej na ośmiu chipach.
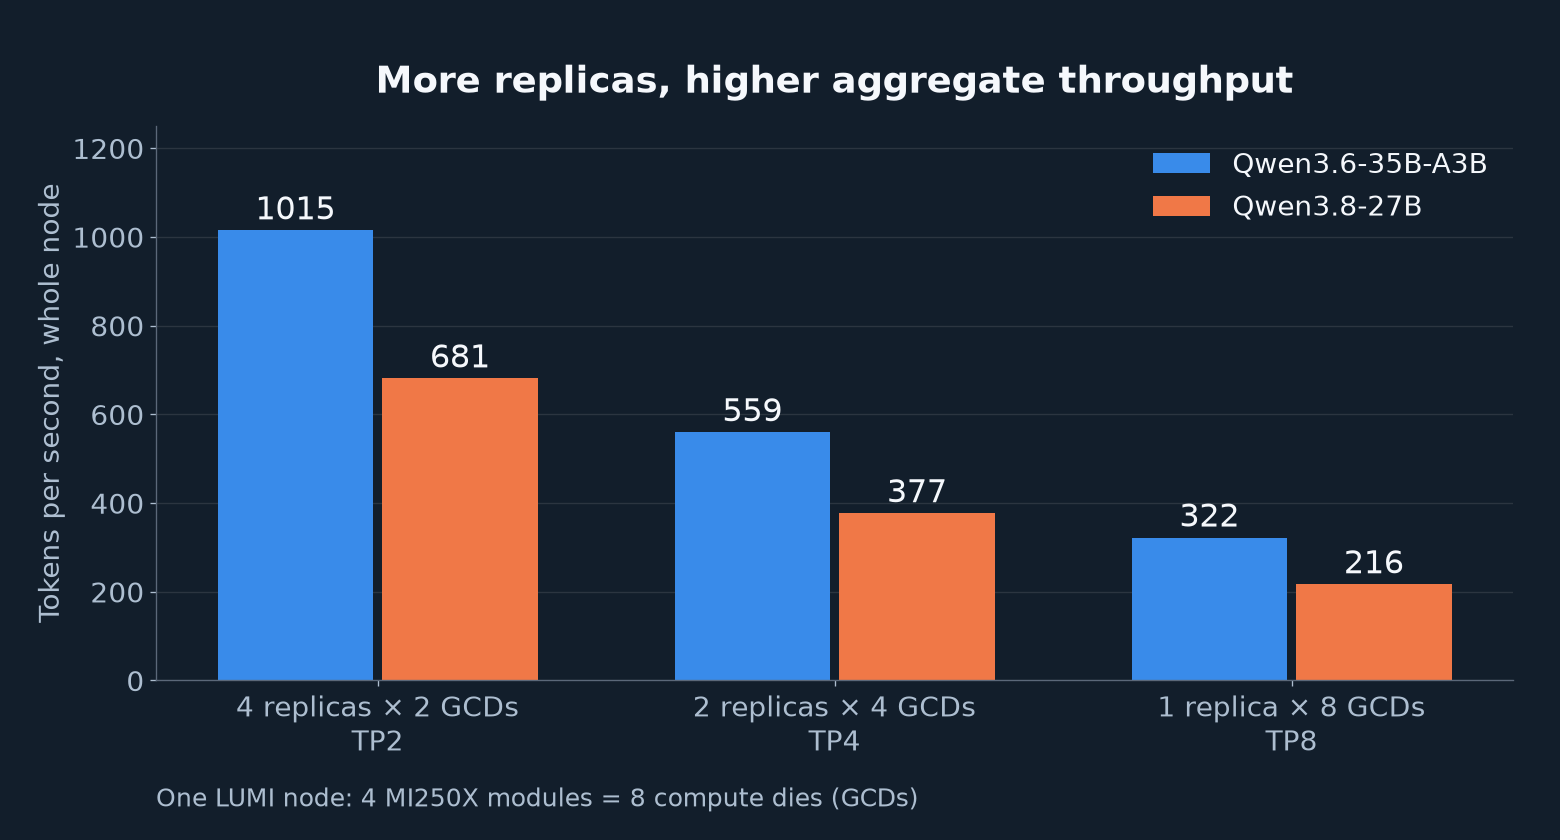
Qwen3.6-35B-A3B: około 1015 w porównaniu z 322 tokenami na sekundę. Mierzę łączną przepustowość węzła w wielu zapytaniach, a nie szybkość pojedynczej odpowiedzi. Mniejsze egzemplarze pomogą, jeśli model zmieści się w pamięci i będzie z czym pracować.
Stale mierzę też moc GPU. Według tych pomiarów, w końcowych eksperymentach zużyto 562 kWh na akceleratory. Nie obejmuje całego serwera, sieci ani chłodzenia.
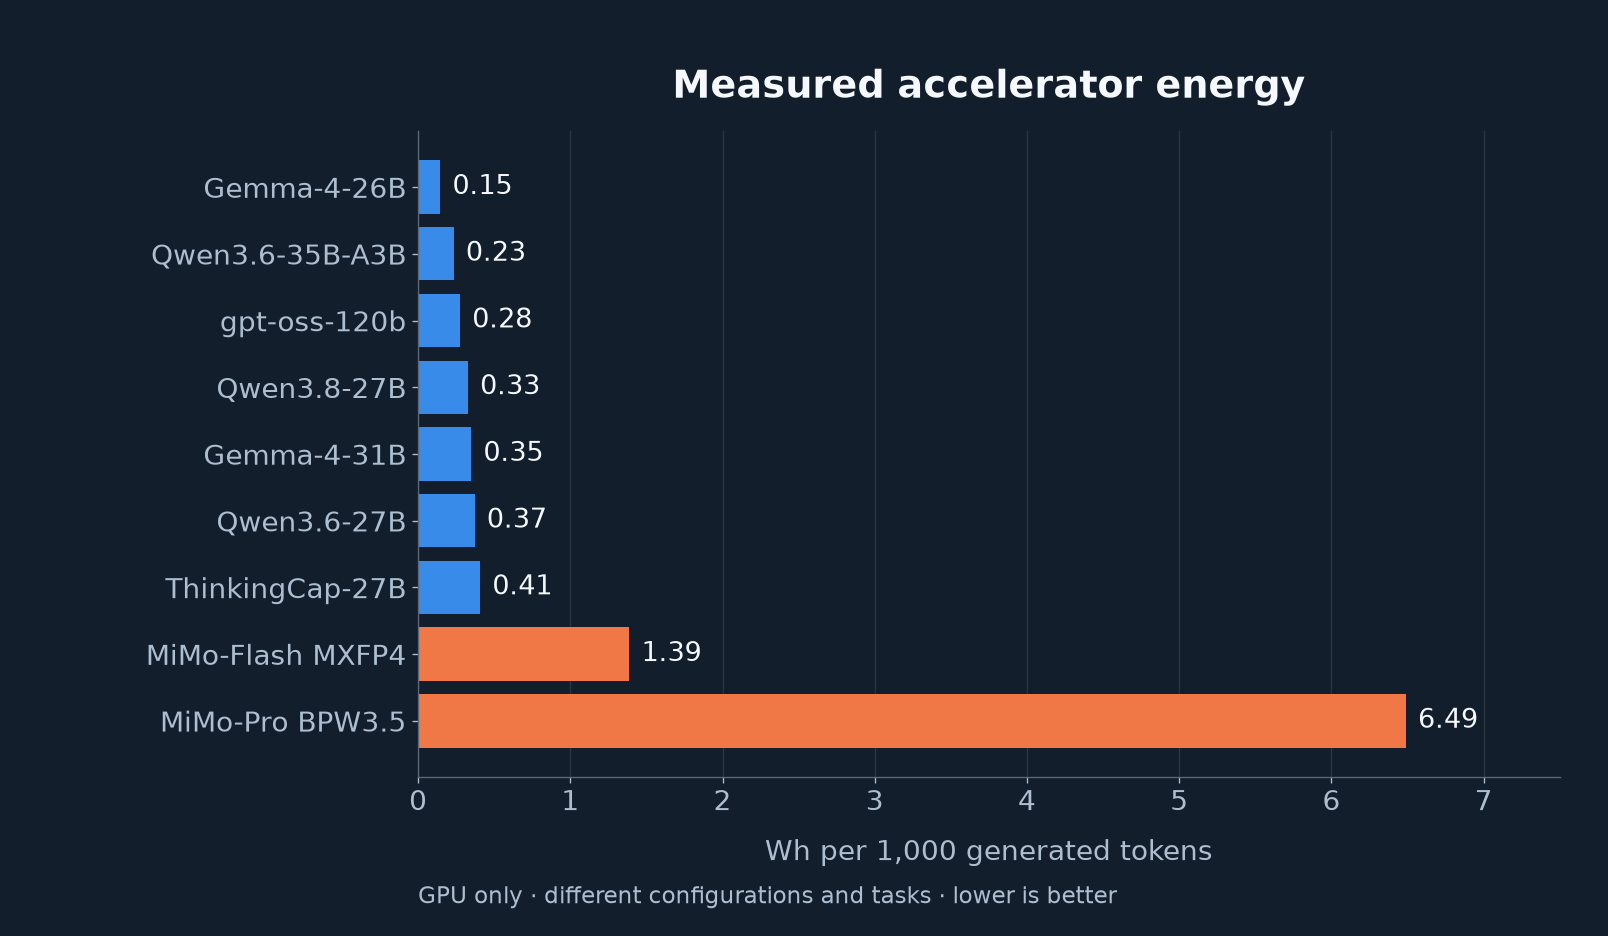
Energia na token pomaga porównać efektywność inferencji. Ale w prawdziwym zastosowaniu ważniejsza jest energia na poprawnie rozwiązane zadanie. Krótsza odpowiedź może być ogólnie bardziej ekonomiczna, nawet przy droższym tokenie.
Co poszło nie tak i ile to kosztowało
Niektóre wyniki kosztowały niepotrzebnie dużo czasu. Dwa razy ustawiłem zbyt krótki limit rozumowania. Regenerowanie okrojonych odpowiedzi pochłonęło 777 godzin procesora graficznego, czyli mniej więcej jedną szóstą budżetu. Nauczyłem się też nie ufać tymczasowym wynikom: łatwiejsze pytania kończą się jako pierwsze, dzięki czemu początkowe wyniki wyglądają lepiej.
W pierwszej analizie porównałem także panele z jednego badania z indywidualnymi modelami uśrednionymi z wielu prób. Poprawiłem metodologię; w powyższej tabeli głównej zastosowano już oddzielne powtórzenia i porównywalne oceny.
W przypadku agenta kodującego w SWE-bench wskaźnik sukcesu wzrósł z 42 do 61%, ale zasługa ta wynikała z lepszych narzędzi i zarządzania pracą, a nie z dotrenowania modelu. Nawet negatywny wynik pomaga uniknąć kolejnej ślepej uliczki.
| Pozycja | Wynik |
|---|---|
| Wykorzystana alokacja | 4703 z 5000 godzin GPU, rezerwa 297 |
| Końcowe eksperymenty | około 2900 godzin GPU |
| Energia finału | 562 kWh, tylko GPU |
| Ocenione odpowiedzi | 305 051 odpowiedzi i kolejne 5 314 rozwiązań programowych |
| Płatne API | około 42 dolarów, z czego w sumie około 0,85 dolara za JEV |
305 tys. odpowiedzi to nie 305 tys. różnych pytań. Liczba obejmuje różne modele i powtórzenia. Podane godziny pracy procesora graficznego dotyczą wykorzystania przyznanego czasu obliczeniowego, a nie rachunku opłaconego gotówką.
Trzy miesiące, na których chcę budować
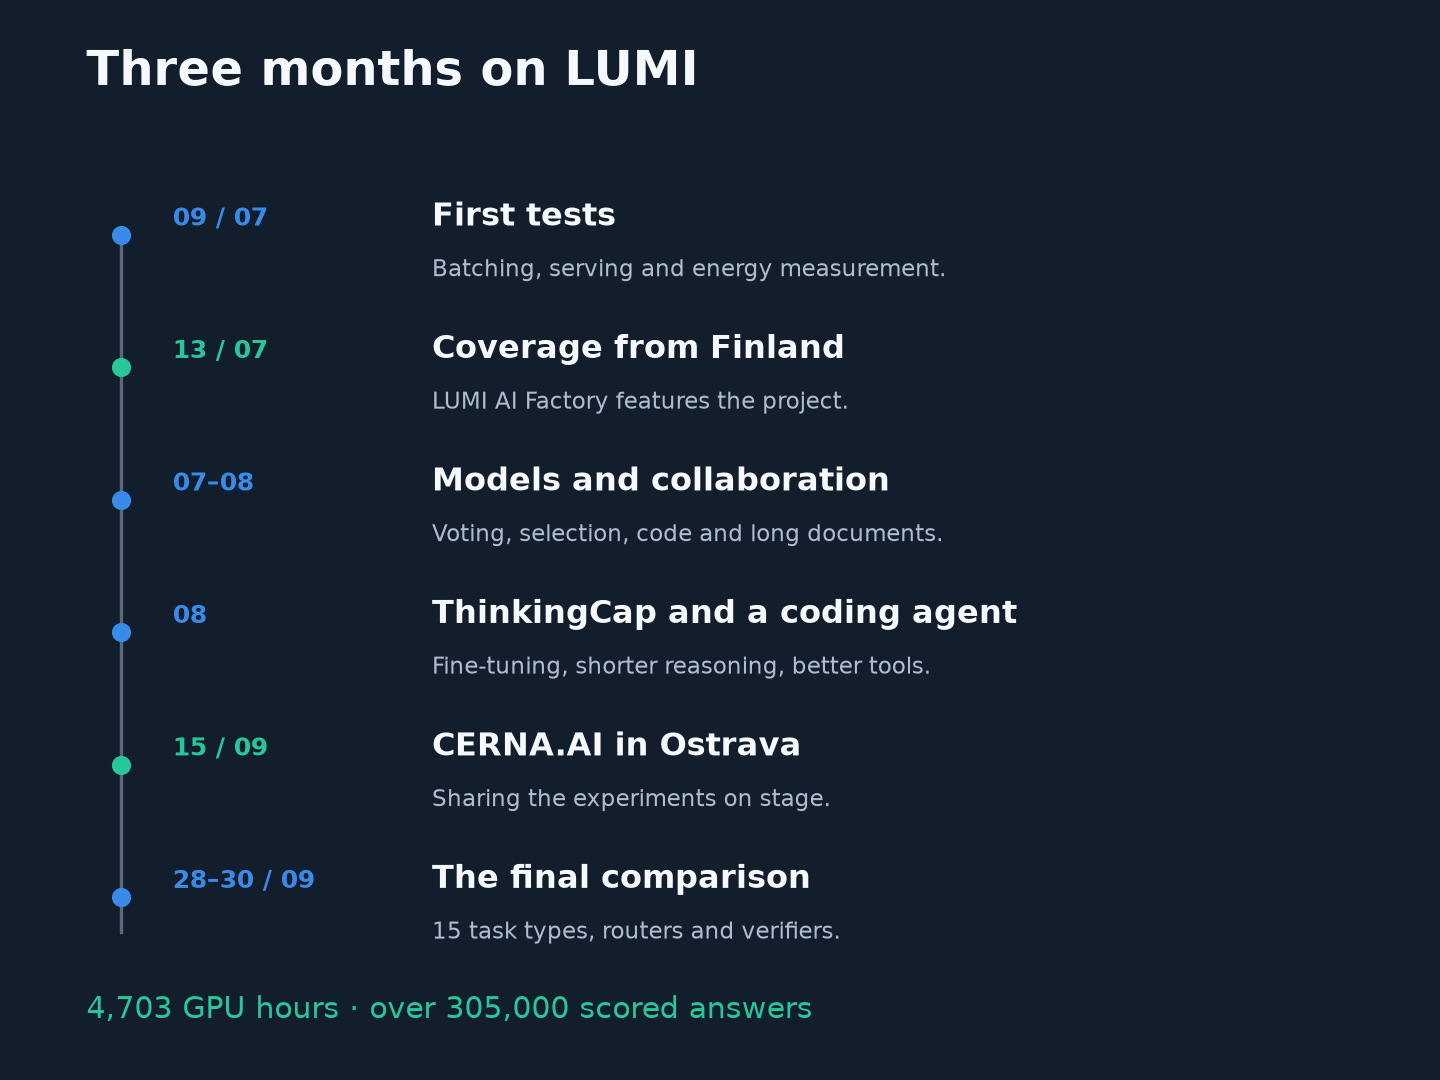
Pierwsze doświadczenia opisałem w artykułach o ogrzewaniu LUMI i Kajaani oraz o pierwszych fuzjach i GLM-5.2. W lipcu LUMI AI Factory również napisała o projekcie.
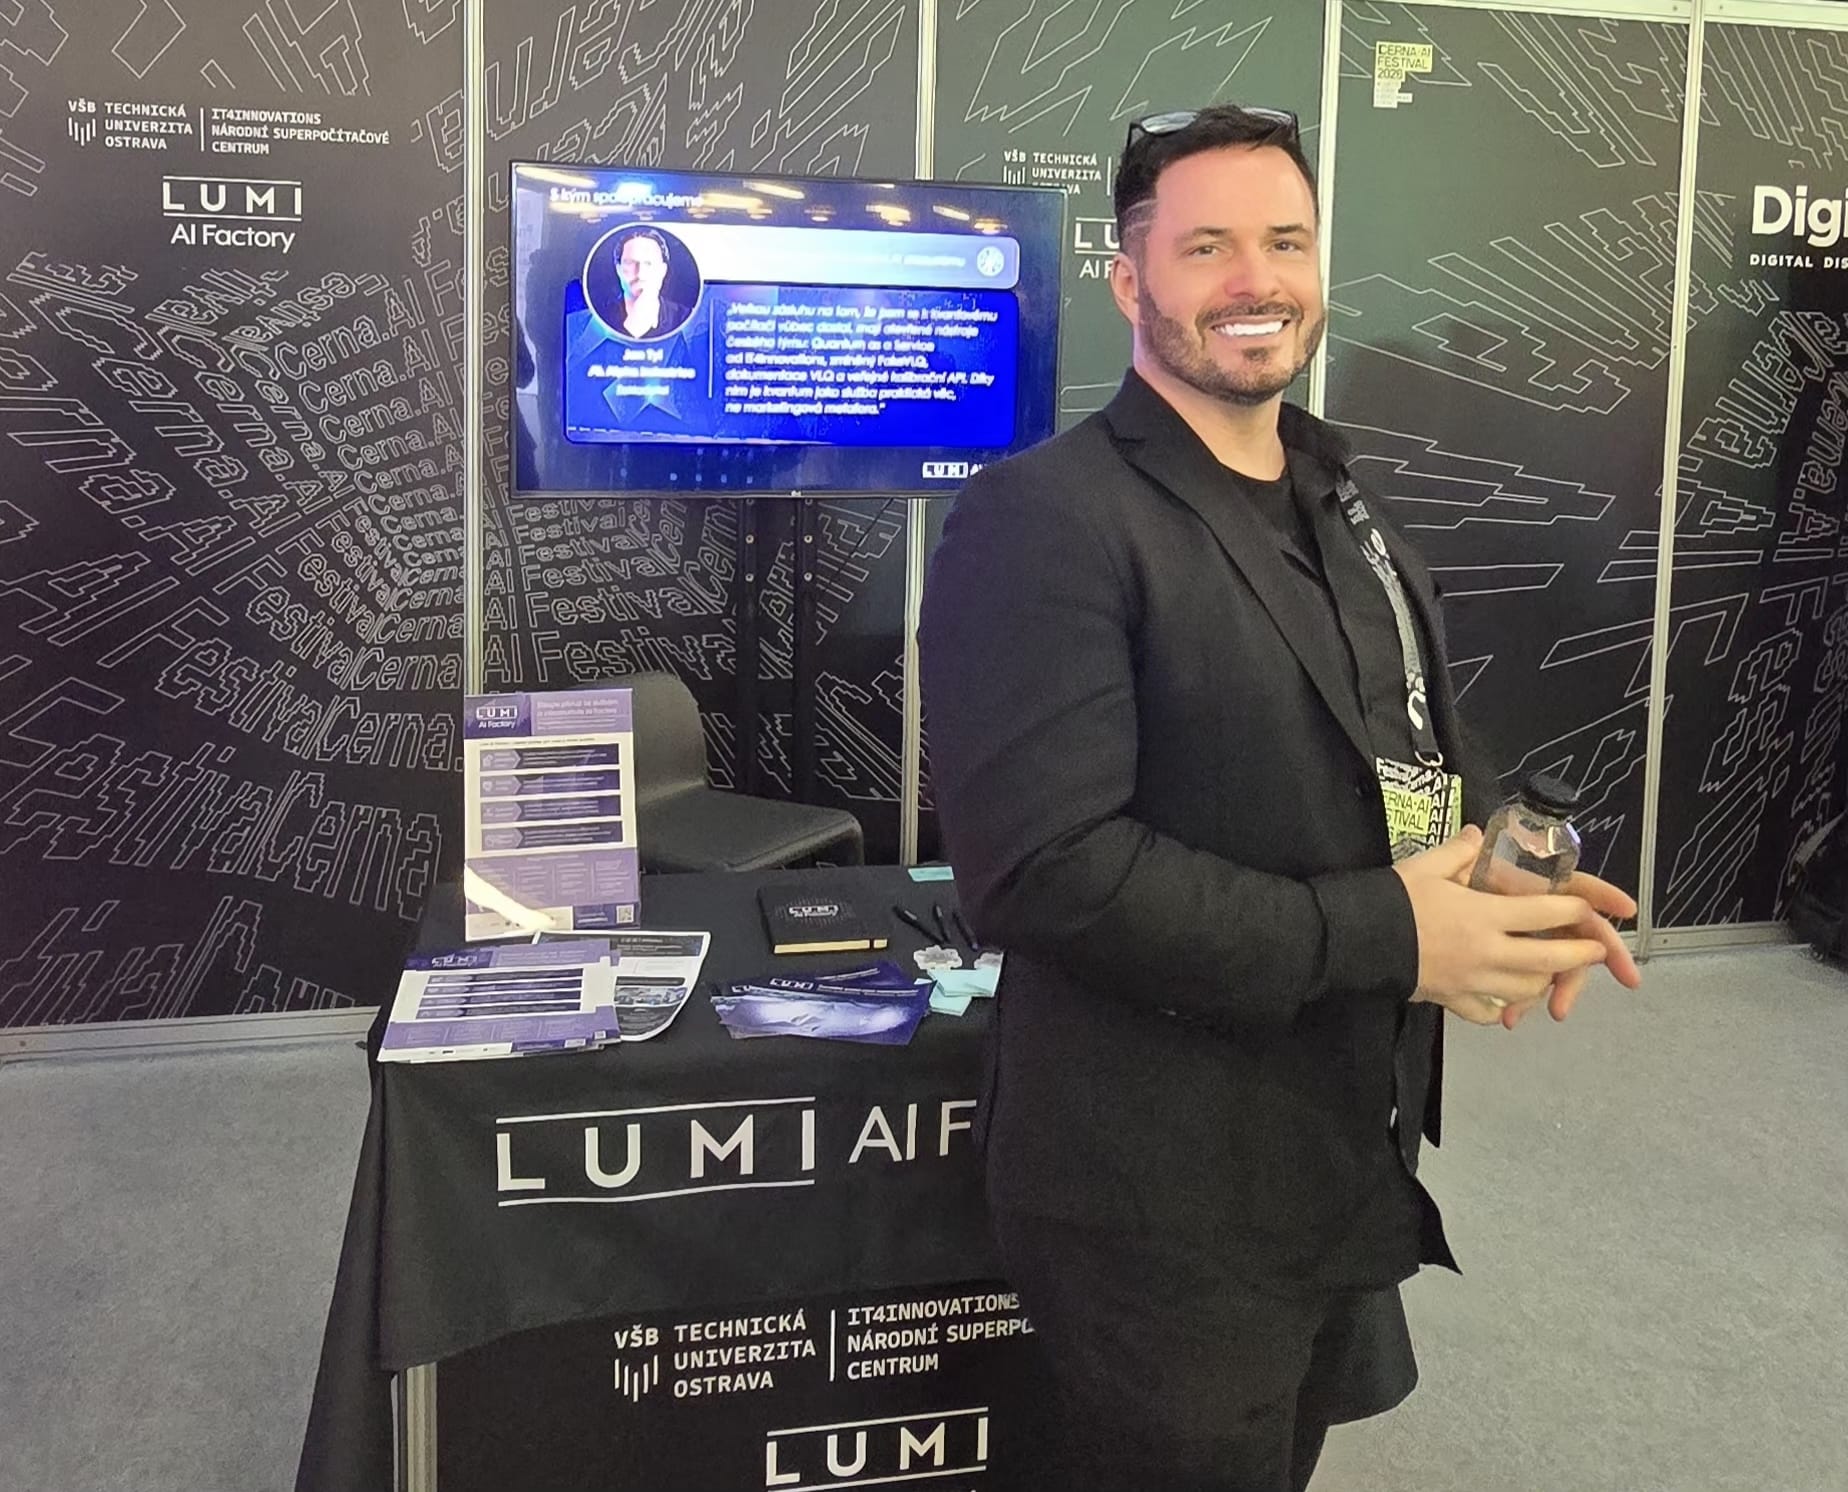
We wrześniu opowiadałem o eksperymentach na CERNA.AI w ostrawskim Gongu, festiwalu, w którym bierze udział ponad dwa tysiące uczestników. Wykład zaowocował artykułem 20 + 5 = 29. Zweryfikowano. i LUMI AI Factory ponownie napisał o wydarzeniu i współpracy. Równolegle rozpocząłem oddzielny projekt kwantowy w czeskim VLQ; jego wyniki nie są częścią eksperymentów opisywanych tutaj na LUMI.
Następny etap badawczy widzę w lepszym wyborze i weryfikacji odpowiedzi. Na początek mam obszerny zestaw ocenionych odpowiedzi. Ale najpierw muszę oddzielić dane do nauki od naprawdę nowego testu, aby weryfikator nie zapamiętał tylko znanych pytań. Chcę udostępnić dane, skrypty i zamrożone zestawy do niezależnej weryfikacji.
Zacząłem też współpracę z Radimem Vavříkiem nad przygotowaniem analizy wydajności POP moich obciążeń AI na LUMI. Dostarczyłem przykład testowy i materiały pomocnicze; sama analiza jeszcze się nie rozpoczęła. Celem jest znalezienie miejsc, w których obliczenia niepotrzebnie się zatrzymują i jak efektywniej wykorzystać sprzęt.
Dla Hyperspace przyjmuję prostą zasadę: zaczynać od dobrego pojedynczego modelu i dodawać bardziej złożoną współpracę tam, gdzie daje mierzalne korzyści. Zatem najciekawszym pytaniem na najbliższe miesiące jest: Jak przekazać użytkownikowi poprawną odpowiedź, którą AI już wygenerowała?
Kolejna alokacja, Aitta i model edukacji
Moje pierwsze doświadczenie z LUMI było bardzo pozytywne. Dlatego rozważam złożenie wniosku o większy przydział czasu obliczeniowego. Naturalnym kolejnym krokiem może być Fast Lane Access, w którym można wnioskować o nawet 50 000 godzin GPU w ciągu maksymalnie trzech miesięcy. To jest plan, a nie przydział, który został już przyznany.
Zdecydowanie chcę wypróbować Aitta, usługę CSC do uruchamiania modeli z otwartymi wagami na LUMI za pośrednictwem interfejsu API kompatybilnego z OpenAI. Przygotowuje model i uzyskuje zasoby z systemu kolejkowania zadań. W przypadku badań i prototypowania mogłoby mi to zaoszczędzić znaczną ilość pracy związanej z infrastrukturą. W dokumentacji wskazano jednak, że dostępność do użytku produkcyjnego nie jest gwarantowana.
Szczególnie warte uwagi wydają się trzy kierunki:
- Weryfikator, który może wskazać właściwą odpowiedź. Chcę sprawdzić na nowych pytaniach, czy mniejszy, dostrojony model może wybrać kandydatów lepiej niż głosowanie i czy jest to opłacalne po uwzględnieniu kosztów własnych weryfikatora.
- Model do edukacji. Chcę zacząć od dotrenowania otwartego modelu, aby zidentyfikować błędy w rozumowaniu ucznia i zaoferować przydatne wskazówki, zamiast po prostu ujawniać odpowiedź. Chcę to porównać z modelem podstawowym i modelem pobierającym materiał pomocniczy. Sama dokładność odpowiedzi nie wystarczy; jakość wsparcia w nauce również ma znaczenie.
- Noetica jako architektura poznawcza. Chcę nawiązać do moich wcześniejszych eksperymentów z Noetica, łącząc pamięć, planowanie, Atlas, współpracę modeli i weryfikację wyników. Zmierzyłbym wkład każdego komponentu, wyłączając go po kolei, utrzymując budżet obliczeniowy na stałym poziomie.
Kierunki te pasują do siebie: zadanie edukacyjne wymaga dobrego wyjaśnienia, weryfikator sprawdza jego poprawność, a architektura decyduje, kiedy wystarczy prosta metoda. Wolałbym wykorzystać większy budżet, aby przetestować tę współpracę przy nowych zadaniach, zamiast po prostu tworzyć kolejną tabelę większych modeli.
Podziękowania i informacje o tym, gdzie rozpocząć własny projekt
Dziękuję EuroHPC JU, LUMI AI Factory, IT4Innovations, CSC (IT Center for Science) i konsorcjum LUMI za obliczenia czasu, wsparcie i obsługę maszyn. Dziękuję także organizatorom CERNA.AI za zaproszenie.
Osobiście dziękuję Jakubowi Siwkowi, który jako pierwszy podszedł do mnie i przedstawił mnie Filipowi Oborníkowi. Następnie zaprosił mnie do swojego podcastu.
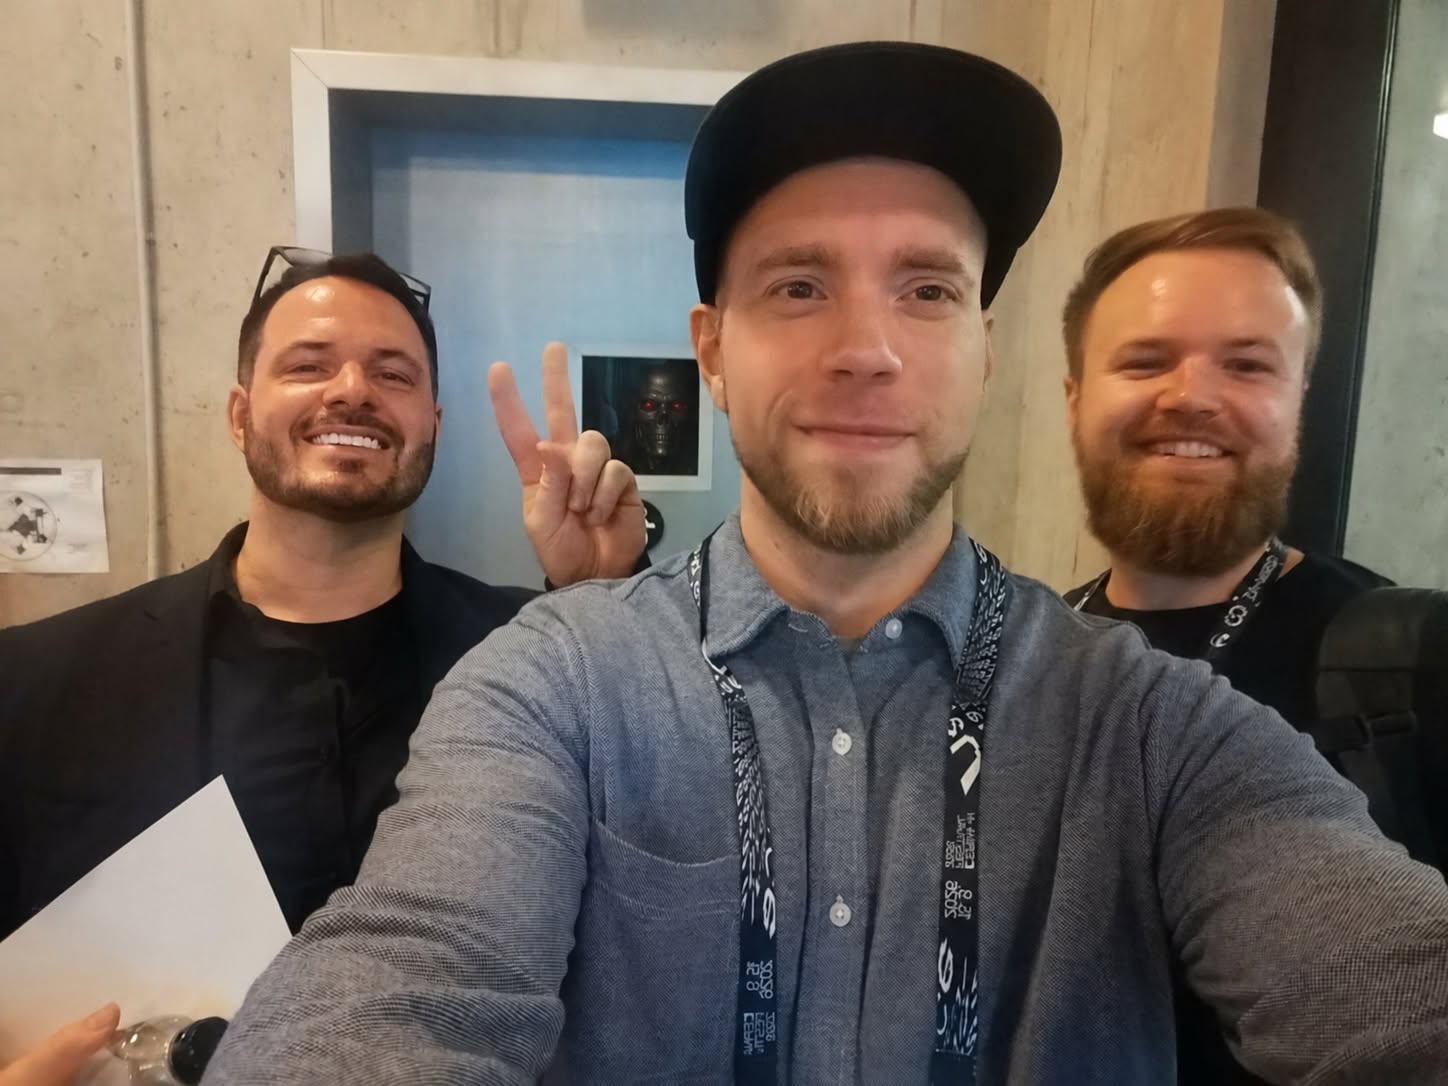
Od lewej Jan Tyl, Jakub Siwek i Filip Oborník.
We acknowledge EuroHPC JU for awarding the project ID EHPC-AIF-2026PG01-843 access to LUMI at CSC, Finland.
Masz własny pomysł? Skontaktuj się z czeskim zespołem LUMI AI Factory w IT4Innovations pod adresem ai-factory@it4i.cz. Sam zaczynałem od mniejszego projektu.
A jeśli chcesz bezpośrednio wypróbować współpracę modeli, wejdź w Hyperspace.
Zbiory danych i materiały do replikacji
Oto źródła piętnastu typów zadań z końcowego porównania. Liczby wskazują unikalne pytania, a nie liczbę odpowiedzi ze wszystkich modeli. Linki prowadzą do źródłowych zbiorów danych; Nie zawsze korzystałem z całej aktualnej wersji.
Zestaw główny: 2544 zadań
| Zbiór danych | Wykorzystana część | Liczba |
|---|---|---|
| GPQA | Diament, wcześniej podzielony na 60 i 138 pytań, ta sama kolejność opcji odpowiedzi | 198 |
| MATH-500 | Pełny test | 500 |
| AIME 2024 i AIME 2025 | Zestawy mrożone, 30 zadań z każdego roku | 60 |
| IFEval | 541 wpisów, w odpowiedzi ścisła ocena wszystkich instrukcji | 541 |
| HotpotQA | Wybór niestandardowy z wariantu dystraktora | 120 |
| LiveCodeBench | Zamrożony wybór LCB-60 z pliku test6 | 60 |
| CERMAT: czeski | Problemy wielokrotnego wyboru | 649 |
| CERMAT: Matematyka | Problemy wielokrotnego wyboru | 126 |
| MMLU w języku czeskim | Pięć pytań na wczytaną dziedzinę, seed 42; zapisany wybór zawiera 290 pozycji | 290 |
Do ścisłego porównania routerów wprowadzono 2537 zadań: siedem wpisów IFEval nie miało wszystkich wymaganych wyników. W tej głównej tabeli wynik HotpotQA jest dokładnym dopasowaniem odpowiedzi; w ramach eksperymentu z długim kontekstem przedstawiam F1. Nie są to wskaźniki zamienne.
Nowe typy problemów: zestaw A8, 1455 pytań
| Zbiór danych | Wykorzystana część | Liczba |
|---|---|---|
| BIG-Bench Hard | 15 elementów z każdej z 27 konfiguracji | 405 |
| MMLU-Pro | Test, 25 pozycji z 14 dziedzin | 350 |
| Belebele | Test, wersja czeska ces_Latn | 200 |
| CzechBench Agree | Test zgodności gramatycznej | 150 |
| DROP | Wybór ze zbioru walidacyjnego | 200 |
| Klokan QA | Test, konfiguracja balanced | 150 |
Skrypt wyboru A8 wykorzystuje ziarno 42. Kolejność ładowania zestawu danych również ma znaczenie, więc samo ziarno nie określa w pełni wyboru.
Pobierz listę zbiorów danych, wybranych identyfikatorów zadań i sum kontrolnych (JSON)
Plik zawiera identyfikatory wszystkich 3999 zadań w obu zestawach oraz skróty SHA-256 zapisanych plików wejściowych. Zawiera także listę ustawień generowania ze skryptu i przykłady wersji wykonawczych z logów. Nie kopiuję zadań ani zawartych w nich poprawnych odpowiedzi; można je uzyskać od autorów zbiorów danych na ich warunkach. Na przykład GPQA wymaga akceptacji warunków dostępu.
W celu dokładnego odtworzenia całego eksperymentu nadal muszę opublikować cały pakiet: prompty, dokładne wersje modelu i zbioru danych, skorygowane limity dla poszczególnych przebiegów, skrypty oceniania i reguły routera ustalone przed oceną. Ta lista stanowi pierwszą konkretną podstawę, a nie twierdzenie, że cały eksperyment można już odtworzyć za pomocą jednego polecenia.
Dotrenowałem ThinkingCap na wybranych przykładach z OpenR1-Math-220k i własnych odpowiedziach oryginalnego modelu na podpowiedzi z Mixture-of-Thoughts. Są to źródła danych treningowych, niezależne od powyższych zestawów ewaluacyjnych.