Drei Monate auf LUMI: KI hat oft die richtige Antwort. Sie kann sie nur nicht auswählen.
Drei Monate und 4.703 GPU-Stunden auf einem finnischen Supercomputer. Wann Zusammenarbeit zwischen Modellen hilft, was das Nachtraining von ThinkingCap brachte und warum die Auswahl der richtigen Antwort oft schwerer ist als ihre Generierung. Mit Ergebnissen, Grafiken und Datensätzen.

Mein Projekt Fusion Playground auf dem finnischen Supercomputer LUMI steht kurz vor dem Abschluss. In drei Monaten habe ich 4.703 der zugeteilten 5.000 GPU-Stunden genutzt, über zwanzig Experimente durchgeführt und über 305.000 bewertete Antworten gesammelt. Ich mache fast die gesamte Forschung und Entwicklung selbst, mit Unterstützung des tschechischen LUMI AI Factory-Teams bei IT4Innovations.
Ich kam im Juli mit einer einfachen Frage an: Wann arbeiten mehrere KI-Modelle besser zusammen als ein starkes Modell? Und wie viel kostet es?
Die interessanteste Erkenntnis betraf etwas anderes als die Modellgröße. Bei schwierigen wissenschaftlichen Fragen war mindestens einer von Gemmas acht Versuchen in 95,5 % der Fälle richtig. Bei der Abstimmung wurde jedoch nur in etwa 86 % der Fälle eine richtige Antwort ausgewählt. Die Lösung war oft schon da. Sie ging auf dem Weg zum Nutzer verloren.
Was ich von LUMI mitnehme
- Es reicht nicht aus, mehr Antworten zu generieren. In diesem Experiment bestand die größte ungenutzte Chance darin, die richtige Antwort auszuwählen.
- Ein leistungsfähiges Modell mit prägnanter Argumentation ist kaum zu übertreffen. Gemma-4-31B erzielte im Hauptqualitätsvergleich 91,3 % und im neuen Set 91,4 %. Die von mir getesteten Modelljurys und Router übertrafen es im Durchschnitt nicht.
- Zusammenarbeit macht Sinn, wenn wir einen guten Grund dafür haben. Tests halfen beim Programmieren, wiederholte Versuche halfen bei einigen Mathe-Aufgaben. Dabei entstand jedoch kein universelles Rezept.
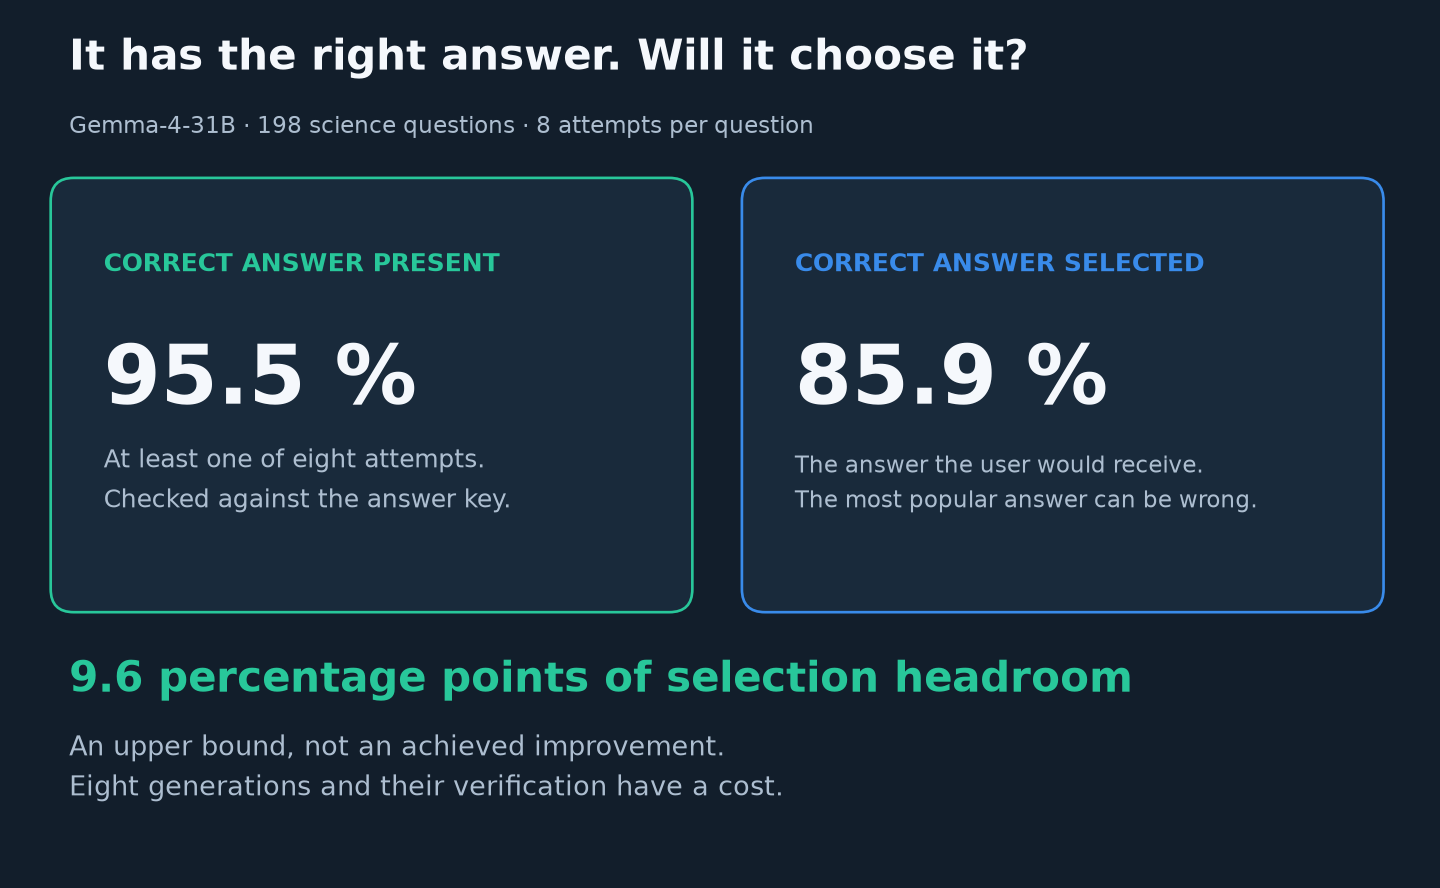
Die gleichen acht Versuche pro Frage, wobei Gemma-4-31B für 198 GPQA-Fragen verwendet wurde. Die linke Zahl lässt sich nur mit den bekannten richtigen Antworten ermitteln. Sie ist nicht die Genauigkeit eines heute einsetzbaren Systems.
Acht Antworten von KI. Wem sollten Sie vertrauen?
Stellen Sie sich ein Meeting vor, in dem jemand die richtige Lösung vorschlägt, die Mehrheit jedoch eine andere bevorzugt. Genau das ist in meinen Experimenten passiert. Mehr Antworten führen nicht automatisch zu besseren Entscheidungen.
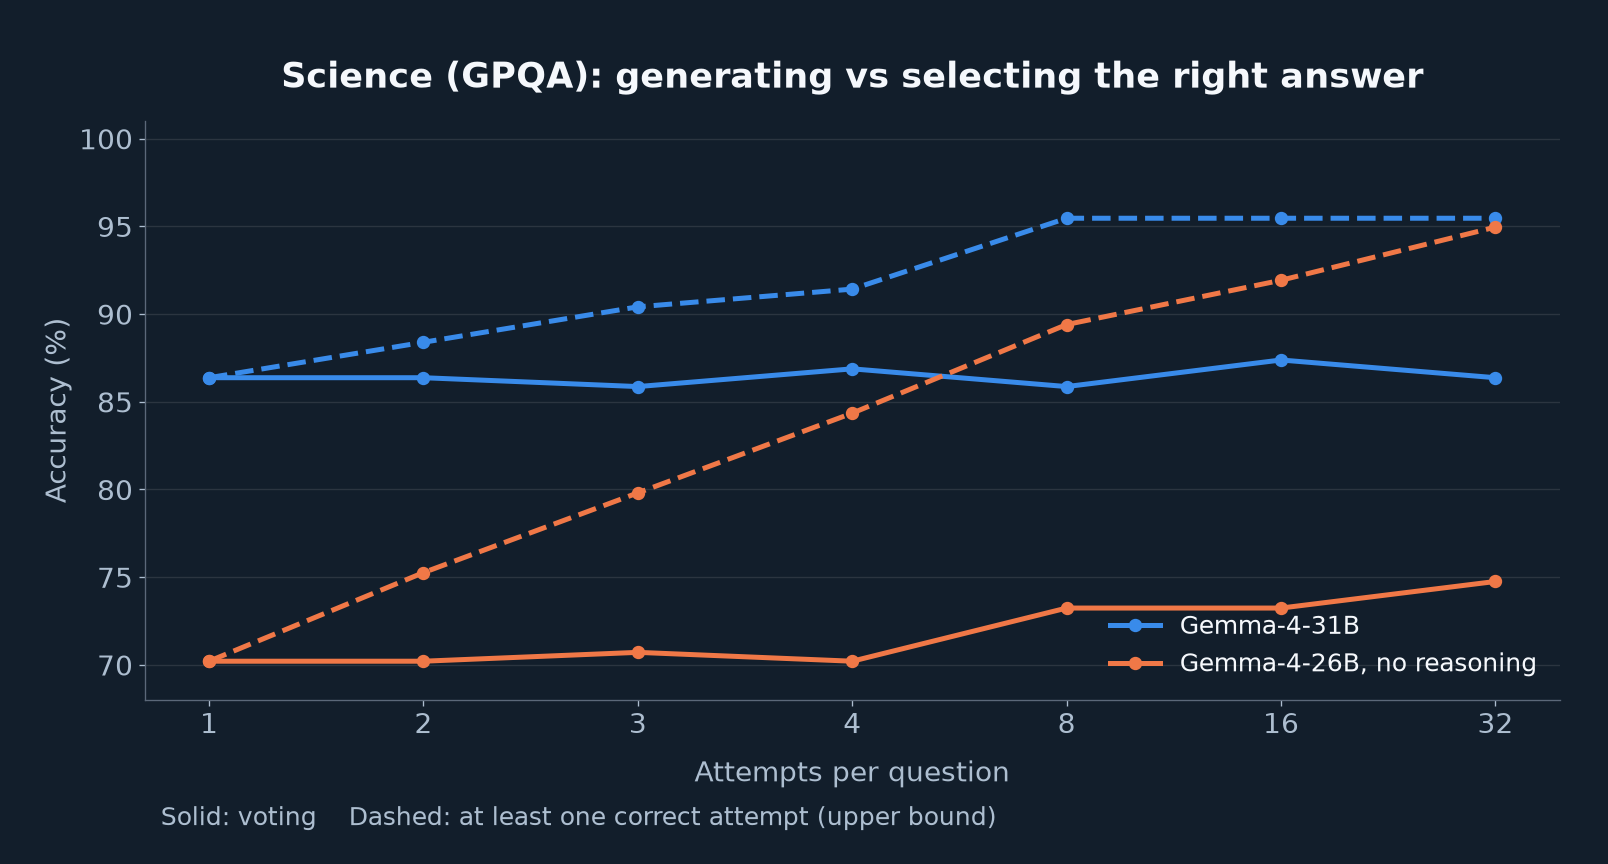
Durchgezogene Linien: tatsächliches Abstimmungsergebnis. Gestrichelte Linien: mindestens eine richtige Antwort unter den Versuchen. Diese Obergrenze nutzt die Kenntnis der Lösung. Selbst 32 Versuche erhöhten die Abstimmungsgenauigkeit von Gemma-4-31B nicht über 86,4 %.
Ich nenne es die Selektorwand. Die zuverlässige Auswahl der richtigen Antwort aus diesen acht Kandidaten könnte ohne ein neues Basismodell fast zehn Prozentpunkte einbringen. Es wäre nicht kostenlos: Sowohl das Generieren der acht Antworten als auch ihre Überprüfung kostet Rechenzeit.
Eine andere KI entscheiden zu lassen, ist ein naheliegender nächster Schritt. In einem separaten IFEval-Experiment zur Anweisungsbefolgung waren die von mir getesteten Richter jedoch in 20 bis 25 % der Fälle mit regelbasierten Überprüfungen nicht einverstanden. Bei erneuter Befragung änderten sie in 9 bis 25 % der Fälle ihr Urteil zur gleichen Antwort. Dies schließt KI-Richter nicht aus. Das bedeutet, dass diese besonderen Richter und Einstellungen einer Validierung bedürfen. Es kann auch nicht davon ausgegangen werden, dass die Zahlen auf wissenschaftliche GPQA-Fragen zutreffen.
Am besten funktionierten Prüfungen auf fester Basis: Tests des Programms ausführen, Ergebnis neu berechnen, Formatierungsregeln überprüfen. Ein Modell, das sagt: „Das sieht richtig aus“, ist eine andere Art von Beweis.
Was bedeutet eigentlich Modellkollaboration?
In Hyperspace entwickle ich HyperFusion, ein System zur Zusammenarbeit zwischen Modellen, und Atlas, das je nach Aufgabenstellung das passende Verfahren auswählt. Um die Ergebnisse lesen zu können, ist es hilfreich, vier Dinge zu unterscheiden:
| Vorgehensweise | Was passiert |
|---|---|
| Abstimmung | Das Modell antwortet wiederholt, oder mehrere Modelle stimmen ab. Die häufigste Antwort gewinnt. |
| Auswahl | Aus den vorhandenen Antworten wird eine ausgewählt, beispielsweise anhand von Testergebnissen. |
| Kaskade | Ein günstigeres Modell antwortet zuerst. Wenn seine Antwort nicht ausreichend verifiziert werden kann oder eine Prüfung nicht besteht, übernimmt ein stärkeres Modell. |
| Synthese | Ein anderes Modell kombiniert die Kandidaten zu einer neuen Antwort. |
Die Ergebnisse eines Verfahrens sind nicht automatisch die Ergebnisse der anderen. Im abschließenden Experiment habe ich echte Antwortsynthese bei der Befolgung von Anweisungen und bei Fragen zu Dokumenten gemessen. Andere Aufgaben waren hauptsächlich Abstimmung, Auswahl oder Kaskade. Für den Code wurden öffentliche Tests zur Auswahl und separate versteckte Tests zur abschließenden Bewertung verwendet.
Hyperspace funktioniert auch mit großen gehosteten Modellen, die unterschiedliche Preise und Funktionen haben. Daher ziehe ich aus den Messungen offener Modelle auf LUMI kein allgemeingültiges Urteil über die Produktionsfusion.
Ein starkes Modell ist kaum zu schlagen
Der abschließende Vergleich umfasste elf Modellkonfigurationen und fünfzehn Aufgabentypen. Dazu gehörten neben naturwissenschaftlichen Fragen und Mathematik auch Programmieren, Textverarbeitung, Befolgung von Anweisungen und tschechische Abiturprüfungen. In der Hauptmatrix gab es normalerweise vier bis acht Versuche pro Aufgabe; Bei einigen Folgetests wurden mehr Wiederholungen durchgeführt.
Ein Router wählt ein Modell oder eine Methode basierend auf der Aufgabe aus. Ich habe die ursprünglichen Regeln und erlernten Routing-Richtlinien mit einer einfachen Strategie verglichen: Immer das gleiche Modell verwenden.
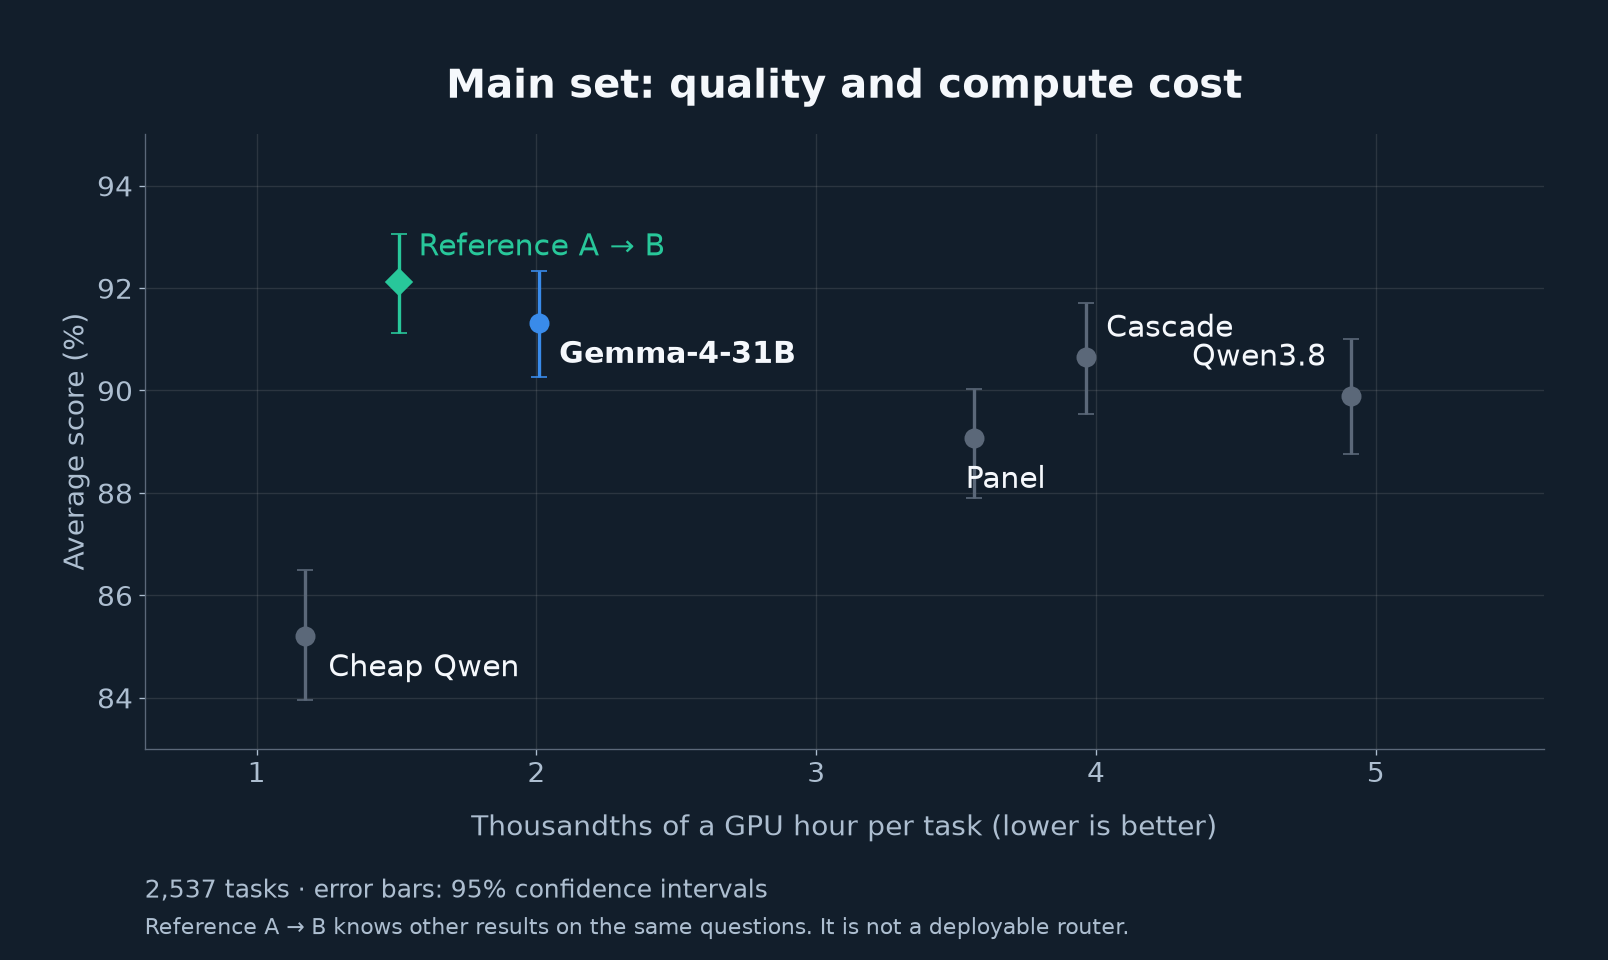
Oben links ist besser. Die Referenzauswahl A → B kennt die Ergebnisse anderer Versuche zu denselben Fragen und ist daher kein einsetzbarer Router. Eine optimistische Auswahl allein aufgrund der ausgewerteten Ergebnisse wird hier nicht dargestellt.
| Vorgehensweise | Hauptdatensatz | Neue Aufgabentypen | Kosten Hauptsatz / neue Aufgaben* |
|---|---|---|---|
| Qwen3.6-35B-A3B ohne Reasoning | 85,2 % | 88,7 % | 1,17 / 0,71 |
| Qwen3.8-27B mit Reasoning | 89,9 % | 89,9 % | 4,91 / 3,44 |
| Gemma-4-31B mit Reasoning | 91,3 % | 91,4 % | 2,01 / 1,62 |
| Panel aus drei Modellen | 89,1 % | 88,5 % | 3,56 / 1,30 |
| Kaskade | 90,7 % | 90,1 % | 3,96 / 1,96 |
| Gelernte Router | 90,2 bis 91,3 % | 90,3 bis 91,4 % | entsprechend der Einstellung |
| Referenzauswahl A → B | 92,1 % | 92,8 % | 1,51 / 0,96 |
Tausendstel einer GPU-Stunde pro Aufgabe. Hierbei handelt es sich um eine durchschnittliche Punktzahl für eine bestimmte Aufgabenmischung, nicht um eine universelle Rangfolge der Modelle. Eine GPU-Stunde bedeutet hier eine Arbeitsstunde für ein AMD MI250X-Modul.
Gemma kombinierte starke Leistung mit prägnanter Argumentation. Im Hauptdatensatz verbrauchte der günstigere Qwen etwa 1/1,7 der GPU-Zeit, lag aber sechs Punkte zurück. Der Router hatte somit wenig Spielraum für Fehler. Bei einem anderen Modellpaar und unterschiedlichen Preisen kann die Situation deutlich günstiger sein.
Wie viel Vertrauen sollten wir in die Zahlen setzen?
Der Hauptdatensatz enthielt 2.544 Einzelaufgaben, von denen 2.537 mit allen erforderlichen Antworten in den strengen Vergleich gingen. Das neue Set fügte 1.455 Probleme von sechs zusätzlichen Typen hinzu. Die Regeln des Routers standen fest, bevor ich die Ergebnisse des neuen Datensatzes ausgewertet habe. Bei der Richtlinienauswahl und -bewertung wurden auch separate Wiederholungen verwendet, und das Training der beteiligten Router wurde ebenfalls nach eindeutigen Fragen aufgeteilt.
Nicht jeder Zehntelpunkt ist eine Verbesserung. Beispielsweise hat 91,3 % für Gemma in der Hauptanalyse ein 95 %-Konfidenzintervall von etwa 90,3 bis 92,3 %. Daher beschreibe ich kleine Unterschiede als beobachtete Ergebnisse und nicht als nachgewiesene Überlegenheit. Auch wiederholte Antworten auf die gleiche Frage sind keine eigenständigen neuen Fragen.
Spätere Experimente mit anderen Rezepten und Prüfern verwendeten Daten wieder, deren Ergebnisse bereits überprüft worden waren. Sie sind nützlich, um die nächste Richtung zu finden, erfordern aber einen weiteren separaten Test. Dies gilt insbesondere für Einsparungen mit JEV weiter unten.
Wann haben sich mehrere Versuche wirklich gelohnt?
| Situation | Was hat funktioniert | Beobachtetes Ergebnis |
|---|---|---|
| Programmieren mit Tests | Billiges Modell, Überprüfung, dann bei Bedarf ein stärkeres Modell | Vergleichbare Qualität in etwa der Hälfte der GPU-Zeit: 85,2 % für 3,0 vs. 84,8 % für 5,6 Tausendstel einer GPU-Stunde |
| Programmieren mit Fokus auf Qualität | Das starke Modell mehrfach antworten lassen und die Lösungen testen | Ungefähr +1,4 bis +1,9 Punkte bei einem 17 bis 40 % höheren Preis |
| Wettbewerbsmathematik | Abstimmung mehrerer Versuche oder eine geeignete Modelljury | In einem Vergleich +3,4 Punkte für den 2,2-fachen Preis |
| Fachwissenschaftliche Fragen | Verschiedene Modelle oder Kaskade | Etwa +1,3 bis +2,0 Punkte, für das Zwei- bis Sechsfache der Kosten |
| Suche und Berechnung aus Text | Günstiges Modell ohne langes Reasoning | Ähnliche oder bessere Qualität, drei- bis siebenmal günstiger |
In der Mathematik war ich überrascht, wie wichtig das Fehlermuster war. Die kleinere Gemma mit deaktiviertem Reasoning verbesserte sich bei wiederholten Versuchen erheblich. Die stärkere Gemma-4-31B verbesserte sich kaum. Abstimmung hilft, wenn sich die Versuche in sinnvoller Weise unterscheiden. Die Wiederholung desselben Fehlers führt nicht dazu, dass er bei einer Mehrheitsabstimmung verschwindet.
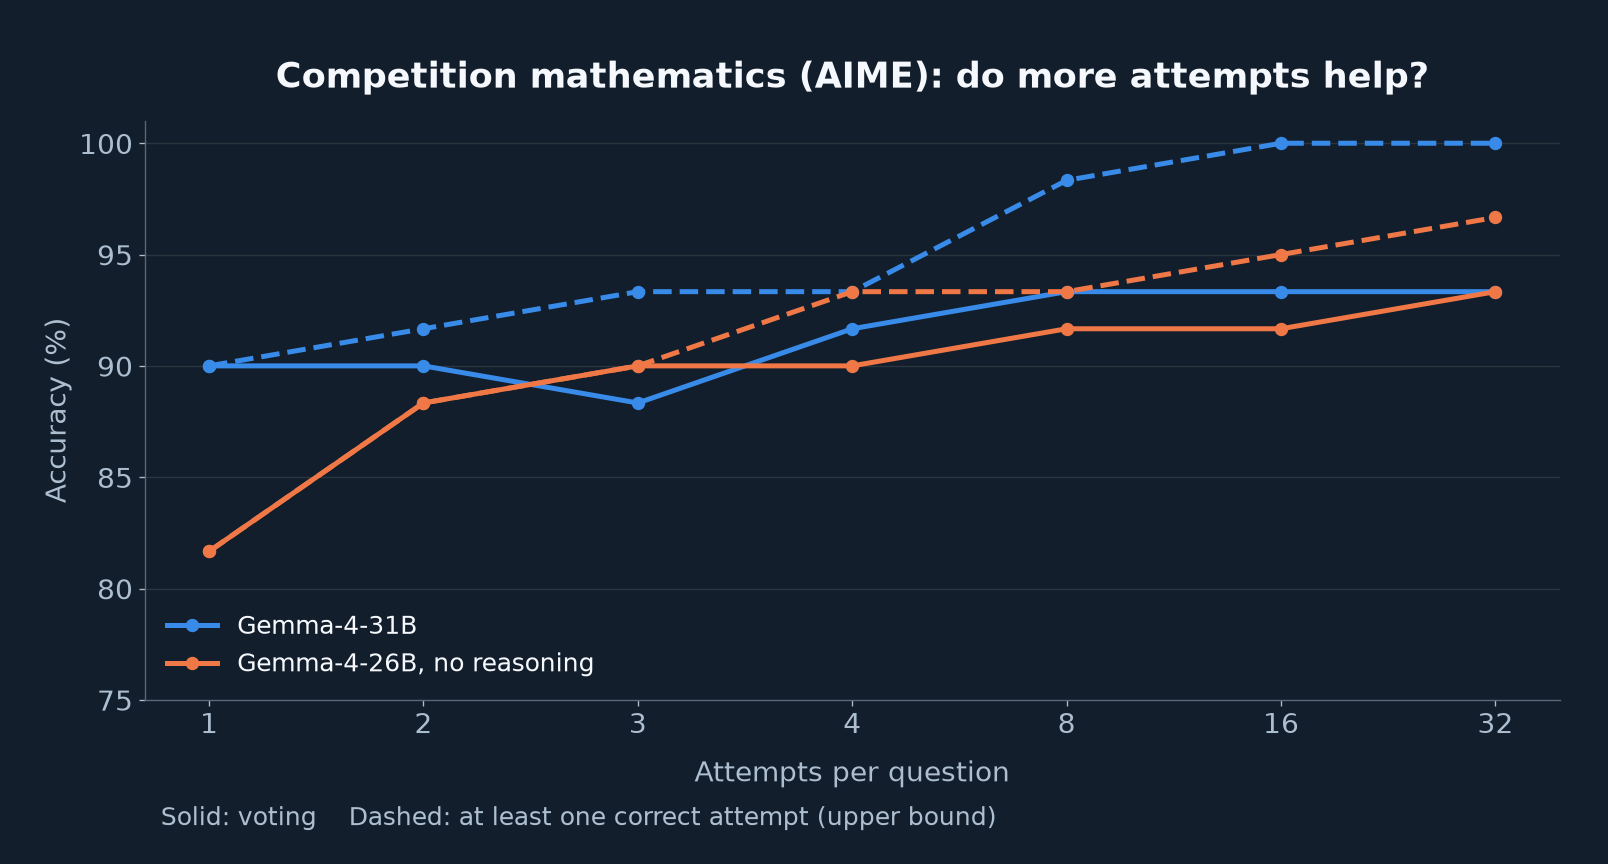
AIME enthält 60 Wettbewerbsprobleme. Eine durchgezogene Linie bedeutet eine Abstimmung, eine gestrichelte Linie bedeutet mindestens einen richtigen Versuch. Die geringe Anzahl der Fragen ist ein weiterer Grund, geringfügige Unterschiede nicht zu überschätzen.
ThinkingCap: Bessere Mathematik in 30 GPU-Stunden
Eines der ermutigendsten Ergebnisse kam aus der Feinabstimmung von ThinkingCap-Qwen3.6-27B von BottleCap AI, dem Unternehmen von Tomáš Mikolov. Das Modell zielt bereits darauf ab, seine Argumentation prägnant zu halten. Ich wollte sehen, ob ich es noch weiter vorantreiben kann.
Für die in der Grafik gezeigte Variante habe ich 1.400 Mathematikbeispiele und 469 Antworten aus Naturwissenschaften und Programmierung verwendet, die vom Originalmodell generiert wurden. Für einfachere Mathematik habe ich kurze richtige Lösungen gewählt, für schwierigere Beispiele längere. Die Antworten des Ausgangsmodells sollten helfen, andere Fähigkeiten zu erhalten. Eine solche Trainingssitzung dauerte ungefähr 30 GPU-Stunden. Die gesamte Versuchsreihe samt Auswertung kostete mehr.
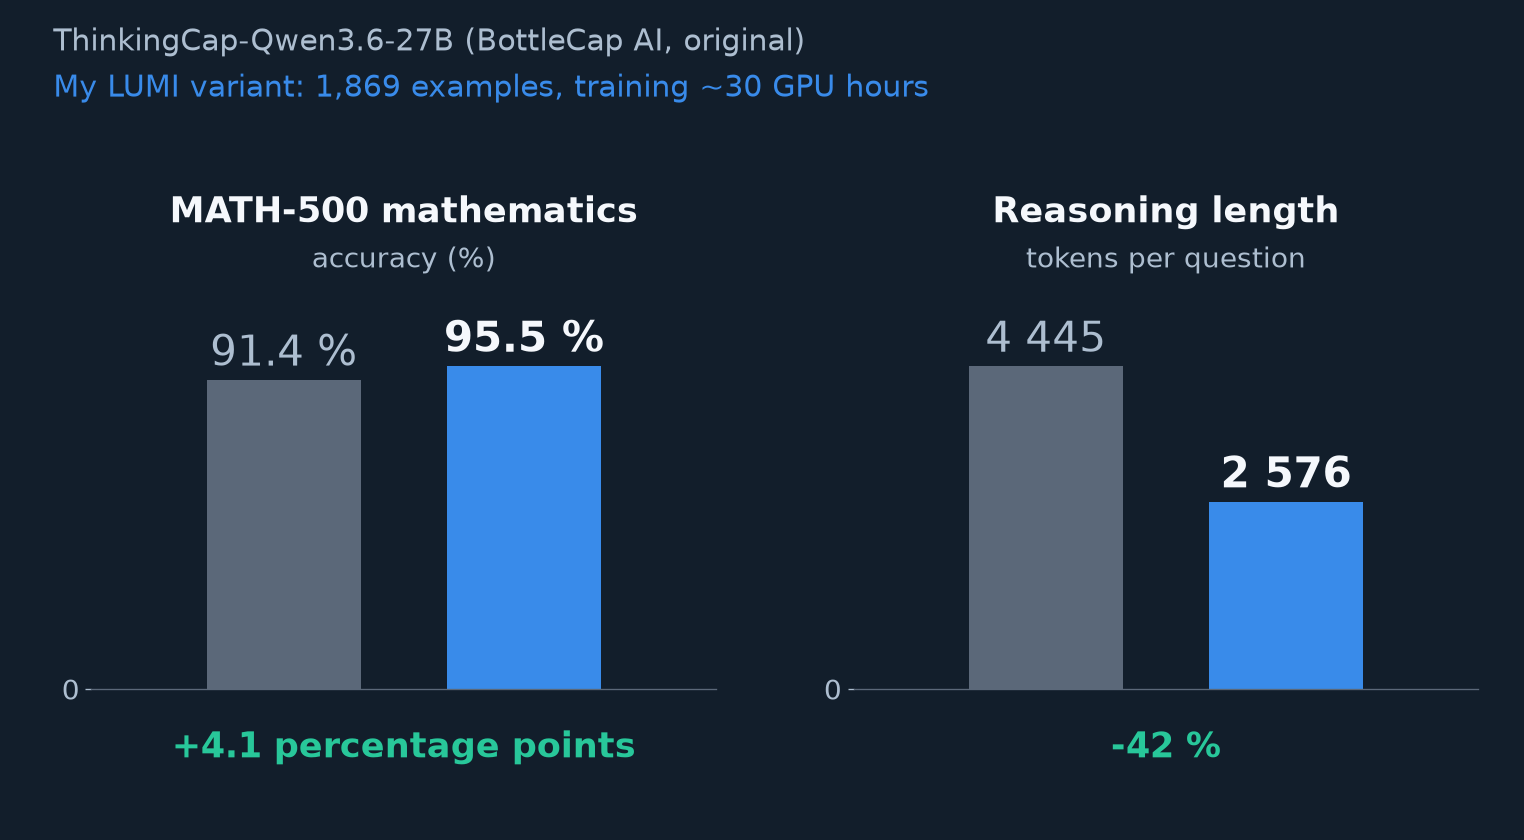
MATH-500: 500 Fragen, jeweils dreimal, also 1500 Versuche pro Variante. Die gleiche verfeinerte Variante gewann 4,1 Prozentpunkte und verkürzte die Argumentation um 42 %.
Genauer und gleichzeitig prägnanter als das ursprüngliche ThinkingCap. Für diesen Mathematikdatensatz ist dies ein sehr schönes Ergebnis für ein kleines Trainingsbudget.
Aber das hat seinen Preis: Dieselbe Variante verlor 3,3 Punkte bei den AIME-Wettbewerbsmathematikfragen und 5,6 Punkte bei den GPQA-Wissenschaftsfragen. Eine andere der fünf Trainingsvarianten verlor bei den Wissenschaftsfragen weniger Punkte, war jedoch ein anderes Modell. Ihre besten Zahlen können nicht zu einem Gewinner zusammengefasst werden. Ich habe eine bestimmte mathematische Fähigkeit verbessert, ThinkingCap jedoch nicht in allen Bereichen geschlagen.
Vor dem Training habe ich sowohl exakte als auch ähnliche Textüberschneidungen mit den Tests MATH-500, AIME und GPQA überprüft; die verwendete Prüfung fand keine. Es ist keine vollständige Garantie dafür, dass ähnliche Aufgaben im ursprünglichen Vortraining nicht aufgetreten sind. Und es ist eine Version, die auf Qwen3.6 basiert: BottleCap hat inzwischen ein neueres ThinkingCap-Qwen3.8 veröffentlicht, an dem ich dieses Ergebnis nicht messe.
Ein besserer Prüfer statt eines größeren Modells?
Atlas verwendet das schnelle Spezialmodell JEV von TypeSafe, um Eingabeeigenschaften abzuschätzen. Ich habe es auch versucht, um bereits generierte Antworten zu überprüfen. In diesen Folgeversuchen schnitt es besser ab als die alleinige Schätzung der Schwierigkeit der Frage.
| Ein Signal für die Entscheidung, wann ein günstiges Modell ausreicht | AUC | Qualität bei etwa der Hälfte der GPU-Zeit von Gemma |
|---|---|---|
| Ursprüngliche JEV-Fragen zu Aufgabeneigenschaften | 0,77 | 88,8 % |
| Neue JEV-Fragen zum Schwierigkeitsgrad | 0,79 | 89,3 % |
| Texteigenschaften ohne JEV | 0,61 | 88,3 % |
| Antwortprüfung mit Gemma-4-31B | 0,77 | 89,4 % |
| Überprüfung der Antwort mit Qwen3.6 | 0,82 | 88,8 % |
| Antwort mit JEV prüfen | 0,84 | 89,8 % |
AUC beschreibt, wie gut das Signal Fälle nach Fehlerrisiko einordnet. Ein Wert von 0,5 entspricht einer zufälligen Reihenfolge, 1 einer perfekten. Ein AUC von 0,84 bedeutet nicht, dass die Antworten 84 % korrekt sind.
In dieser Einstellung kostet die Einsparung von ca. 30 % der GPU-Zeit einen halben Prozentpunkt an Qualität. Die Einsparung der Hälfte der GPU-Zeit kostet etwa anderthalb Punkte. Dabei handelt es sich um ausgewählte Punkte aus einer Messkurve bereits genutzter Daten, nicht um eine vorgefertigte Garantie für Neukundenanfragen. API-Aufrufe an JEV kosten zusätzlich 0,00005 $ pro Aufgabe; diese Dollarkosten sind in den GPU-Stundenzahlen nicht enthalten.
JEV ist immer noch ein Modell, das Fehler machen kann. Es handelt sich nicht um das Äquivalent eines ausführbaren Tests. Ich habe auch die anderen Verifizierer in einer bestimmten sparsamen Konfiguration ausprobiert, nicht in allen möglichen Formen. Dennoch ist es ein erfolgsversprechenderer Leitfaden für die weitere Arbeit als ein bloßer Eindruck von der Schwierigkeit der Aufgabe.
Eine neue Generation kann mehr bedeuten als Milliarden zusätzlicher Parameter
Sogar die Modelle selbst änderten sich innerhalb von drei Monaten. Verglichen mit dem gleich großen Qwen3.6-27B gewann Qwen3.8-27B in diesen Tests etwa 13 Prozentpunkte in der Wettbewerbsmathematik und 18 in der Programmierung. Gleichzeitig verbrauchte es für diese Aufgaben etwa die Hälfte der GPU-Zeit.
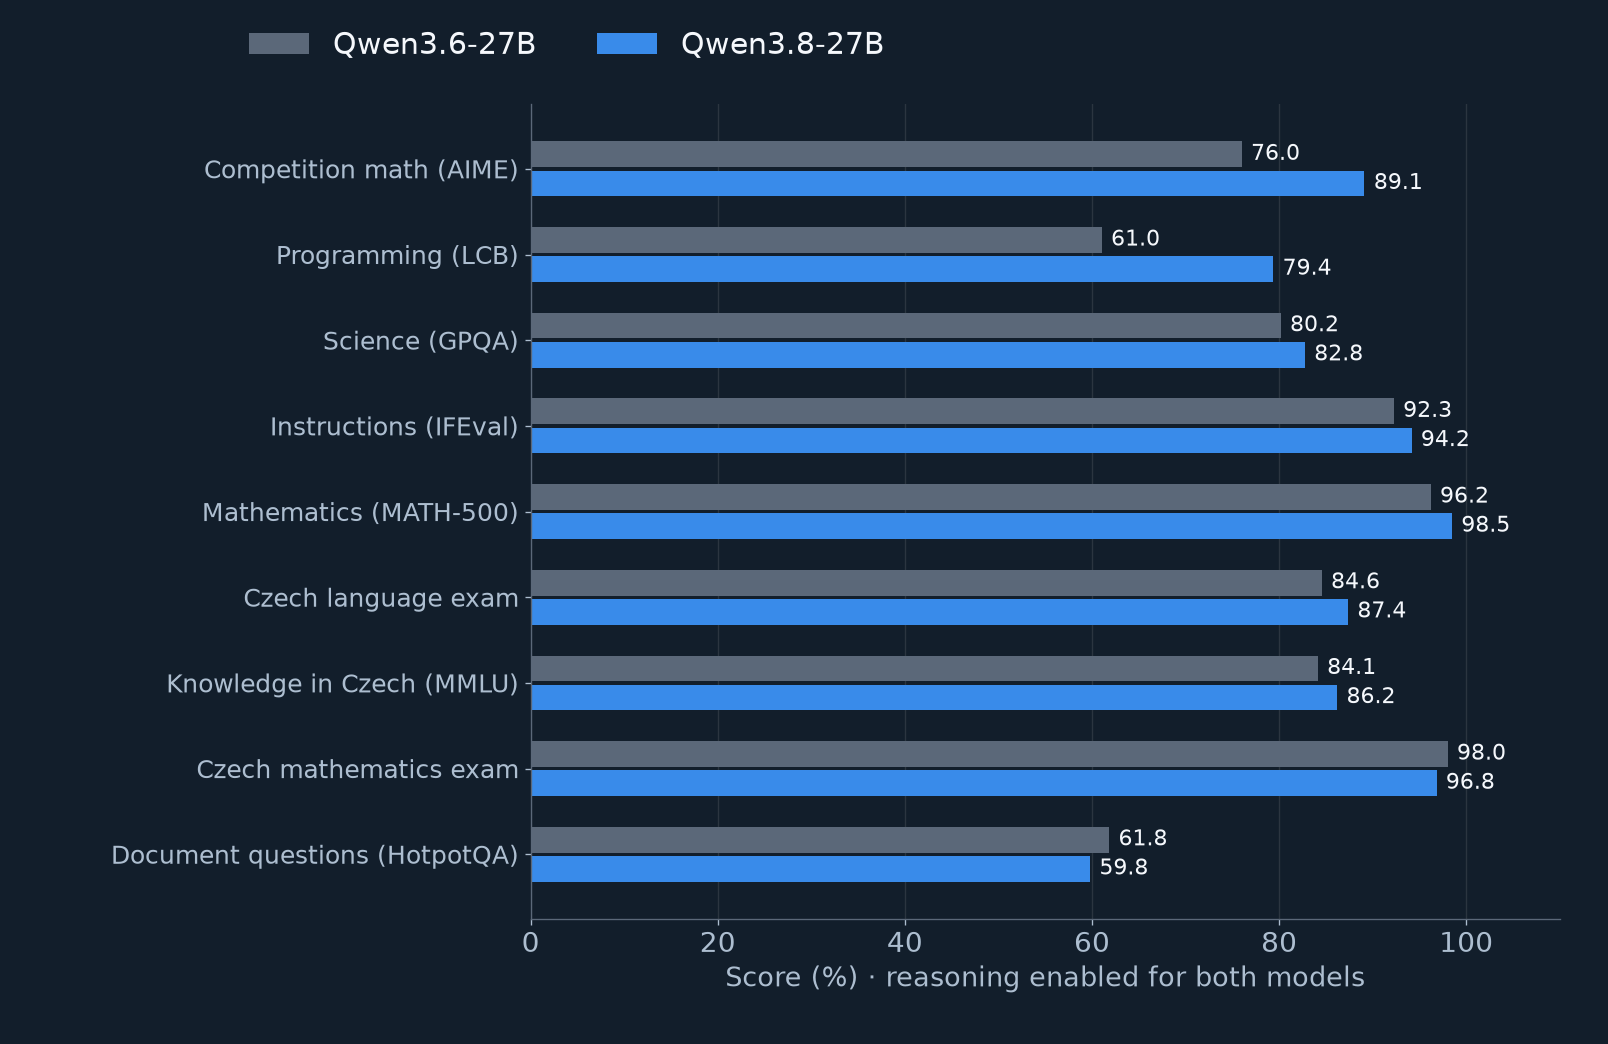
Reasoning wurde für beide Modelle aktiviert. Die Verbesserung war nicht universell: Bei einigen Aufgaben mit Text und tschechischer Mathematik verlor das neuere Modell leicht. Es ist sinnvoll, die Modelle kontinuierlich an den eigenen Aufgaben zu messen.
Die gegenteilige Überraschung kam von MiMo-V2.6-Pro mit rund einer Billion Parametern, dem größten Modell im abschließenden Vergleich. Es passt in komprimierter Form mit durchschnittlich 3,5 Bit pro Parameter auf einen Knoten.
| MiMo-V2.6-Pro, 3,5 Bit | Gemma-4-31B | |
|---|---|---|
| Wissenschaftliche Fragen GPQA | 78,3 % | 85,9 % |
| Abiturprüfung in tschechischer Sprache | 92,2 % | 91,0 % |
| GPU-Stunden pro GPQA-Frage | ca. 0,52 | ungefähr 0,005 |
MiMo schnitt bei der Tschechisch-Sprachprüfung gut ab, war aber bei der GPQA deutlich teurer und weniger genau. Ein Fünftel der schwierigen Fragen erreichte die maximale Antwortlänge. Die MXFP4-Variante mit höherer Präzision erzielte bei den 64 von beiden Varianten beantworteten Fragen 4,7 Punkte mehr, ohne abgeschnittene Antworten. Das ist ein interessanter Hinweis, aber auch eine kleine, ausgewählte Stichprobe.
Der Grund kann in der Komprimierung, der Qualität einer bestimmten Version des Modells, der Art und Weise, wie es gestartet wird, und den festgelegten Grenzen liegen. MiMo lief über llama.cpp, Gemma über vLLM. Darüber hinaus nutzt MiMo die MoE-Architektur, die nur einen Teil der Parameter für jeden Token aktiviert. Dies ist kein reines „eine Billion gegen 31 Milliarden“-Experiment und kann nicht dazu herangezogen werden, das Modell als solches zu verurteilen.
Ich interpretiere die früheren Vergleiche der kostenpflichtigen APIs mit der gleichen Vorsicht:
| Ein kleiner Vergleichstest | Über API | Bei LUMI |
|---|---|---|
| GPQA, 138 Fragen | Gemini 3.1 Pro 93,5 %, Claude Sonnet 5 86,2 % | Gemma-4-31B 84,1 % |
| GLM-5.2, bewertete offene Aufgabe | 60 von 60 Punkten | 4-Bit-Version: 35 von 60 Punkten |
| Kimi K3, 40 Programmieraufgaben | 31 richtig | 2-Bit-Version: 28 richtig |
Die letzte Zeile bedeutet etwa 90 % des relativen Ergebnisses in diesem Test und behält nicht 90 % aller Fähigkeiten von Kimi bei. Die Unterschiede zwischen der API und der lokalen Version allein isolieren auch nicht den Effekt der Quantisierung, d. h. der Komprimierung der numerischen Gewichte des Modells. Das mag gut funktionieren, aber jede einzelne Datei und Ausführungsmethode muss überprüft werden.
Zwei Erkenntnisse, die nicht fehlen sollten
Lange Dokumente testen eine andere Fähigkeit als der kurze Benchmark. Im Dokumentfragetest habe ich ablenkenden Text hinzugefügt und den Kontext von etwa 8.000 auf 120.000 Token erweitert. Die getesteten Qwen-Modelle verloren etwa 2-5 Punkte im F1-Score, gpt-oss etwa 18. Dies ist kein Urteil für alle langen Dokumente, aber es zeigt gut, warum die Größe des Kontextfensters als Qualitätsmaßstab nicht ausreicht.
Wer entscheidet? In einem früheren Versuch einer Zusammenfassung ging die Synthese in 92,7 % der Vergleiche als Sieger hervor, wenn sie mit demselben Modell bewertet wurde, das sie erstellt hatte. Beim unabhängigen Gutachter Llama waren es 57,3 %. Der Bewerter hat sich geändert, daher handelt es sich nicht um eine genaue Messung einer einzelnen Ursache. Aber der Unterschied reicht als Warnung davor aus, dass das Modell sich selbst ein Zeugnis ausstellt.
Wie dies mit anderen Forschungsergebnissen zusammenhängt
Meine Experimente sind nicht die ersten Arbeiten zur Zusammenarbeit von Modellen. Sie helfen mir, allgemeine Vorstellungen in spezifische Kosten und Einschränkungen bei LUMI umzusetzen:
- Self-Consistency zeigt den Vorteil mehrerer Lösungs- und Abstimmungswege. Meine Ergebnisse erinnern mich daran, dass es auch davon abhängt, wie ähnlich die Fehler der Versuche sind.
- Mixture-of-Agents untersucht die Synthese mehrerer Modellantworten. Dies ist ein anderer Prozess als die Abstimmung selbst.
- RouteLLM löst die Modellwahl nach dem Verhältnis von Qualität und Preis. Das Ergebnis eines solchen Routers hängt immer auch davon ab, zwischen welchen Modellen er auswählt.
- Let’s Verify Step by Step untersucht das Training von Modellen zur Überprüfung einzelner Lösungsschritte. Meine Daten werten normalerweise nur die endgültige Antwort aus, daher wäre es für einen ähnlichen Ansatz notwendig, eine andere Art von Anmerkungen hinzuzufügen.
- Quantization Inflates Reasoning beschreibt, dass Komprimierung das Denken verlängern kann. Es ist eine mögliche Erklärung für einen Teil meiner Beobachtungen, kein Beweis für die Ursache in einem bestimmten MiMo-Lauf.
Was ich über den Supercomputer selbst gelernt habe
Während der letzten Experimente wurden bis zu 140 Scheduler-Jobs gleichzeitig ausgeführt. Jeder bearbeitete viele Anfragen. Durch diese Parallelität passten etwa 2.900 GPU-Stunden in einen Tag und eine Nacht. Das bedeutet nicht, dass ein Benutzer so lange auf eine Antwort gewartet hat.
Die Arbeitsteilung machte einen großen Unterschied. Ein LUMI-Knoten verfügt über vier MI250X-Module, insgesamt acht Compute Dies (GCDs). Bei einem Modell, das in den Speicher von zwei Chips passt, könnte ich vier separate Kopien statt einer Kopie über acht Chips laufen lassen.
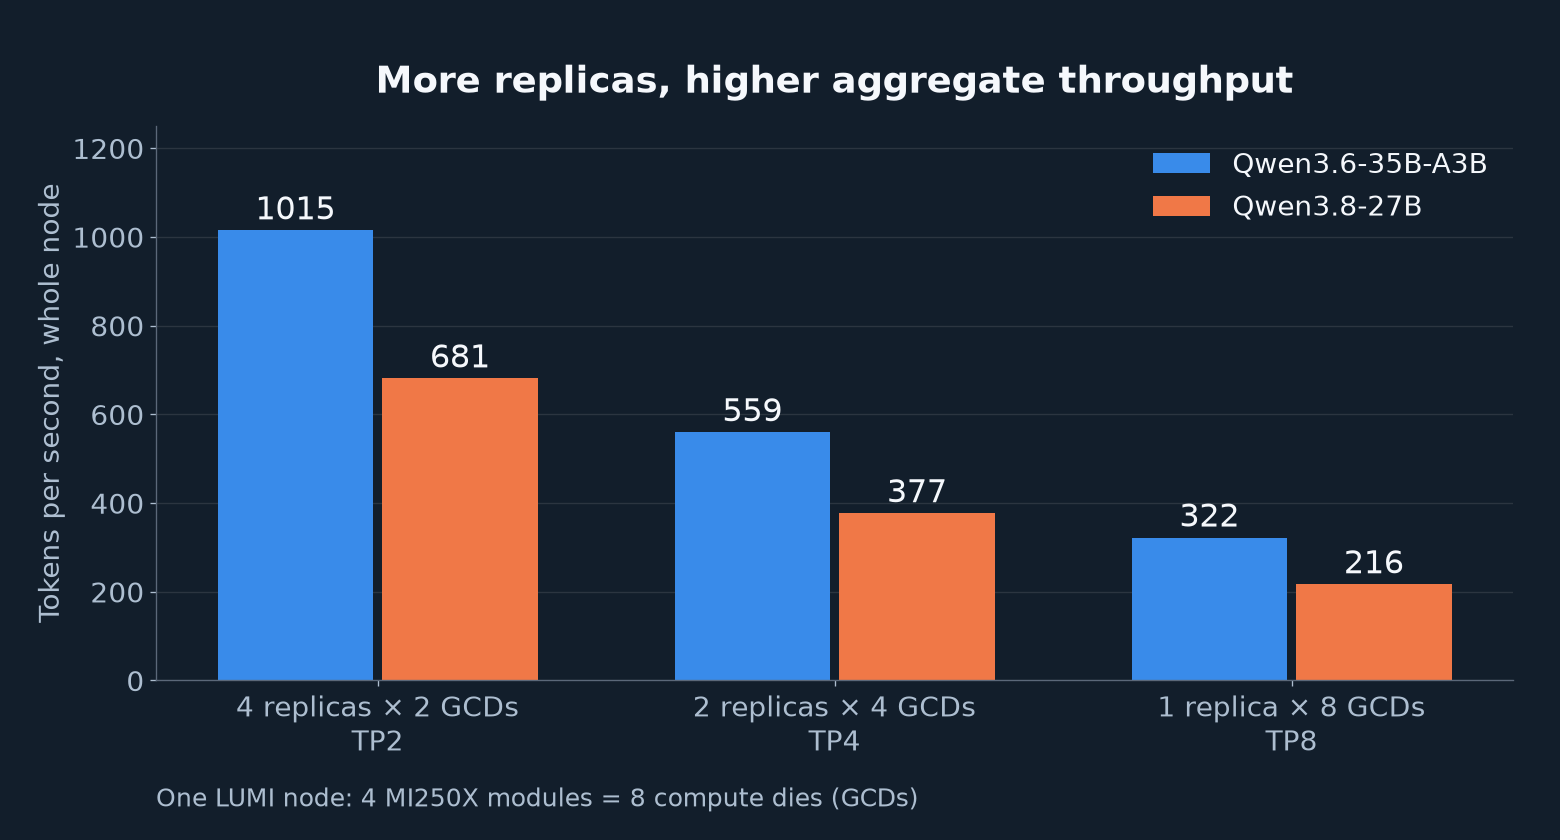
Qwen3.6-35B-A3B: etwa 1015 vs. 322 Token pro Sekunde. Ich messe den Gesamtdurchsatz eines Knotens über viele Abfragen hinweg, nicht die Geschwindigkeit einer einzelnen Antwort. Kleinere Kopien helfen, wenn das Modell in den Speicher passt und genug zum Arbeiten vorhanden ist.
Ich habe auch kontinuierlich die elektrische Leistungsaufnahme der GPUs gemessen. Diesen Messungen zufolge verbrauchten die abschließenden Experimente 562 kWh für Beschleuniger. Es umfasst nicht den gesamten Server, das Netzwerk oder die Kühlung.
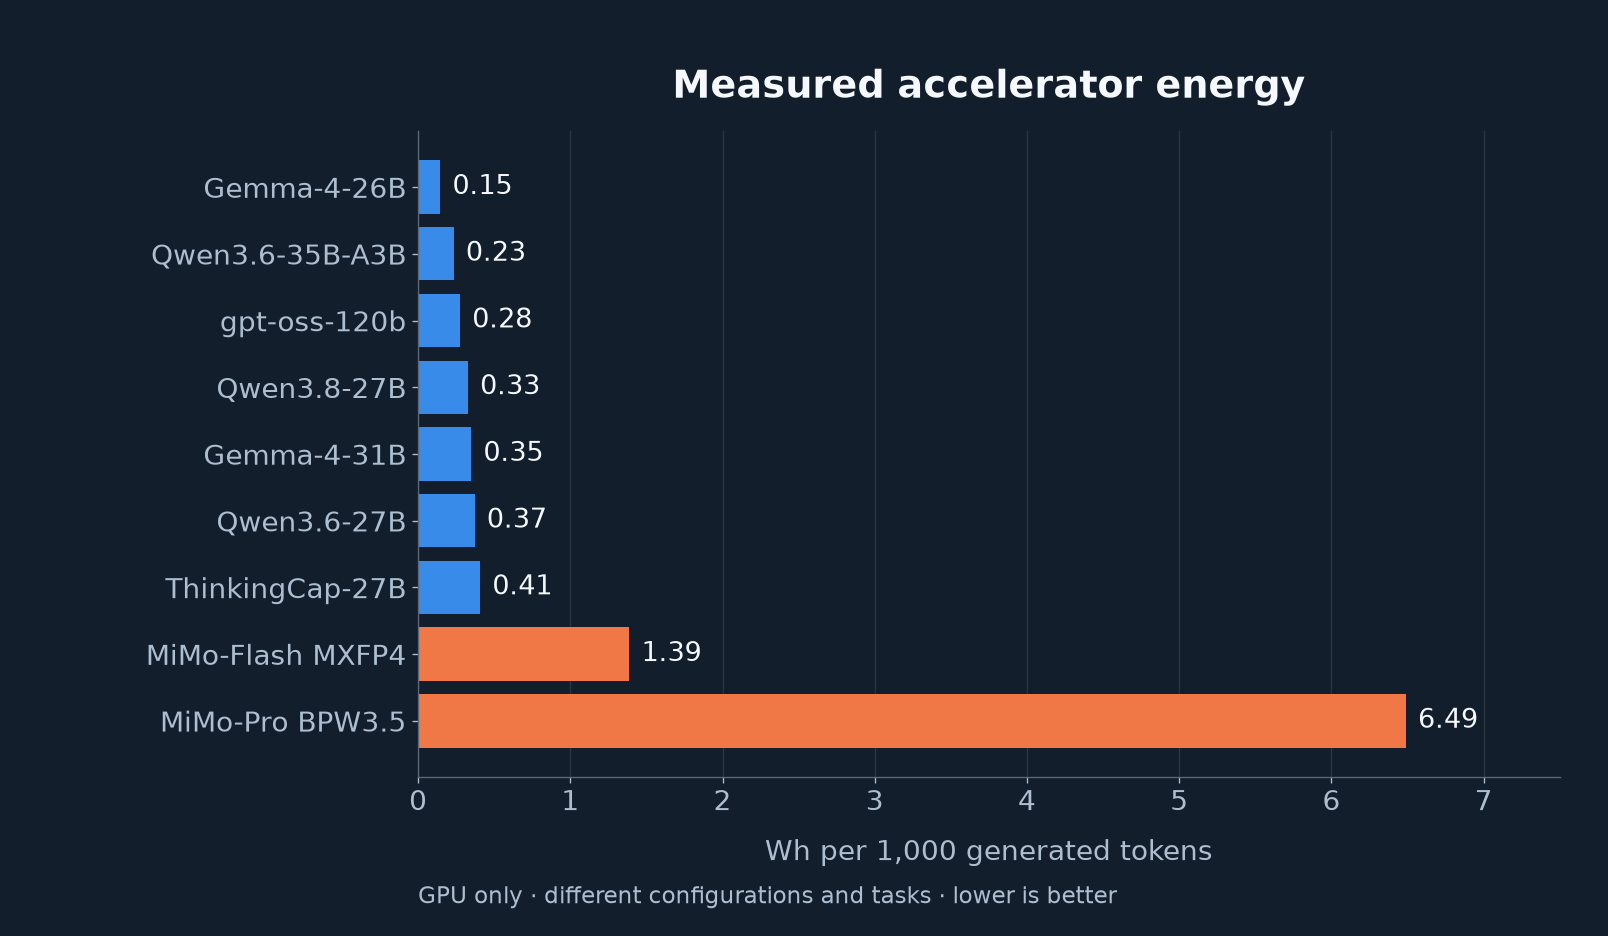
Energie pro Token hilft beim Vergleich der Effizienz der Inferenz. Aber für eine echte Anwendung ist die Energie für eine richtig gelöste Aufgabe wichtiger. Eine kürzere Antwort kann insgesamt auch bei einem teureren Token wirtschaftlicher sein.
Was ist schief gelaufen und wie viel hat es gekostet?
Manche Ergebnisse kosteten unnötig viel Rechenzeit. Zweimal habe ich die Denkgrenze zu kurz gesetzt. Die Neugenerierung abgeschnittener Antworten verbrauchte 777 GPU-Stunden, etwa ein Sechstel des Budgets. Ich habe auch gelernt, Zwischenergebnissen nicht zu vertrauen: Einfachere Fragen werden zuerst beendet, wodurch die ersten Ergebnisse besser aussehen.
In der ersten Analyse habe ich auch Panels aus einem Versuch mit einzelnen Modellen verglichen, die über mehrere Versuche gemittelt wurden. Ich habe die Methodik korrigiert; in der obigen Haupttabelle werden bereits separate Wiederholungen und vergleichbare Bewertungen verwendet.
Für den Programmieragenten auf SWE-bench stieg die Erfolgsquote von 42 auf 61 %, aber der Verdienst lag an besseren Werkzeugen und Arbeitsmanagement und nicht am Nachtraining. Selbst ein negatives Ergebnis erspart eine weitere Sackgasse.
| Posten | Ergebnis |
|---|---|
| Verbrauchte Zuteilung | 4.703 von 5.000 GPU-Stunden, Reserve 297 |
| Letzte Experimente | ca. 2.900 GPU-Stunden |
| Energie des Finales | 562 kWh, nur GPU |
| Bewertete Ausgaben | 305.051 Antworten und weitere 5.314 Programmlösungen |
| Kostenpflichtige API | ca. 42 $, davon ca. 0,85 $ für JEV insgesamt |
305.000 Antworten sind nicht 305.000 verschiedene Fragen. Die Zahl umfasst verschiedene Modelle und Wiederholungen. Bei den aufgeführten GPU-Stunden handelt es sich um den Verbrauch der zugeteilten Rechenzeit, nicht um die Rechnung, die ich in bar bezahlt habe.
Drei Monate, auf denen ich aufbauen möchte
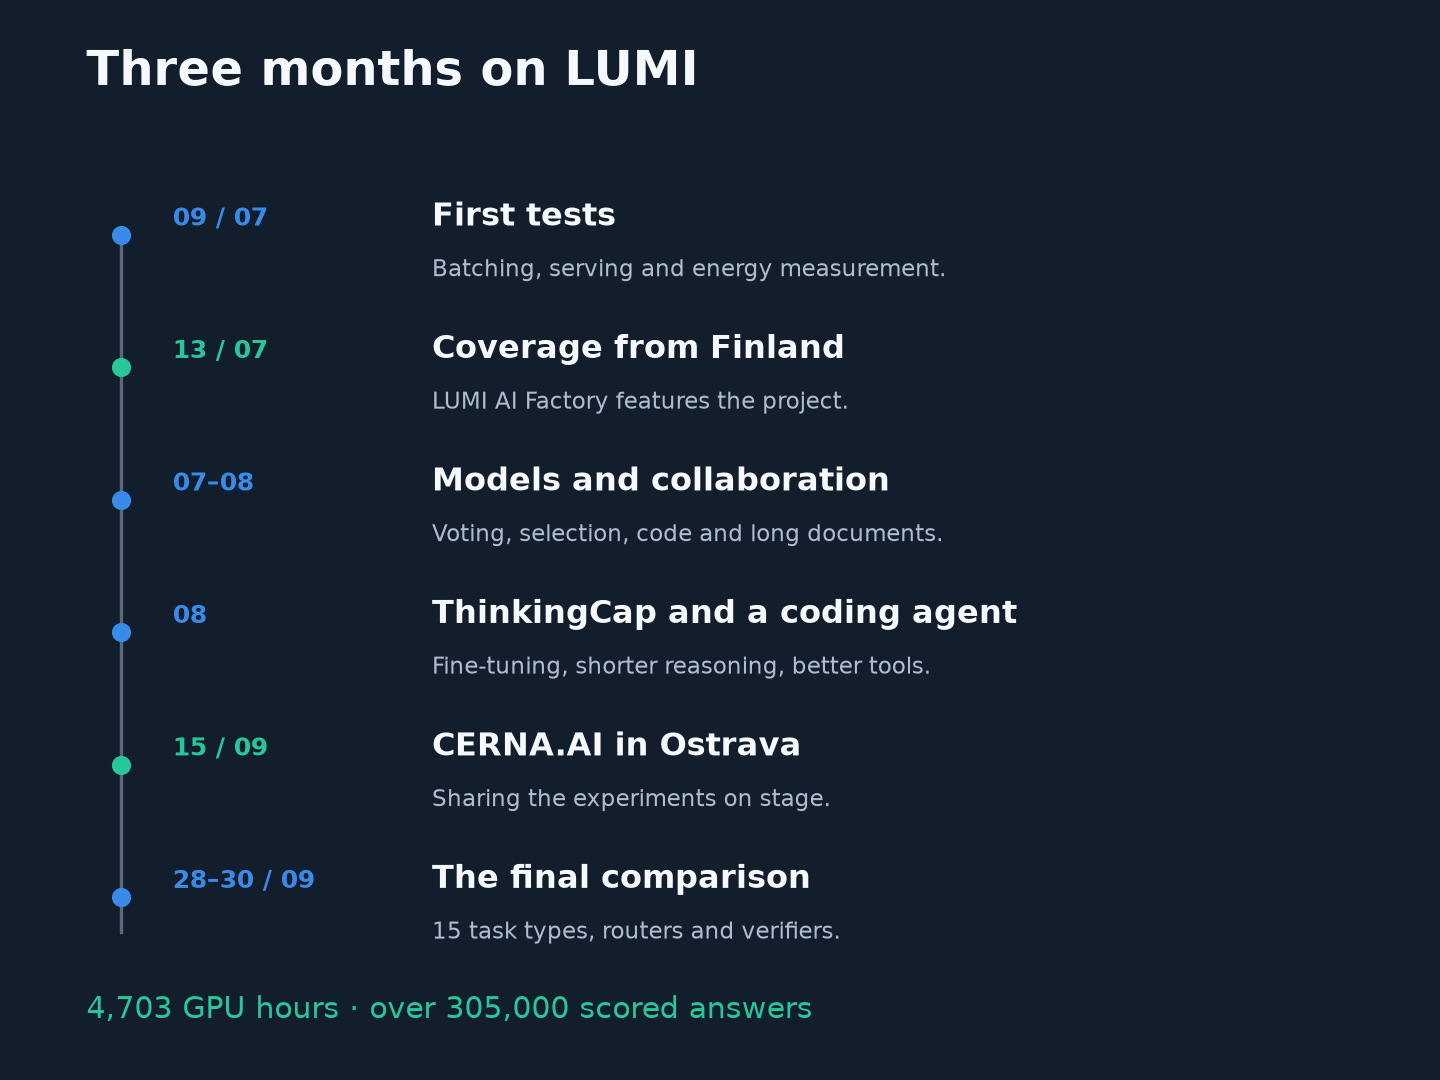
Die ersten Erfahrungen habe ich in den Artikeln über LUMI und die Wärmeversorgung von Kajaani und über erste Fusionen und GLM-5.2 beschrieben. Im Juli schrieb auch LUMI AI Factory über das Projekt.
Im September sprach ich über Experimente bei CERNA.AI im Ostravaer Gong, einem Festival mit mehr als zweitausend Teilnehmern. Der Vortrag führte zu einem Artikel 20 + 5 = 29. Verifiziert. und LUMI AI Factory hat erneut über die Veranstaltung und die Zusammenarbeit geschrieben. Parallel dazu habe ich am tschechischen VLQ ein separates Quantenprojekt gestartet; seine Ergebnisse sind nicht Teil der hier auf LUMI berichteten Experimente.
Den nächsten Forschungsschritt sehe ich in einer besseren Antwortauswahl und -überprüfung. Ich habe zunächst einen umfangreichen Satz bewerteter Ausgaben. Aber zuerst muss ich die Daten für das Lernen und den wirklich neuen Test trennen, damit sich der Prüfer nicht nur an bekannte Fragen erinnert. Ich möchte die Daten, Skripte und eingefrorenen Sätze zur unabhängigen Überprüfung freigeben.
Ich habe auch begonnen, mit Radim Vavřík zusammenzuarbeiten, um eine POP-Leistungsanalyse meiner KI-Workloads auf LUMI vorzubereiten. Ich habe den Testfall und unterstützendes Material bereitgestellt; die Analyse selbst muss noch beginnen. Ziel ist es herauszufinden, wo die Berechnung unnötig ins Stocken gerät und wie die Hardware effektiver genutzt werden kann.
Für Hyperspace übernehme ich eine einfache Arbeitsregel: Ich beginne mit einem guten Einzelmodell und ergänze komplexere Zusammenarbeit dort, wo ich einen tatsächlichen Nutzen messe. Die interessanteste Frage für die nächsten Monate lautet also: Wie können wir dem Benutzer die richtige Antwort geben, wenn die KI sie bereits generiert hat?
Eine weitere Zuteilung, Aitta und ein Modell für die Bildung
Meine ersten Erfahrungen mit LUMI waren sehr positiv. Daher überlege ich, eine größere Zuteilung von Rechenzeit für ein Folgeprojekt zu beantragen. Ein natürlicher nächster Schritt könnte Fast Lane Access sein, bei dem Anträge auf bis zu 50.000 GPU-Stunden für höchstens drei Monate möglich sind. Hierbei handelt es sich um einen Plan, nicht um eine bereits vergebene Zuteilung.
Ich möchte unbedingt Aitta ausprobieren, den CSC-Dienst zum Ausführen von Open-Weight-Modellen auf LUMI über eine OpenAI-kompatible API. Der Dienst übernimmt die Modelleinrichtung und fordert Ressourcen vom Scheduler an. Für Forschung und Prototypenbau könnte es mir erhebliche Infrastrukturarbeiten ersparen. In der Dokumentation wird jedoch darauf hingewiesen, dass die Verfügbarkeit für den Produktionseinsatz nicht garantiert ist.
Drei Richtungen sehen besonders lohnenswert aus:
- Ein Verifizierer, der die richtige Antwort identifizieren kann. Ich möchte anhand neuer Fragen testen, ob ein kleineres, fein abgestimmtes Modell Kandidaten besser auswählen kann als eine Abstimmung, und ob es sich unter Berücksichtigung der eigenen Kosten des Verifizierers lohnt.
- Ein Modell für die Bildung. Ich möchte mit dem Nachtraining eines offenen Modells beginnen, um Fehler in der Argumentation eines Schülers zu erkennen und nützliche Hinweise zu geben, anstatt einfach nur die Antwort preiszugeben. Ich möchte es mit dem Basismodell und einem Modell vergleichen, das unterstützendes Material abruft. Antwortgenauigkeit allein reicht nicht aus; auch die Qualität der Lernunterstützung ist wichtig.
- Noetica als kognitive Architektur. Ich möchte auf meinen früheren Noetica-Experimenten aufbauen und Gedächtnis, Planung, Atlas, Modellzusammenarbeit und Ergebnisüberprüfung verbinden. Ich würde den Beitrag jeder Komponente messen, indem ich sie nacheinander deaktiviere und gleichzeitig das Rechenbudget konstant halte.
Diese Richtungen passen zusammen: Eine pädagogische Aufgabe braucht eine gute Erklärung, ein Verifizierer prüft ihre Richtigkeit und die Architektur entscheidet, wann eine einfache Methode ausreicht. Ich würde ein größeres Budget verwenden, um diese Zusammenarbeit bei neuen Aufgaben zu testen, anstatt einfach eine weitere Tabelle mit größeren Modellen zu erstellen.
Danksagungen und wo Sie Ihr eigenes Projekt starten können
Ich danke EuroHPC JU, LUMI AI Factory, IT4Innovations, CSC (IT Center for Science) und dem LUMI-Konsortium für Rechenzeit, Support und Maschinenbetrieb. Vielen Dank auch an die Organisatoren CERNA.AI für die Einladung.
Ich persönlich danke Jakub Siwek, der als erster auf mich zukam und mir Filip Oborník vorstellte. Anschließend lud er mich zu seinem Podcast ein.
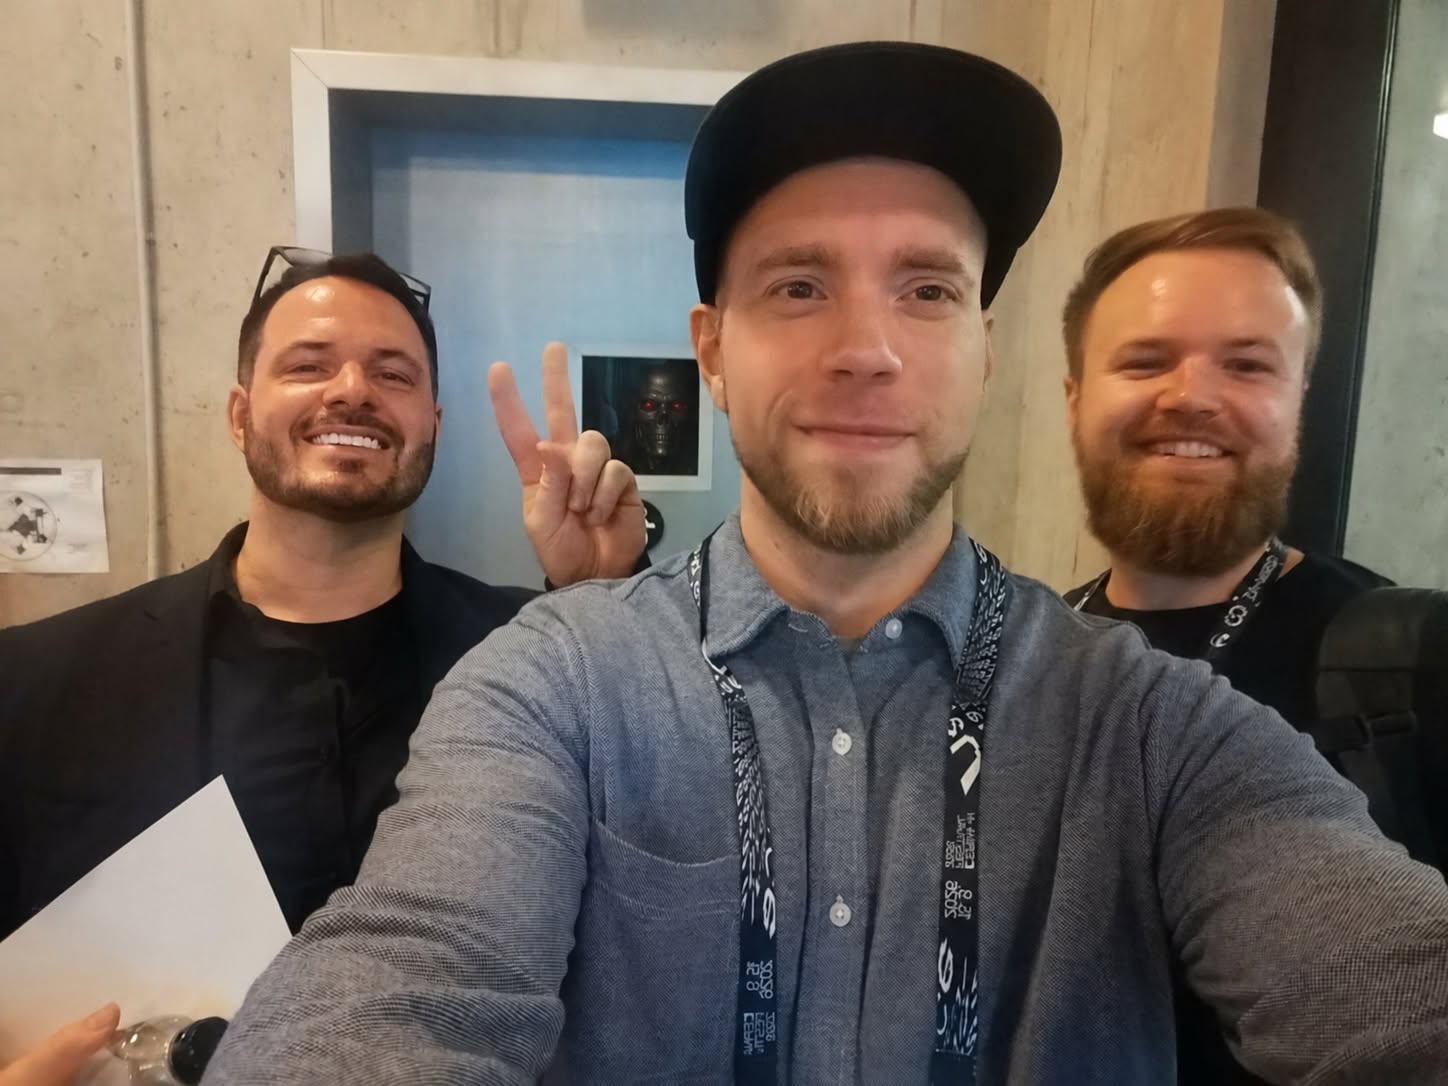
Von links Jan Tyl, Jakub Siwek und Filip Oborník.
We acknowledge EuroHPC JU for awarding the project ID EHPC-AIF-2026PG01-843 access to LUMI at CSC, Finland.
Haben Sie eine eigene Idee? Kontaktieren Sie das tschechische Team LUMI AI Factory in IT4Innovations unter ai-factory@it4i.cz. Ich habe selbst mit einem kleineren Projekt begonnen.
Und wenn Sie die Zusammenarbeit von Modellen direkt ausprobieren möchten, probieren Sie Hyperspace aus.
Datensätze und Materialien zur Replikation
Hier sind die Quellen von fünfzehn Aufgabentypen aus dem abschließenden Vergleich. Die Zahlen bezeichnen unterschiedliche Fragen, nicht die Anzahl der Antworten aller Modelle. Links führen zu Quelldatensätzen; ich habe nicht immer die gesamte aktuelle Version verwendet.
Hauptdatensatz: 2.544 Aufgaben
| Datensatz | Verwendeter Teil | Anzahl |
|---|---|---|
| GPQA | Diamond, zuvor unterteilt in 60 und 138 Fragen, gleiche Reihenfolge der Antwortmöglichkeiten | 198 |
| MATH-500 | Vollständiger Test | 500 |
| AIME 2024 und AIME 2025 | Festgehaltene Datensätze mit je 30 Aufgaben pro Jahr | 60 |
| IFEval | 541 Aufgaben, strenge Prüfung aller Anweisungen in der Antwort | 541 |
| HotpotQA | Benutzerdefinierte Auswahl aus der Variante distractor | 120 |
| LiveCodeBench | Festgehaltene Auswahl LCB-60 aus der Datei test6 | 60 |
| CERMAT: Tschechisch | Multiple-Choice-Probleme | 649 |
| CERMAT: Mathematik | Multiple-Choice-Probleme | 126 |
| MMLU auf Tschechisch | Fünf Fragen pro geladenem Fachgebiet, Seed 42; die gespeicherte Auswahl umfasst 290 Aufgaben | 290 |
In den strengen Router-Vergleich gingen 2.537 Aufgaben ein: Bei sieben IFEval-Aufgaben fehlten erforderliche Ausgaben. In dieser Haupttabelle ist der HotpotQA-Score eine exakte Übereinstimmung mit der Antwort; beim Experiment mit langem Kontext verwende ich F1. Dies sind keine austauschbaren Kennzahlen.
Neue Problemtypen: Set A8, 1455 Fragen
| Datensatz | Verwendeter Teil | Anzahl |
|---|---|---|
| BIG-Bench Hard | 15 Aufgaben aus jeder der 27 Konfigurationen | 405 |
| MMLU-Pro | Test, je 25 Aufgaben aus 14 Fachgebieten | 350 |
| Belebele | Test, tschechische Version ces_Latn | 200 |
| CzechBench Agree | Test der grammatischen Kongruenz | 150 |
| DROP | Auswahl aus dem Validierungssatz | 200 |
| Klokan QA | Test, Konfiguration balanced | 150 |
Das A8-Auswahlskript verwendet Seed 42. Auch die Reihenfolge beim Laden der Datensätze ist wichtig, sodass der Seed allein die Auswahl nicht vollständig spezifiziert.
Liste der Datensätze, ausgewählter Aufgaben-IDs und Prüfsummen (JSON) herunterladen
Die Datei enthält die Kennungen aller 3.999 Aufgaben in beiden Sätzen und SHA-256-Hashes der gespeicherten Eingabedateien. Außerdem werden Generierungseinstellungen aus dem Skript und Beispiele von Laufzeitversionen aus den Protokollen aufgeführt. Ich kopiere weder die Aufgaben noch die darin enthaltenen richtigen Antworten; Sie können sie von den Autoren der Datensätze zu deren Bedingungen erhalten. GPQA erfordert beispielsweise die Annahme von Zugangsbedingungen.
Für eine exakte Nachbildung des gesamten Experiments muss ich noch das komplette Paket veröffentlichen: Eingabeaufforderungen, genaue Modell- und Datensatzrevisionen, korrigierte Grenzwerte für einzelne Läufe, Bewertungsskripte und die vor der Auswertung festgelegten Routerregeln. Bei dieser Liste handelt es sich um eine erste konkrete Grundlage, nicht um den Anspruch, dass das gesamte Experiment bereits mit einem einzigen Befehl reproduzierbar sei.
Ich habe ThinkingCap anhand ausgewählter Beispiele von OpenR1-Math-220k und der eigenen Antworten des Originalmodells auf Eingabeaufforderungen von Mixture-of-Thoughts optimiert. Dies sind Trainingsquellen, getrennt von den oben genannten Bewertungssätzen.